语音与音频学术速递[9.11]

今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
21 0 0

今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
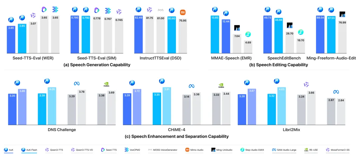
语音克隆、指令驱动语音合成、语音编辑、语音增强、语音分离...如果你最近关注过语音模型,这些能力大概率分散在多个不同的模型里。 而腾讯混元最新开源的 AuK,把生成和编辑这一整条能力链,塞进了一个统一框架,并通过少步蒸馏得到了推理加速版本…
随着AI音频处理工具不断向在线化发展,一些原本需要借助专业音频软件完成的任务,如人声分离、伴奏制作和音乐分轨,如今已经可以直接通过浏览器完成。Tunii近期推出了一系列基于浏览器的AI音频工具,面向人声分离、伴奏制作、音乐分轨以及视频音频处…
今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
语音交互和语音通信依赖清晰、可分辨的输入信号。真实环境中的风扇、道路、键盘等背景噪声会掩盖语音,扬声器回放进入麦克风会形成回声,多人同时讲话则会造成语音混叠。降噪、声学回声消除(AEC)和语音分离分别处理这三类问题,直接影响语音识别、唤醒与…
印度语音 AI 团队 Rumik 开源 Rumik-OSS 1,一款约 3B 参数的多语言 TTS 模型,支持 22 种语言、原生文字输入及语言混说,并可通过文字描述控制音色的情绪、口音和语速,同时在句子中插入笑声、轻笑和叹气等非语言声音。…
今日论文合集:CS.SD语音与音频 | 共 21 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 快速导航 1. 语音识别与关键词检测…
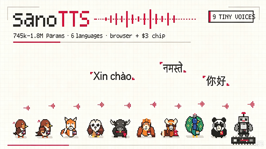
地址:https://tts.ampixa.com/sanoTTS/ 尼泊尔语音 AI 实验室 Ampixa Labs 开源超小型神经 TTS 模型家族 sanoTTS,模型规模覆盖 29.4 万至 227 万参数,包含 11 个声音、6…
AI与人的长期关系,需要在一次次交流中建立起来。 昨天聊过的内容,可以帮助AI理解今天的对话;今天的对话,也会成为它下一次回应的依据。 AGI Being所指向的,正是一种能够在长期相处中逐渐了解一个人的智能存在。 而在实时语音中,AI怎样…
在实时通信、语音交互和音频修复等场景中,语音超分辨率(Speech Super-Resolution, SR)技术扮演着重要角色——它能够从低采样率的语音信号中重建丢失的高频成分,从而提升语音的清晰度、自然度和可懂度。 然而,如何在极低延迟…
