不用出声也能聊天?苹果公开一项无声语音识别专利

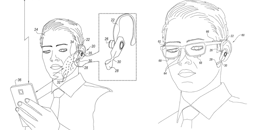
地铁里、会议室中、医院病房内——很多场合我们都需要“说点什么”,却又不便发出声音。 苹果公司近日公开了一项专利申请(WO2026159706A1),提出一种默声语音检测方案:用户在不发声的情况下靠面部肌肉运动“默念”,设备读取面颊皮肤微动后…
171 0 0

地铁里、会议室中、医院病房内——很多场合我们都需要“说点什么”,却又不便发出声音。 苹果公司近日公开了一项专利申请(WO2026159706A1),提出一种默声语音检测方案:用户在不发声的情况下靠面部肌肉运动“默念”,设备读取面颊皮肤微动后…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. MMAG: A Multi-Cont…
说话时不自觉地在中文里夹几句英文——"这个 project 的 deadline 快到了""帮我订一个 meeting room 讨论一下"——这种语言现象叫做"语码转换"(Code-Switching)。在全球化语境下,它已经成为日常交流…
论文标题:SALMONN-2: Advancing General-Purpose Hearing Abilities with Self-Supervised Representations 作者:Xiaoyu Yang\*, Xuena…
以 GPT-4o、Moshi、GLM-4-Voice、Qwen-Omni 为代表的端到端语音大模型(SLM)正在推动人机交互迈向“开口即对话”的新阶段。然而,在需要精确、结构化推理的场景下——尤其是口语数学问答——语音大模型的表现仍显著落后…
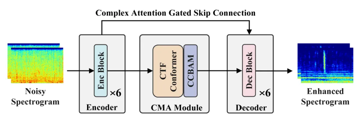
近日,中国科学技术大学联合科大讯飞研究院团队在期刊IEEE Open Journal of Signal Processing上发表一项成果,针对被动声呐在信噪比低至-15 dB至-5 dB的极低条件下船舶辐射信号提取困难的问题,提出全复值…
8月5日,字节发布原生音视频全双工大模型 SeedRealtime。 项目主页:https://seed.bytedance.com/seedrealtime 体验入口:将豆包 App 更新至最新版本,在对话框内选择“打电话”,进入视频通话…
2026年8月4日,全球知名开源多媒体框架FFmpeg正式发布了9.0版本。 这次发布,除了例行的性能跃升、新编解码器支持与硬件加速优化之外,最令中国音视频开发者动容的,是写在发布日志最前方的版本代号:“Lei”。 这个名字,来自中国音视频…