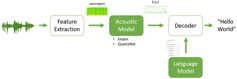
声学模型和语言模型融合的N种方式

语音识别算法目的是从声学特征x中找到最有可能生成的词序列y,即 完整的语音识别算法包括特征提取、声学模型、语言模型和解码,其中语言模型(Langulage Model, LM)负责计算词序列W={w1,…,wn} 的概率估计P(W)。并且语…
10 0 0

语音识别算法目的是从声学特征x中找到最有可能生成的词序列y,即 完整的语音识别算法包括特征提取、声学模型、语言模型和解码,其中语言模型(Langulage Model, LM)负责计算词序列W={w1,…,wn} 的概率估计P(W)。并且语…
来源丨AIGC开放社区 根据阿里公布的测试数据显示,32B指令微调模型在 EvalPlus、LiveCodeBench、Spide和Bird-SQL的测试中,成为开源模型中性能排名第一,超过GPT-4o、Claude 3.5 Sonnet两…
来源丨量子位 刚刚,谷歌开源了自己的诺奖模型AlphaFold3!至此来自生物医药、生命科学等各个领域的科学家们都可以免费下载模型代码,自行运行模型开展工作。 此举直接获得了Nature亲自撰文推荐。 GitHub链接:https://gi…
来源丨DrugAI、机器人的脑电波 今天为大家介绍的是来自上海交通大学的王延峰与谢伟迪团队的一篇论文。开源的多语言医学语言模型的发展可以惠及来自不同地区、语言多样化的广泛受众。 论文:https://www.nature.com/artic…
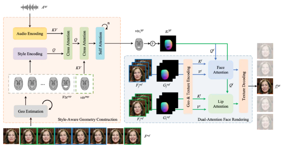
字节发布的PersonaTalk模型,可精准给视频进行AI配音的。该方案能不受原视频质量的影响,保障生成视频质量的同时兼顾 zero-shot 技术的便捷和稳定,可以通过非常便捷高效的方式用语音修改视频中人物的口型,完成高质量视频编辑,快速…
来源丨新智元 最近,来自上海大学、山东大学和埃默里大学等机构的研究人员首次提出了文本边图的数据集与基准,包括9个覆盖4个领域的大规模文本边图数据集,以及一套标准化的文本边图研究范式。该研究的发表极大促进了文本边图图表示学习的研究,有利于自然…
来源丨机器之心 随着人工智能技术的快速发展,大型语言模型(LLMs)在自然语言处理、计算机视觉和科学任务等领域取得了显著进展。然而,随着模型规模的扩大,如何在保持高性能的同时优化资源消耗成为关键挑战。为了应对这一挑战,腾讯混元团队率先采用混…
来源丨新智元 CGPO框架通过混合评审机制和约束优化器,有效解决了RLHF在多任务学习中的奖励欺骗和多目标优化问题,显著提升了语言模型在多任务环境中的表现。CGPO的设计为未来多任务学习提供了新的优化路径,有望进一步提升大型语言模型的效能和…