Show and Tell Demo: Call for Proposals

The ICASSP 2022 organization committee is soliciting proposals for a Show & Tell Demo event that will be held during the…
214 1 0

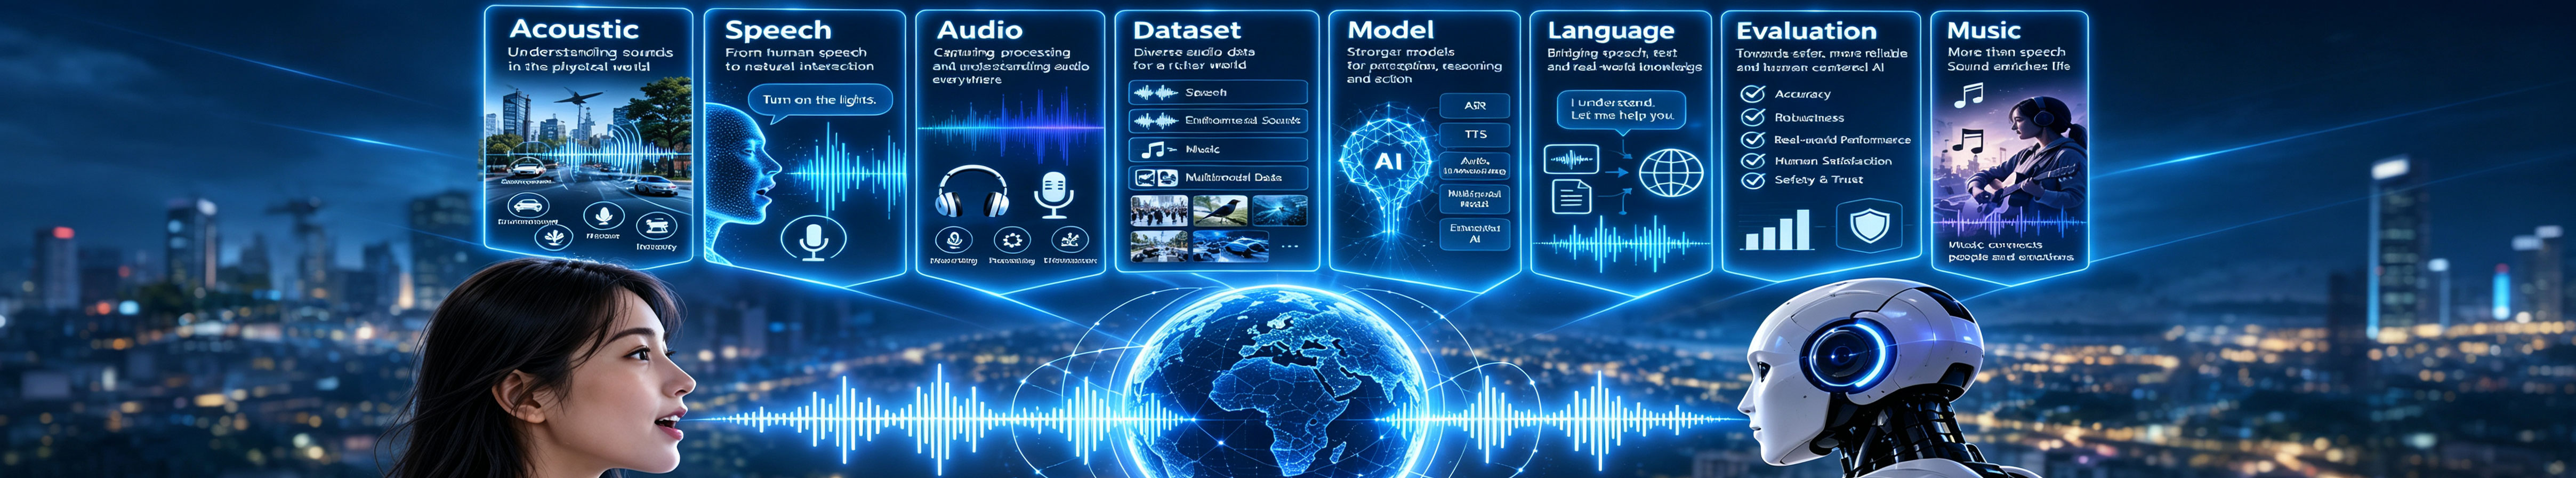
The ICASSP 2022 organization committee is soliciting proposals for a Show & Tell Demo event that will be held during the…
由CCF语音对话与听觉专委会 、中国人工智能产业发展联盟(AIIA)评估组 、北京声智科技有限公司、语音之家社区、北京希尔贝壳科技有限公司共同主办的【语音之家】AI产业沙龙-站在未来思考下一代人工智能基础框架,将于2021年11月6日10:…
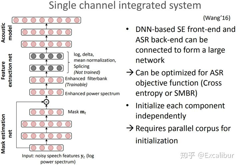
原场语音识别(Distant ASR) 原场语音识别中的挑战 混响 背景噪声 其他说话人的插入、打断等 远场语音识别系统 主要有这几个模块构成: 语音增强前端 特征提取 模型自适应 解码器 声学模型 字典 语言模型
本期开源发布为 [天下足球] 场景,测试集ID: SPEECHIO_ASR_ZH00003 获取方式: 平台:Linux / MacOS Step 1获取 leaderboard 代码仓库: 初次获取: git clone https://…
声明:平时看些文章做些笔记分享出来,文章中难免存在错误的地方,还望大家海涵。搜集一些资料,方便查阅学习:http://yqli.tech/page/speech.html 语音合成领域论文列表请访问http://yqli.tech/page…
一、算法 Speaker recognition以2012年为分水岭,由statistics-based machine learning,跨到了以deep learning为主线的算法。随后,bottleneck feature、d-ve…
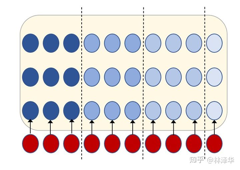
流式语音识别模型(Streaming ASR Model)是指可以在处理音频流的过程中,支持实时返回识别结果的一类 ASR 模型。与之相对的是非流式模型,它必须在处理完整句音频后才能返回结果。流式 ASR 可以更好地用于需要实时获取识别结果…
由CCF语音对话与听觉专委会 、中国人工智能产业发展联盟(AIIA)评估组 、语音之家(北京)科技有限公司、北京希尔贝壳科技有限公司共同主办的【语音之家】AI产业沙龙-智能对话平台,将于2021年11月8日14:20通过语音之家微信视频号直…
音频的模式识别包括了几个主干任务如音频标注(audio tagging)、声学场景分类(acoustic scene classification)、和声音事件检测(sound event detection)。本文主要通过几篇论文的研究[…