FastSpeech语音合成系统技术升级,微软联合浙大提出FastSpeech 2

基于深度学习的端到端语音合成技术进展显著,但经典自回归模型存在生成速度慢、稳定性和可控性差的问题。 去年,微软亚洲研究院和微软 Azure 语音团队联合浙江大学提出了快速、鲁棒、可控的语音合成系统 FastSpeech,近日研究团队又将该技…
16 0 0

基于深度学习的端到端语音合成技术进展显著,但经典自回归模型存在生成速度慢、稳定性和可控性差的问题。 去年,微软亚洲研究院和微软 Azure 语音团队联合浙江大学提出了快速、鲁棒、可控的语音合成系统 FastSpeech,近日研究团队又将该技…
单音子模型的假设是一个音素的实际发音与其左右的音素无关。这个假设与实际并不符合。由于单音子模型过于简单,识别结果不能达到最好,因此需要继续优化升级。就此引入多音子的模型。最为熟悉的就是三音子模型,即上下文相关的声学模型。以kaldi的thc…
高仿真的音频合成需要处理高采样率的音频数据,尤其是歌唱合成。相对于使用16kHz和24kHz的音频,使用48kHz的音频将会覆盖更宽的频带和更长的音频序列,这将给音频合成造成极大的挑战。本文针对使用48kHz音频带来的问题,提出了HiFiS…
WACV 2021的录用论文Visual Speech Enhancement Without A Real Visual Stream。该文研究涉及计算机视觉与语音处理的交叉。 论文信息
在刚刚结束的NIST OPENASR评测中,TEG AI语音联合清华大学,刷新世界小语种语音识别比赛6项第一。从2000年开始,NIST组织的RT(英文语音识别),LRE(语音语种识别),SRE(语音说话人识别),OPENKWS(语音关键词…
PyTorch + Kaldi,腾讯 AI Lab 开源轻量级语音处理工具包 PIKA,专注于端到端语音识别任务。 Kaldi 是一个开源的语音识别系统,由 Daniel Povey 主导开发,在很多语音识别测试和应用中广泛使用。但它依赖大…
2016 年,深度学习和深度神经网络的突破使得智能语音识别的准确率第一次达到了人类水平,也促使智能语音技术进入到落地阶段。尤其是近几年,语音识别技术逐渐走向成熟,在万物互联趋势下,智能语音技术在教育、金融等各个行业落地日益深入。2020 年…
构建了HCLG解码图后,解码就是在这个图上寻找一条最优路径。最优路径上去除epsilon后的输出标签序列就是单词级别的识别结果。本篇主要解析kaldi源码实现。 解码 decode.sh 源码解析:
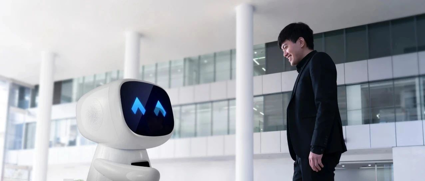
近年来服务机器人逐渐进入商场、银行、机场等场所,但多数服务机器人仅能被动响应用户的请求,且使用和交互的频率非常低,也就成为了“移动平板电脑”。 为此,百度的工程师们率先在小度机器人(DuRobot)上开展了一项技术革新。小度机器人落地于百度…