
 语音小管家
做过实时语音识别的人,大概率都见过这样一种场景:
你刚说完半句话,屏幕上的字幕已经出来了,但再多说几个字,前面的内容突然被改掉。字幕一会儿增加、一会儿回滚,甚至整句话重新刷新。如果只是看字幕,这可能只是“有点闪”。但当ASR的输出开始直接连接翻译模型、LLM、Voice Agent甚至执行工作流时,问题就没那么简单了。
已经交给下游模型的文字,还能不能改?
这是实时ASR正在遇到的一个越来越重要的问题。
近日,网易有道开源了一个针对这个问题设计的流式语音识别模型——Confucius4-R2T2。R2T2 全称 Real Real-Time Transcription。它想解决的核心问题,可以浓缩成两句话:
- 最低80ms音频chunk即可进行流式解码。
- 已经输出的文字,只增不改。
在160ms配置下,R2T2已经能够在较低延迟下保持较高识别准确率;根据官方公布的测试结果,其平均延迟大约可以控制在200~600ms范围。
更值得注意的是,它不是简单把一个离线ASR模型“切成更小的chunk”。
R2T2试图让模型自己学会判断:
什么时候我已经听懂了,可以把这几个字真正交出去;什么时候信息还不够,应该再等一等。
这可能也是这套技术最值得关注的地方。
也就是:一旦输出,就意味着模型确认了这段内容,后面不会再修改。R2T2把这种机制称为 Stable Prefix——稳定前缀,这也是它所谓“True Streaming”的核心。
⏩R2T2怎么做到“只增不改”?
从架构上看,R2T2并没有设计一套非常复杂的新系统。它建立在 Qwen3-ASR 基座模型之上,整体依然可以理解为:
Audio Encoder + Autoregressive LLM Decoder。
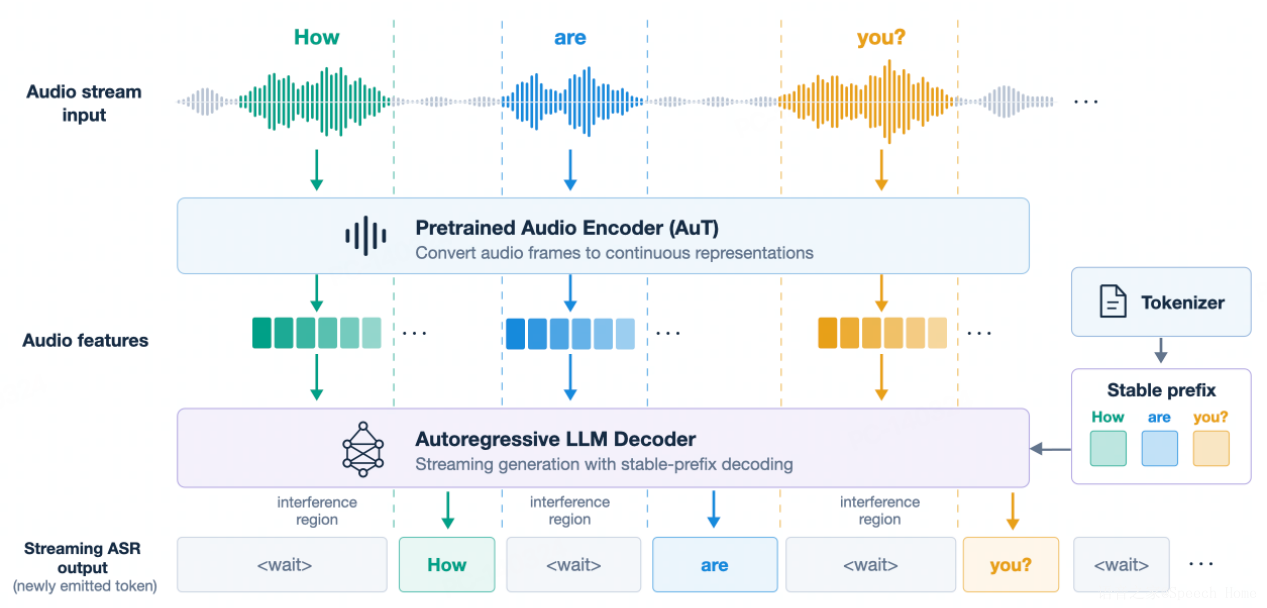
音频流首先进入预训练Audio Encoder,被转化为连续的音频表示,随后,自回归LLM Decoder持续接收这些特征,并生成文字token。
但真正关键的是解码阶段。R2T2在流式生成过程中,不会要求模型每一次都必须吐出文字。相反,它允许两种行为:
Commit,或者Wait。
听懂了,就 Commit,
没听懂,就:<wait>
再听一小段。
因此在图中的音频持续输入过程中,可以看到类似这样的过程:
<wait> → How → <wait> → are → <wait> → you?
这里最大的区别在于:一旦“How”已经被提交,后面模型就不能再把它改成别的词,然后“are”进入Stable Prefix,再然后是“you”。于是稳定前缀会不断增长:
How
How are
How are you?
只向右增加,不向左修改,这其实改变了传统流式ASR的一种思路,以前更多是在问:
“现在能不能猜一个结果出来?”
R2T2问的是:
“现在有没有足够的信息,让我对这个结果负责?”
⏩关键是让模型学会“什么时候该说话”
把音频切成160ms,本身并不难。真正的问题在于:
160ms的信息通常远远不够。
如果每160ms都强制ASR输出一个token,识别质量很容易崩掉。因此,R2T2并不是简单的固定chunk → 固定输出。
它采用了一套针对Stable Prefix构造的训练方法,官方目前披露了三类数据构造方式:
- Stable-prefix data
- Forced time-alignment data
- Token-level audio segmentation
同时引入了一套Longest Stable Prefix(LSP)learning paradigm,简单理解:
模型不仅需要学会“这段语音说了什么”,还要额外学习一件事:
当前这段音频里,有多少内容已经可以被确定?
因此,模型会动态判断Stable Prefix。对于已经具有足够上下文的信息,就提交。对于仍然存在歧义的部分,就继续等待后续语音。这也解释了为什么R2T2能够同时做到两件看起来有点矛盾的事情:
chunk很小,但并不意味着每个chunk都必须输出。
换句话说:
80ms/160ms决定的是“模型多久可以做一次判断”,而不是“模型每80ms必须说一次话”。
这是理解R2T2低延迟机制比较关键的一点。
⏩160ms下,开源真流式ASR能做到什么水平?
真正值得关注的还是Benchmark。官方分别测试了英文WER和中文CER,并将参测系统分成了两类:
- True Streaming:即输出以后不可修改,Stable Prefix只增不改。
- Pseudo-streaming:系统虽然可以持续返回文字,但后续结果仍可能修改此前已经出现的内容。
这两个类别其实不能完全直接横向比较,因为允许“反悔”的系统天然拥有更多优化空间,这一点在看下面数据的时候非常重要。
英文:WER最低6.13
在160ms配置下,R2T2提供了两种具有代表性的工作模式。
- Quality Priority:WER:6.13平均回溯chunk延迟约:0.55s
- Latency Priority:WER:7.13平均延迟约:0.21s
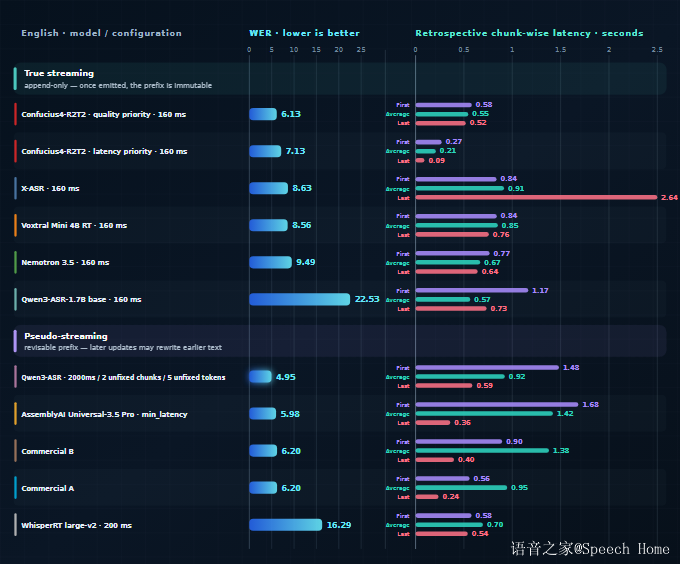
这个结果比较有意思。如果更偏向识别质量,可以选择大约500ms级别的延迟;如果应用对响应速度极其敏感,则可以将延迟进一步压到200ms级别,同时牺牲一部分WER。
也就是说,R2T2并没有把“延迟”设定成一个固定数字,而是开放出一个Accuracy-Latency Trade-off。开发者可以根据应用自己选择。
例如:会议转写可能更在意识别质量;而Voice Agent则可能更看重第一时间得到稳定输入。
⏩中文场景,差距更加明显
在中文测试中,R2T2同样使用160ms输入chunk。
Quality Priority模式的CER是 6.42,Latency Priority模式为 7.10。
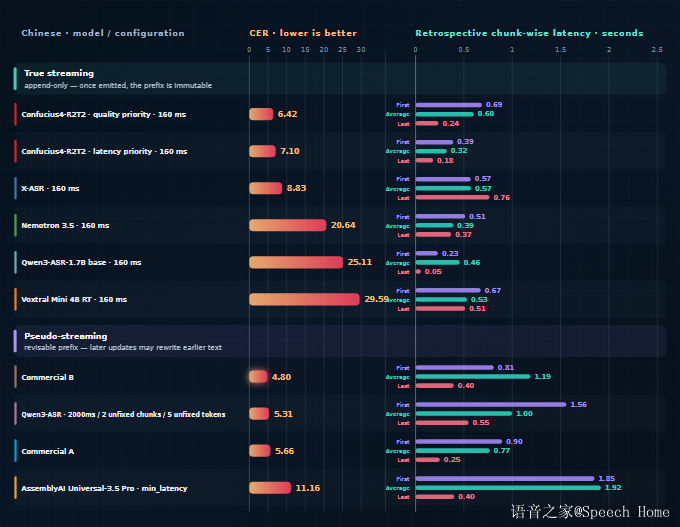
作为对比,在官方测试中的部分开源True Streaming方案,在相同或接近的160ms配置下,中文CER分别达到8.83、20.64、25.11甚至更高。
在所测试的开源True Streaming模型中,R2T2处在比较明显的Accuracy-Latency Pareto Frontier位置。
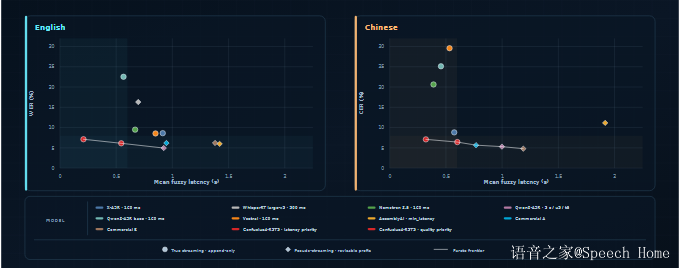
当然,这里还需要强调一个Benchmark阅读上的细节。一些商业ASR和Pseudo-streaming方案的CER仍然可以做到更低。
例如测试中的部分商业系统达到4.x~5.x CER。但这些系统允许修改已经显示的文本,因此与R2T2解决的是不同约束下的问题。
所以R2T2这次真正想证明的是:
在“低延迟 + 输出不可修改”这个更严格的约束下,准确率还能做到什么程度?
⏩80ms到2秒,延迟可以自己调
R2T2目前支持的Streaming Chunk范围是:80ms~2s。这也意味着开发者不需要所有场景都使用160ms。不同产品可以选择不同的Latency / Accuracy平衡。比如:
- Voice Agent:可能更倾向80~160ms,让系统尽早获得用户输入。
- Live Caption:可以使用160~320ms,在字幕稳定性和准确率之间做平衡。
- Meeting Transcription:则可以适当增加 chunk,用更高延迟换取识别质量。
这其实也是目前实时语音系统越来越明显的一个趋势:
“实时”已经不再只是一个固定参数。而是一个可以根据业务需求调节的系统变量。
⏩除了Streaming,它还是一个完整可用的ASR模型
除了Stable Prefix之外,R2T2此次开源还有几个值得开发者关注的工程能力。首先是 vLLM backend。模型提供基于vLLM的推理后端,同时也提供Hugging Face transformers backend。
另外还原生支持:
Context Prompt和Hotword Prompt。
对于人名、公司名、产品名、专业术语比较多的实际业务场景,这一点非常实用。语言方面,目前模型重点针对:
中文和英文
进行了优化,同时也支持更多语言。还有一个容易被忽略的特点:Streaming能力没有以牺牲Offline能力为代价。
官方表示,加入流式识别能力以后,模型的Offline Recognition Accuracy并没有出现损失。换句话说,同一套模型可以同时承担Offline和Real-time Streaming ASR任务。
对于真正部署语音服务的开发者而言,这一点的实际价值可能比单独一个Benchmark数字更大。
⏩ASR的竞争,正在从“听得准”走向“什么时候敢把答案交出去”
过去讨论ASR,最常见的两个指标就是:WER,以及RTF。
准确率高不高?推理速度快不快?
但当ASR开始进入实时字幕、实时翻译和Voice Agent之后,评价一个语音识别系统可能需要增加第三个维度:
模型什么时候能够确定自己听对了?
因为一个200ms吐出来、随后又被改掉的token,和一个500ms以后输出、但从此不会改变的token,对于下游Agent来说完全不是一回事。
从这个意义上说,R2T2这次比较有意思的地方,并不只是把chunk做到了80ms。而是把一个过去经常被UI层掩盖的问题摆到了台面上:
Streaming ASR不仅要解决“多快能看到文字”,还要解决“多快能得到可信的文字”。
R2T2给出的答案是:
让模型学会Wait,也让模型学会Commit。
当一个token真正从模型里出来的时候,它就不再只是一个“当前猜测”。而是一个可以直接交给下游Agent继续工作的Stable Prefix。对于正在快速发展的实时语音交互来说,这可能比单纯再降几个点的WER,更值得关注。
项目名称:Confucius4-R2T2
核心特性:
- True Streaming ASR
- 80ms~2s可配置Chunk
- Stable Prefix,只增不改
- 约200~600ms平均延迟
- 中文、英文重点优化
- vLLM / Transformers推理
- Context Prompt / Hotword
- Offline + Streaming统一模型
目前模型、推理代码以及最小运行示例均已开源,后续官方还将发布关于Longest Stable Prefix学习机制的Technical Report。
⏩开源地址
