语音小管家
近日,EMNLP 2026正式公布录用结果,本期分享阿里 Token Foundry Qwen Audio 团队中稿的 3 篇论文,涵盖视频到音频生成、大语言模型推理增强、神经编解码语音合成三大前沿方向。
本次入选的 3 篇论文分别围绕跨模态音频生成、长链推理过程监督和神经编解码语音生成展开探索:MosaicAudio 通过多教师在策略蒸馏,兼顾视频到音频生成中的语义、时间、听感与空间一致性;ConsensusBench 从模型回答中提取可验证的共识节点,为长链推理提供更稠密的过程监督;MNCE 则从神经音频编解码器的码本空间出发,将近邻 token 纳入训练目标,进一步提升语音生成质量。
01
论文题目:MosaicAudio: Multi-Teacher On-Policy Distillation for Controllable Video-to-Audio Generation
论文作者:Huadai Liu, Peiwen Sun, Qian Chen, Wen Wang, Bin Ma, Xiangang Li, Wei Xue
论文单位:阿里巴巴集团、香港科技大学、香港中文大学
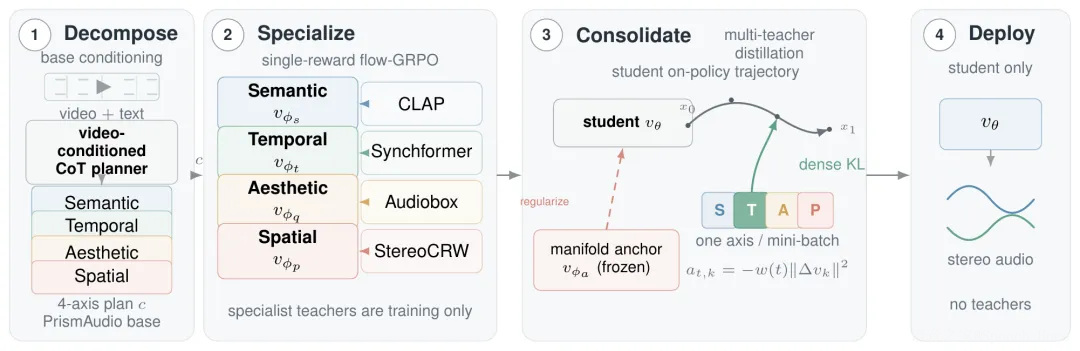
核心内容: MosaicAudio 面向可控视频到音频(V2A)生成,旨在让同一段音频同时满足语义一致、时间同步、听感自然和空间定位四个目标。针对聚合标量奖励难以定位具体失败维度、不同感知目标易相互干扰的问题,MosaicAudio 分别训练语义、时间、美学和空间四个流匹配专家教师,并通过多教师在策略蒸馏,将按维度路由的稠密速度场监督整合到单一学生模型;同时引入感知流形锚点以保持音质、抑制奖励投机。在 VGGSound 与域外 AudioCanvas 基准上,该方法在四类客观指标和人工评分上均达到对比系统中的领先水平,且推理时仅需部署单一 518M 参数学生模型,无需教师或奖励模型。
02
论文题目:ConsensusBench: Benchmark of Consensus Nodes for LLM Reasoning via Outcome Reward Densifying
论文作者:Shi-Qi Yan, Chao-Hong Tan, Qian Chen, Wen Wang, Xiangang Li, Zhen-Hua Ling
论文单位:阿里巴巴集团
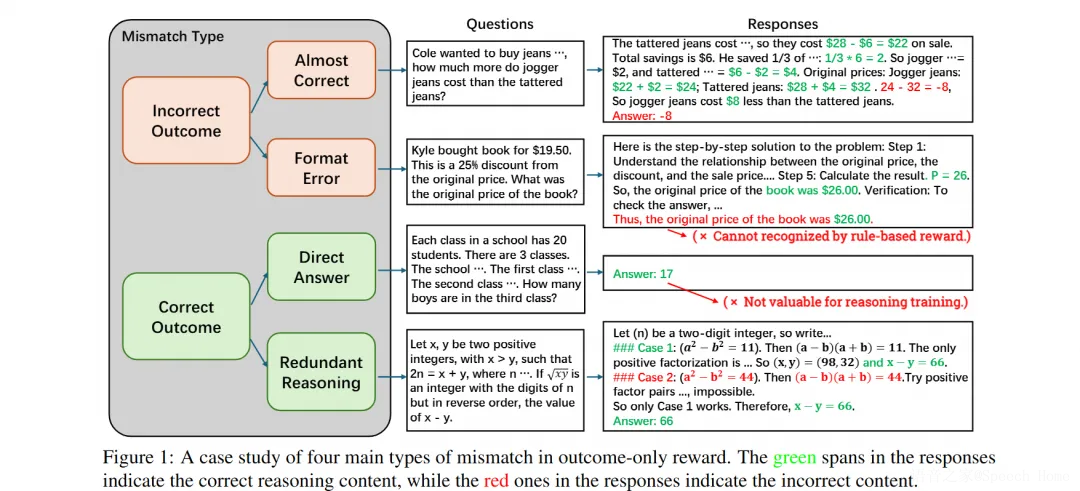
核心内容: 以 GRPO 为代表的基于结果的强化学习(outcome-based RL)在增强大语言模型(LLM)推理能力方面表现出色,已成为主要范式之一。然而,这类方法仅依赖于最终答案,缺少对于中间过程质量的反馈,导致结果奖励与局部过程质量不匹配,使其在复杂长推理任务上表现有限。针对这一问题,我们设计了数据集 ConsensusBench,通过不同模型回答的共识聚类,自动化抽取关键的过程节点,来提供基于规则的过程监督信号,实现对模型思考质量的监督与评估。实验结果表明,融合了该过程奖励的 LLM 在多个推理任务评估结果上得到了一致的提升,展示了思考过程的质量控制对于 LLM 推理能力进一步提升的有效性,也验证了我们构建的过程数据的可靠性。
论文链接:https://arxiv.org/abs/2609.04648
03
论文题目:Improving Speech Generation via Multi-Neighbor Token Prediction for Neural Codec Language Models
论文作者:Wenrui Liu, Qian Chen, Wen Wang, Yuxuan Wang, Haoxiang Wu, Guanrou Yang, Rui-Chen Zheng, Weiqin Li, Guo Tao, Xiangang Li, Zemin Liu
论文单位:浙江大学、阿里巴巴集团、上海交通大学
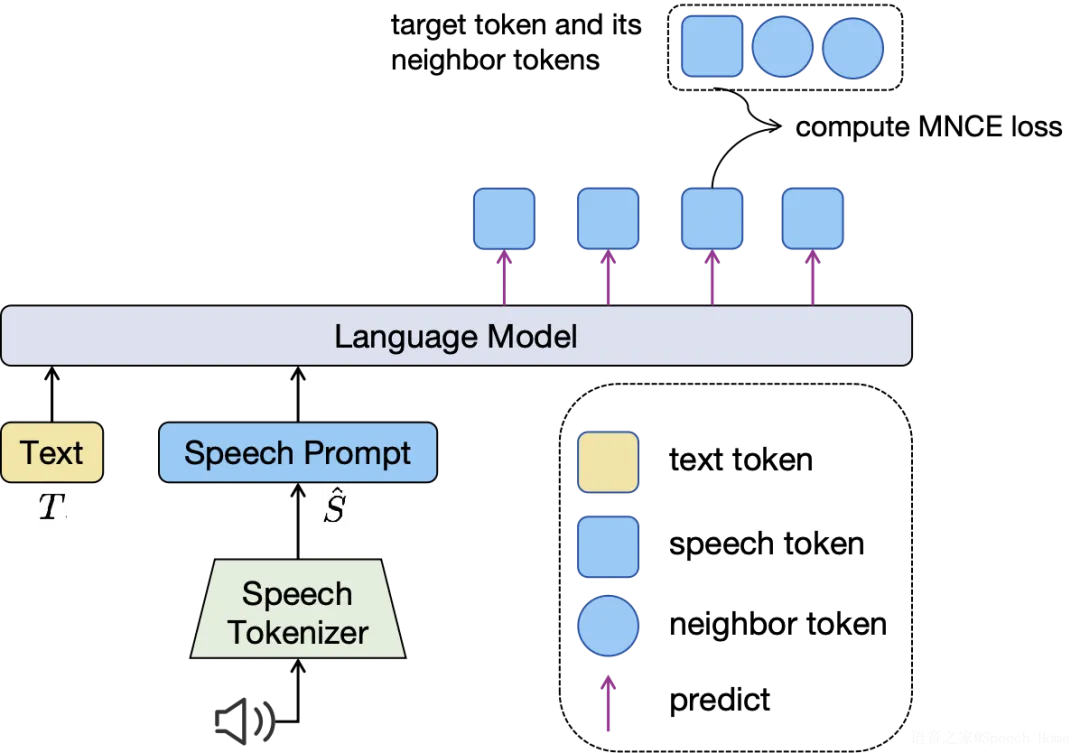
核心内容:在基于神经编解码器的 TTS 系统中,现有方法通常将 target token 视为唯一正确的 token,采用标准交叉熵损失训练模型。本文观察到,当用码本空间中的近邻 token 替换目标 token 时,重建得到的音频在听感上仍与原始语音保持较高相似性。基于这一点,本文提出多邻居交叉熵损失(Multi-Neighbor Cross-Entropy, MNCE),在训练时不仅将真实 token 作为目标,还将其若干近邻 token 也视为正样本。这样在推理时,即使模型没有预测到 target token,也更有可能生成其邻近 token,从而减少不合理预测带来的语音质量损失。实验结果表明,MNCE 可以稳定提升多种 codec-based TTS 系统的生成质量,改善词错误率和说话人相似度。