
 语音小管家
中文语音交互不仅需要处理普通话,也需要面对丰富的地域方言。对于一段方言语音,系统既要判断“说的是哪种方言”,也要准确识别“说了什么”。然而,现有研究采用的方言类别、训练资源和测试集并不统一,系统性能难以直接比较。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)联合南京大学、南洋理工大学、北京慧听科技有限公司,在第21届全国人机语音通讯学术会议(NCMMSC 2026)上成功举办中文多方言语音识别挑战赛(ChinaVoices Challenge 2026)。赛事吸引了来自学术界和工业界的众多团队参与,充分体现了多方言语音识别在智能语音交互领域的研究热度与重要价值。
近日,赛事总结论文“Summary of the ChinaVoices Challenge 2026: Data, Tasks, Baseline, and Methods”已被 NCMMSC 2026 正式录用。论文系统总结了 ChinaVoices Challenge 2026 的数据资源、评测任务、基线系统以及参赛队伍的代表性技术方案,为中文多方言语音识别与处理研究提供了极具价值的技术参考。
论文题目:Summary of the ChinaVoices Challenge 2026: Data, Tasks, Baseline, and Methods
作者列表:廖育杰、穆秉甡、王水源、薛浏蒙、刘和鑫、石宪、胡捷、谢磊
合作单位:南京大学、南洋理工大学、北京慧听科技有限公司
录用会议:NCMMSC 2026
论文预印版:https://arxiv.org/abs/2609.03471
竞赛官网:https://aslp-lab.github.io/ChinaVoices-Challenge/
开源代码:https://github.com/ASLP-lab/ChinaVoices-Challenge
背景动机
中文方言在语音、词汇和表达习惯上存在明显差异。与普通话相比,部分方言的公开训练数据较少,数据来源和转写规范也不尽相同。KeSpeech[1]、WenetSpeech-Yue[2]等公开资源拓展了中文方言语音研究的数据基础,但现有公开测试集仍只覆盖部分方言,许多地域方言缺少共同、公开的评测数据。
这使得多方言系统的比较面临两个问题:一方面,不同研究选择的方言类别和测试语音不同,难以直接对比;另一方面,各系统使用的公开数据、内部数据和预训练模型不同,性能差异也可能来自资源条件。因此,需要在统一的任务定义、评测数据和资源规则下,考察模型处理多方言语音的能力。
ChinaVoices Challenge 2026 围绕多方言种类识别与多方言语音识别建立统一评测平台。 两项任务共享评测音频,使研究者能够分别分析方言类别判断与内容转写能力,并进一步观察二者在不同方言上的表现关系。
竞赛推文
ChinaVoices Challenge 中文多方言语音识别挑战赛结果正式揭晓
ChinaVoices Challenge 中文多方言语音识别挑战赛结果正式揭晓
挑战赛设置
挑战赛覆盖安徽、粤语、长沙、潮汕、东北、河南、客家、闽南、南昌、南京、山西、陕西、山东、四川、武汉和吴语等16类方言,设置两项任务:
- 多方言种类识别:输出一个方言标签,采用16类方言的宏平均准确率(ACC)评测,数值越高越好。
- 多方言语音识别:将语音转写为文本,采用16类方言的宏平均字错误率(CER)评测,数值越低越好。
每项任务均包含限定数据赛道和开放数据赛道。限定数据赛道仅允许使用官方数据和规定范围内的公开资源,用于确定正式排名;开放数据赛道允许使用合法的内部或自建数据,用于探索更广泛资源条件下的系统性能。
竞赛语音数据被划分为参考集、公开评测集和隐藏评测集,每类方言分别约有3小时、7小时和10小时,数据由北京慧听科技有限公司提供。三个集合的说话人严格互斥。公开评测集用于排行榜评分,隐藏评测集用于对领先的限定数据系统进行合规复核和独立验证。
统一基线
挑战赛基于 Qwen3-ASR-1.7B[3]构建统一基线。模型依次生成方言标签和转写文本,一次生成即可支持两项任务。训练时冻结音频编码器和音频—文本对齐模块,使用 LoRA[4]适配语言模型。在公开评测集上,基线取得 53.62% ACC 和 18.10% CER,相关数据清单、训练配置和复现脚本均已开源。
基线系统链接:https://github.com/ASLP-lab/ChinaVoices-Challenge
实验结果与分析
本次挑战赛共有28支队伍提交排行榜结果,17支队伍提交系统报告。经过参赛资格、数据使用、系统说明和结果有效性审核,15支合规队伍的系统被纳入总结分析。
整体结果与隐藏集复核
在限定数据的方言种类识别任务中,8个合规参赛系统均超过统一基线。如表1所示,scy919、Optima 和 zenava.ai 位列正式排名前三,在公开评测集上的 ACC 分别为83.19%、78.47%和73.42%。其中,scy919 相比基线提升了 29.57个百分点。
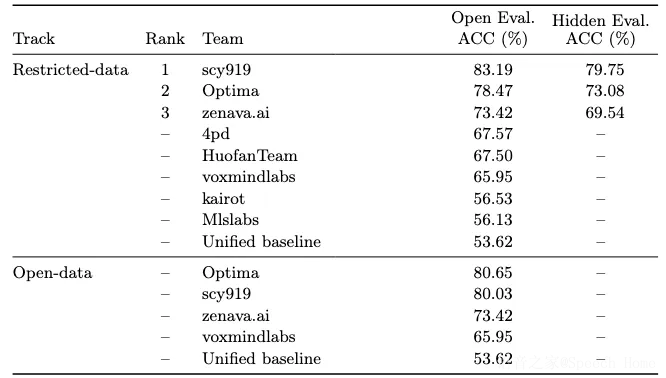
表1 多方言种类识别排行榜,ACC越高越好
在限定数据的语音识别任务中,11个合规参赛系统中有9个超过基线。如表2所示,TeleASR、Mlslabs 和 Kyoto-Tsinghua Team 位列前三,公开评测集 CER 分别为11.08%、11.22%和11.75%。TeleASR 相比基线将 CER 降低了7.02个百分点,相对错误率下降38.80%。
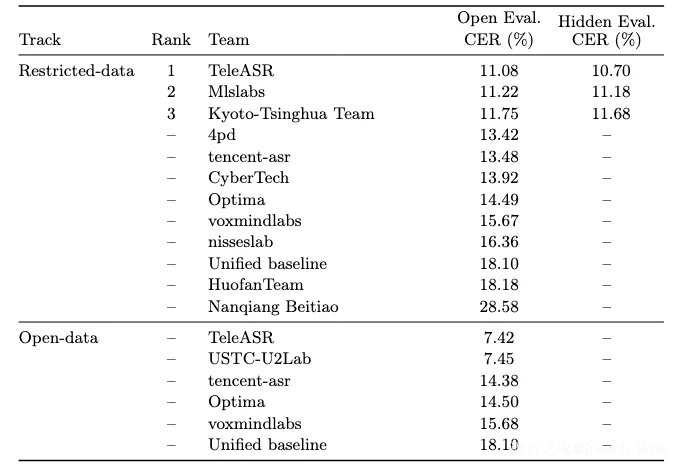
表2 多方言语音识别排行榜,CER越低越好
两项任务的正式前三名在隐藏评测集上均保持了相同顺序。 方言种类识别前三名的隐藏集 ACC 分别为79.75%、73.08%和69.54%;语音识别前三名的隐藏集 CER 分别为10.70%、11.18%和11.68%。这一结果表明领先系统的排名在独立评测中具有较好的稳定性。
哪些方言更难识别
论文分别对两项任务的限定数据前三名系统取逐方言平均。在方言种类识别中,东北、粤语和陕西的平均 ACC 分别为99.48%、98.62%和95.56%,表现较好;客家最为困难,平均 ACC 仅为43.25%。在语音识别中,客家同样最难,平均 CER 为31.01%;潮汕、山西、吴语和闽南也具有较高的错误率。
为了进一步观察方言种类识别的错误方向,论文对前三名系统的混淆矩阵进行逐行归一化并取平均。如图1所示,错误集中在部分方言之间,且往往具有方向性。例如,闽南被误判为潮汕的平均比例为19.90%,反向误判比例为12.73%;长沙被误判为武汉的比例为18.55%,反向仅为6.34%。客家还经常被误判为南昌或潮汕,错误并不只集中于某一个类别。
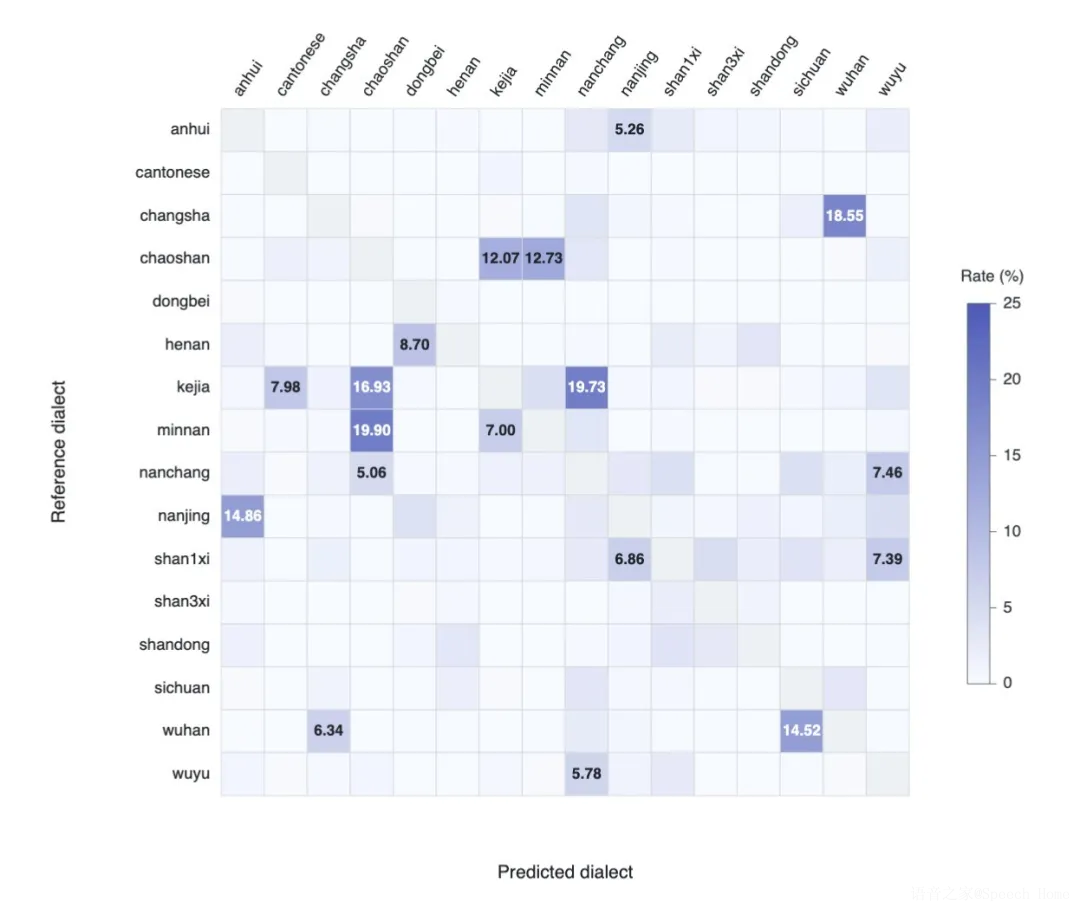
图1 限定数据赛道方言种类识别前三名系统的平均行归一化混淆矩阵。横轴为预测类别,纵轴为真实类别;对角线已隐藏,仅标注不低于5%的非对角线数值。
这些现象提示,错误可能同时受到方言间声学相似性、类别内部差异、训练覆盖和模型决策边界的影响。对困难方言的改进可以重点关注易混淆类别间的区分,而不能仅依赖各类别训练数据的均匀扩充。
语音识别的错误分析还发现,替换错误占前三名系统全部编辑错误的82.80%—87.30%,是主要错误来源。不同系统的删除错误也存在差异,说明相近的总体 CER 可能对应不同的错误组成。困难方言的发音与词汇覆盖、跨语料转写规范以及声学和文本的对齐,仍是值得关注的方向。
种类识别与转写能力有什么关系
基于两项任务各自前三名系统在16类方言上的平均结果,论文发现方言种类识别 ACC 与语音识别 CER 存在较强负相关,Pearson 相关系数为−0.76,Spearman 相关系数为−0.74。整体而言,类别越容易判断的方言,其内容转写错误率往往也越低。客家、潮汕、闽南和山西在两项任务中均较困难,东北和陕西则相对容易。
但这一关系并不适用于所有方言。吴语的平均 ACC 达到87.57%,平均 CER 仍为17.37%,表现为种类容易识别、内容较难转写;南京的平均 ACC 为67.08%,CER 却仅为7.36%。这说明,能够捕捉方言身份线索,并不意味着已充分掌握该方言的发音与词汇知识。
这里的相关性来自不同系统的方言级统计,不代表提高种类识别准确率就一定能降低转写错误率。两项任务需要独立评测,方言信息可以作为语音识别的补充,但不能替代对转写性能的直接检验。
领先系统方法
方言种类识别前三名采用了不同路线:scy919 结合 FireRedLID[5]和 Dolphin-CN-Dialect[6]提取互补特征,并使用 TabPFN[7]完成分类;Optima 融合 FireRedLID 多层特征和多个辅助训练目标;zenava.ai 则通过 LoRA 适配 Qwen3-Omni,将任务转化为生成式类别预测。高排名系统普遍重视方言判别性表示和多层声学信息,而模型规模并不能单独决定最终性能。
语音识别前三名均采用 FireRedASR2-AED[5]作为基础模型。TeleASR 侧重转写规范化、上下文拼接和数据增强;Mlslabs 采用 AED–CTC 联合训练[8]与困难方言过采样;Kyoto-Tsinghua Team 使用辅助 CTC、分层学习率和语音转换增强。结果表明,除基础模型外,数据处理、困难方言采样和声学—文本对齐同样关键。
总结
ChinaVoices Challenge 2026 为16类中文方言建立了覆盖种类识别与语音识别的统一评测平台。挑战赛不仅给出了可复现基线和正式排行榜,也揭示了不同方言的难度差异、典型混淆关系,以及方言种类识别与内容转写之间的联系。相关数据配置、基线代码和评测脚本均已开源,可为中文多方言语音技术的研究与比较提供参考。
参考文献
[1] Zhiyuan Tang, Dong Wang, Yanguang Xu, Jianwei Sun, Xiaoning Lei, Shuaijiang Zhao, Cheng Wen, Xingjun Tan, Chuandong Xie, Shuran Zhou, Rui Yan, Chenjia Lv, Yang Han, Wei Zou, and Xiangang Li, “KeSpeech: An Open Source Speech Dataset of Mandarin and Its Eight Subdialects,” Proc. NeurIPS Datasets and Benchmarks, 2021.
[2] Longhao Li, Zhao Guo, Hongjie Chen, Yuhang Dai, Ziyu Zhang, Hongfei Xue, Tianlun Zuo, Chengyou Wang, Shuiyuan Wang, Xin Xu, Hui Bu, Jie Li, Jian Kang, Binbin Zhang, Ruibin Yuan, Ziya Zhou, Wei Xue, and Lei Xie, “WenetSpeech-Yue: A Large-Scale Cantonese Speech Corpus with Multi-Dimensional Annotation,” Proc. AAAI, 2026, pp. 31627–31635.
[3] Xian Shi, Xiong Wang, Zhifang Guo, Yongqi Wang, Pei Zhang, Xinyu Zhang, Zishan Guo, Hongkun Hao, Yu Xi, Baosong Yang, Jin Xu, Jingren Zhou, and Junyang Lin, “Qwen3-ASR Technical Report,” arXiv:2601.21337, 2026.
[4] Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, and Weizhu Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” Proc. ICLR, 2022.
[5] Kaituo Xu, Yan Jia, Kai Huang, Junjie Chen, Wenpeng Li, Kun Liu, Feng-Long Xie, Xu Tang, and Yao Hu, “FireRedASR2S: A State-of-the-Art Industrial-Grade All-in-One Automatic Speech Recognition System,” arXiv:2603.10420, 2026.
[6] Yangyang Meng, Huihang Zhong, Guodong Lin, Guanbo Wang, Hu Du, Zhiming Shao, Yukai Huang, Ke Li, and Wei-Qiang Zhang, “Dolphin-CN-Dialect: Where Chinese Dialects Matter,” arXiv:2605.08961, 2026.
[7] Noah Hollmann, Samuel Müller, Lennart Purucker, Arjun Krishnakumar, Max Körfer, Shi Bin Hoo, Robin Tibor Schirrmeister, and Frank Hutter, “Accurate Predictions on Small Data with a Tabular Foundation Model,” Nature, vol. 637, pp. 319–326, 2025.
[8] Suyoun Kim, Takaaki Hori, and Shinji Watanabe, “Joint CTC-Attention Based End-to-End Speech Recognition Using Multi-Task Learning,” Proc. ICASSP, 2017, pp. 4835–4839.
