
 新一代Kaldi
文章来源于新一代Kaldi,作者NGK编辑部
NGK小组毕竟不是香港记者,不能每周都搞一个大新闻。近期有个别同学在交流群里问 Pruned RNN-T 的细节,这周就深入一点挖挖这个旧坟(闻)吧。
本文不会包含完整的公式推导,旨在帮助大家更好的理解原理,看懂代码。更多的细节请阅读论文[1]和代码rnnt_loss.py[2]
训练 RNN-T 模型慢在哪?
(N, T, U, V)向量。这样一个大的向量需要占据很大的显存,导致没法使用大的 batch size 来训练,另外,如此大的向量也造成 joiner 网络的计算量非常大,从而增加单次迭代的时间。Pruned RNN-T 为什么能快?
(N,T,U,V)向量剪裁至(N, T, S, V), 其中(N,T,S,V)向量 ,所以 joiner 网络里面的非线性层和 Linear 层的计算量大大减小,从而实现加速。如何 Prune?
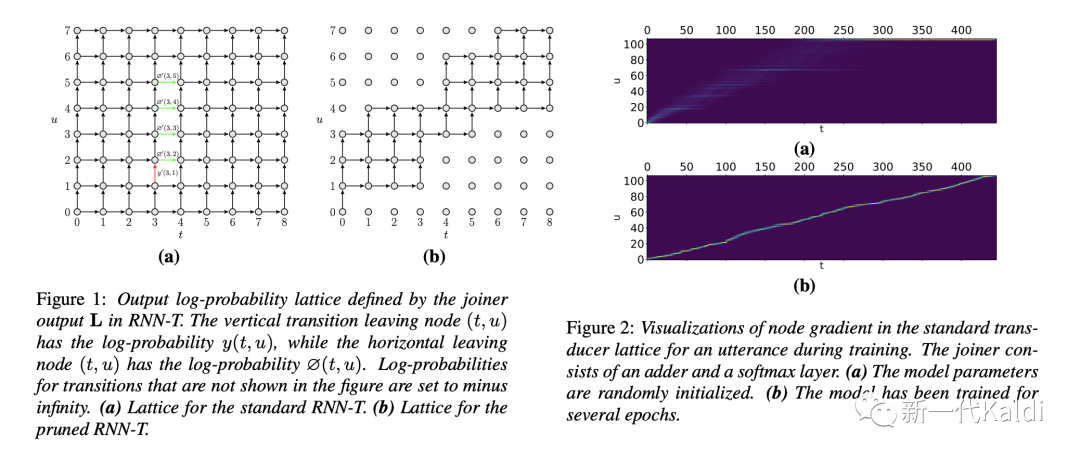
图(1)p
平凡联合网络
trivial joiner)的概念,这个trivial joiner是 encoder 和 predictor 的简单相加,即am + lm。使用这样一个简单的 joiner 网络是为了在不生成四维向量的情况下得到一个 lattice(细节我们在下面的代码实现中介绍),以便在这个 lattice 上求得剪裁边界。下图是 Pruned RNN-T 计算的流程图,我们实际上计算了两次损失函数,一次是在上述的trivial joiner上,一次是在正常的包含非线性层的 joiner 上(下图中的 s_range 就是上面提到的 S)。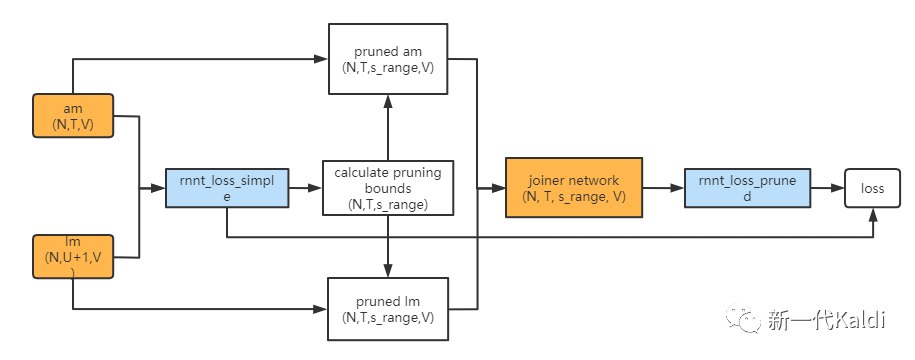
图(2)
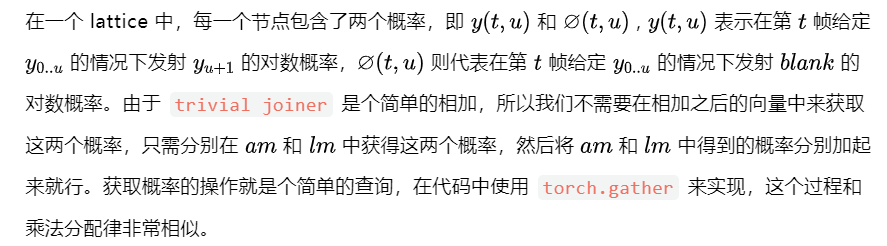
注:两个 shape 不一样的向量相加得先统一 shape,即 logit = am.unsqueeze(2) + lm.unsqueeze(1),所以如果相加之后再获取概率,我们就不得不生成一个四维向量。
剪裁边界的确定
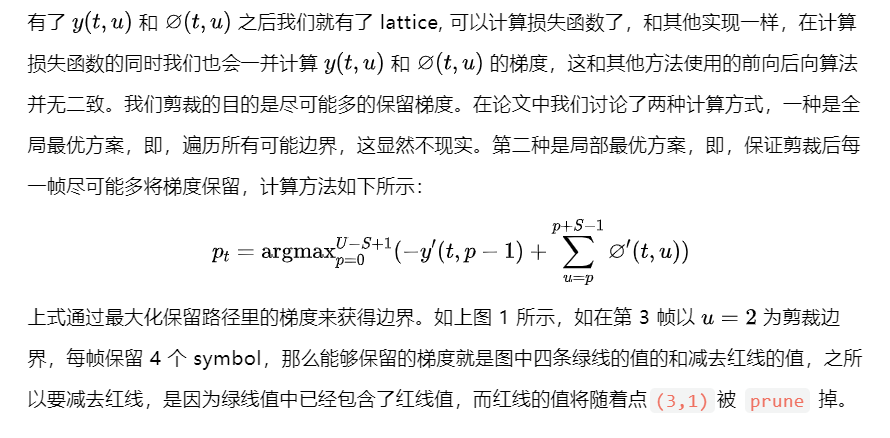
端点约束、单调约束和连续约束。其中连续约束的实现非常巧妙,感兴趣的同学可以在 k2 的代码中搜索_adjust_pruning_lower_bound函数,有非常详细的注释。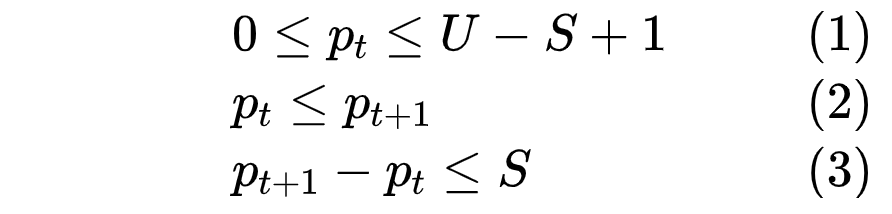
torch.gather实现。Pruned RNN-T 为什么能好?
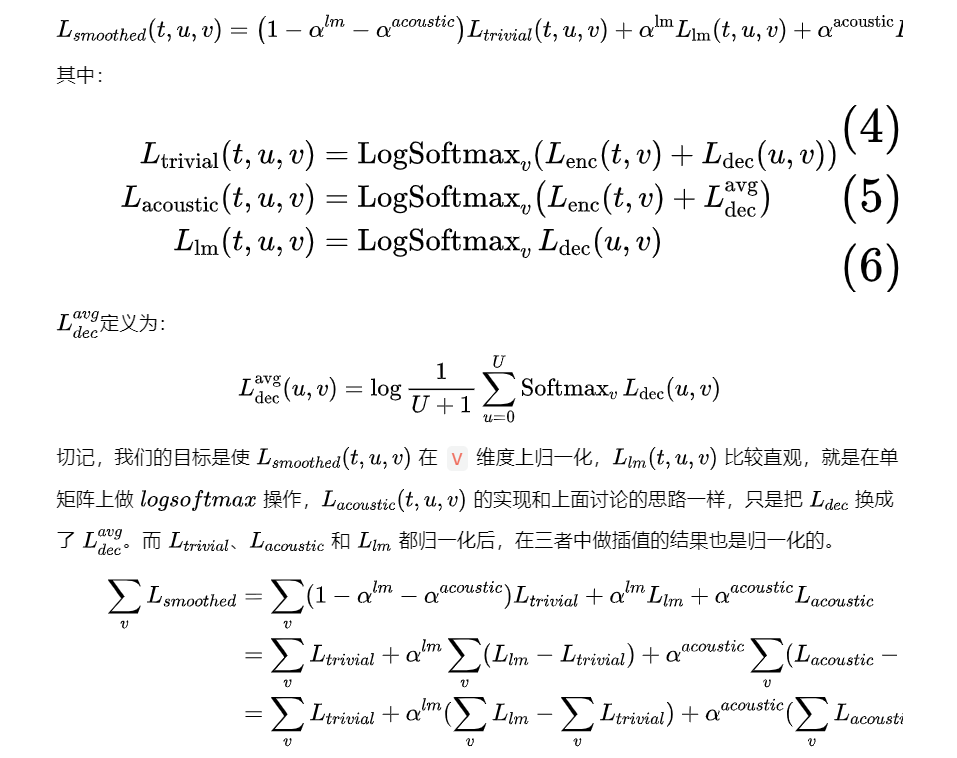
am)和语言学部分(lm)从trivial joiner里面剥离开来,这样便于根据需要设定不同的 am 和 lm 权重。在 Icefall 的实验中,我们发现给lm设置一个单独的权重(0.25), 即让 predictor 网络更像一个独立的语言模型,可以提升模型的准确性,而给am单独设置权重没能取得提升,甚至还有下降,所以目前am的权重默认值为 0。道理我都懂,代码怎么写?
前向后向计算
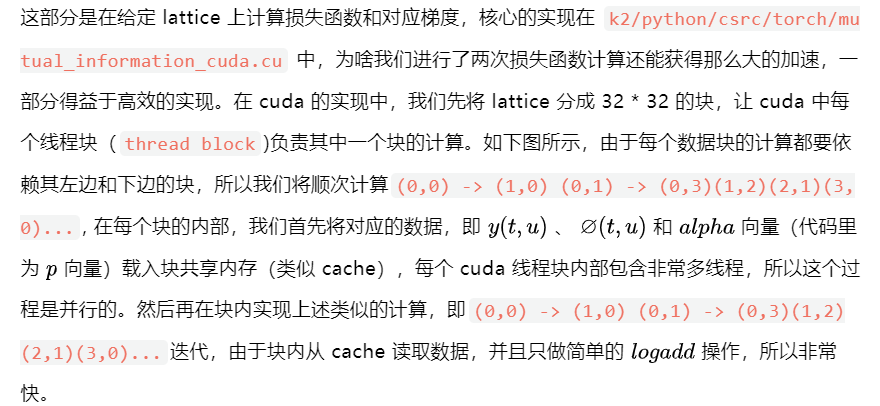
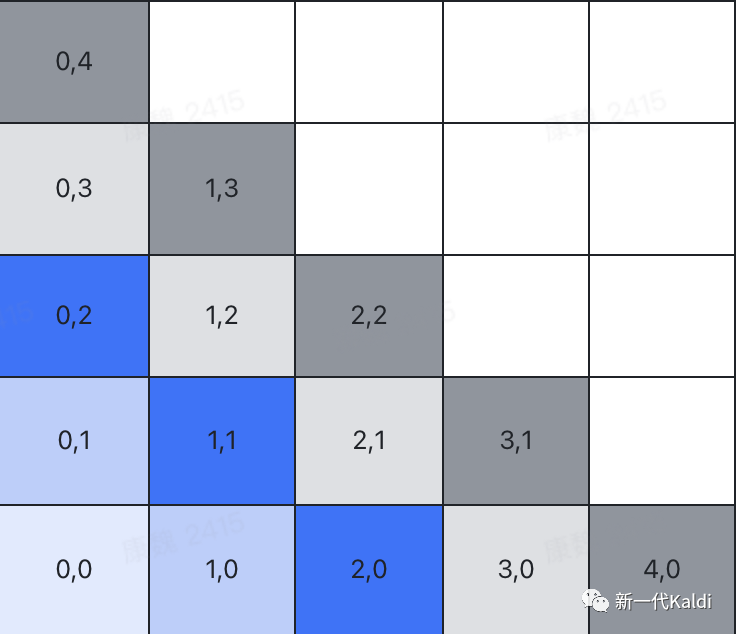
图(3)
注:上述两次 (0,0) -> (1,0) (0,1) -> (0,3)(1,2)(2,1)(3,0)...一次是在块这个粒度,一次是在块内元素的粒度。
注:读懂上述代码需要一些 cuda 线程模型和内存模型的知识,读一下CUDA C Programming Guide[3]的第二章就够用了。
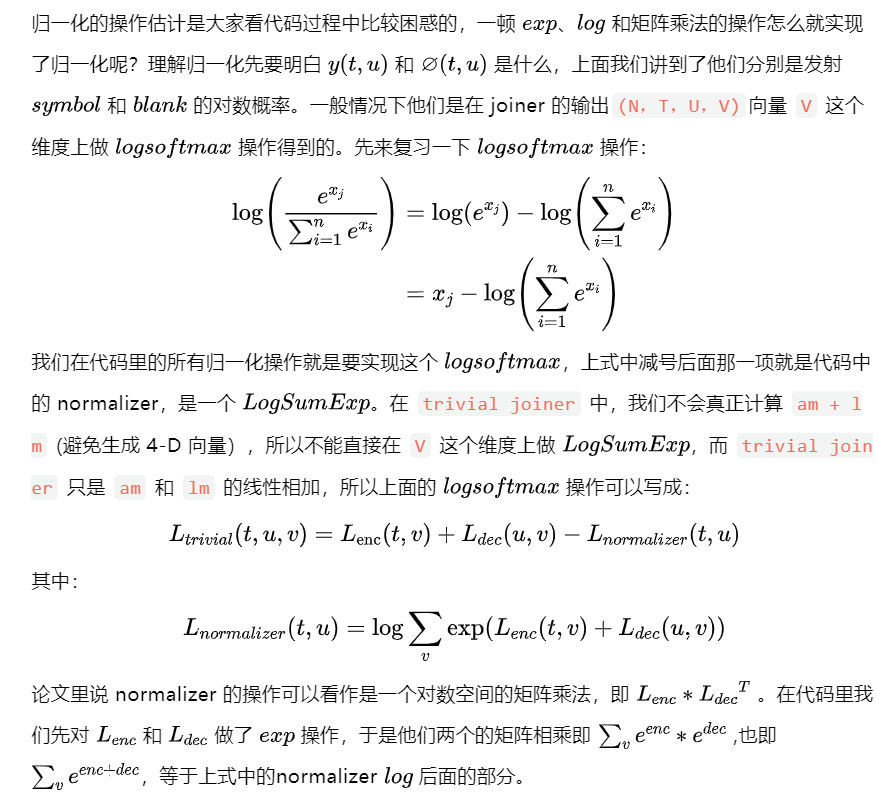
怎么做归一化?
总结
trivial joiner来进行剪裁的机制,最后就如何能在不生成四维向量的情况下计算 rnnt_loss_simple 的代码实现做了些说明,希望能帮助大家更好的读懂代码。