
 THUHCSI人机语音交互实验室
INTERSPEECH2022
MFA-Conformer: 基于多尺度特征聚合Conformer说话人识别模型的创新与应用
本文由清华大学与腾讯科技(北京)有限公司、台湾大学及香港中文大学合作。 提出了一种基于Conformer的多尺度特征融合的说话人识别模型(MFA-Conformer),通过融合各层不同尺度的特征,增强说话人特征的表征能力。 实验表明,与目前主流的声纹识别网络ECAPA-TDNN相比,本文所提出的MFA-Conformer在识别性能和推理速度上都有大幅提升。 该工作在腾讯科技有限公司的合作业务部门落地上线,新模型上线后实现了业务准确率20-40个点的巨大提升,节省线上服务资源30%。 论文投稿半年收到12点谷歌学术引用。 在工业和学术领域均产生了一定的影响力。
扫码阅读论文
https://arxiv.org/abs/2203.15249
论文代码开源链接
https://github.com/zyzisyz/mfa_conformer
01 背景动机
02 贡献
03 解决方案
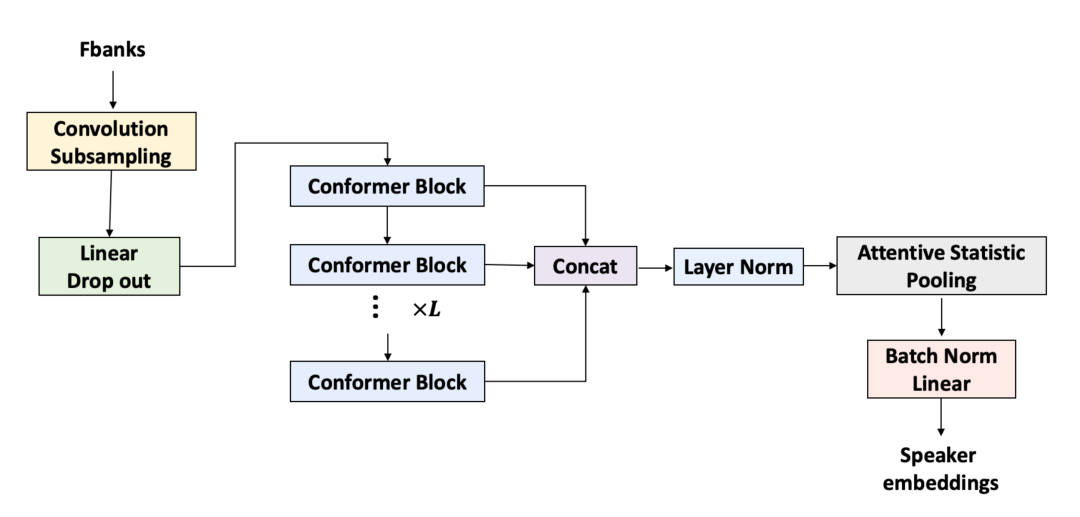
Conformer
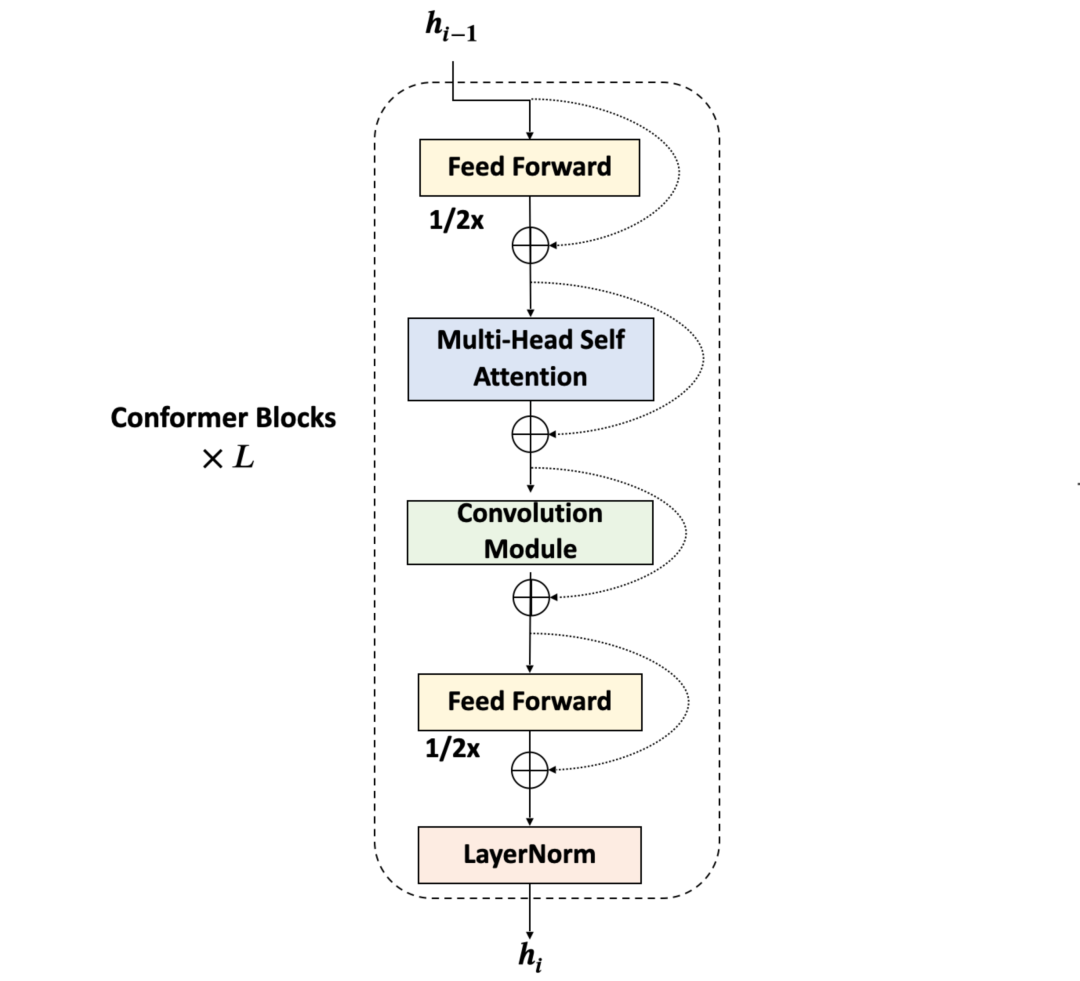
多尺度特征聚合 & 注意力统计池化层
04 实验验证
实验数据
基线系统及模型设置细节
在Voxceleb1-test & SITW上的实验结果
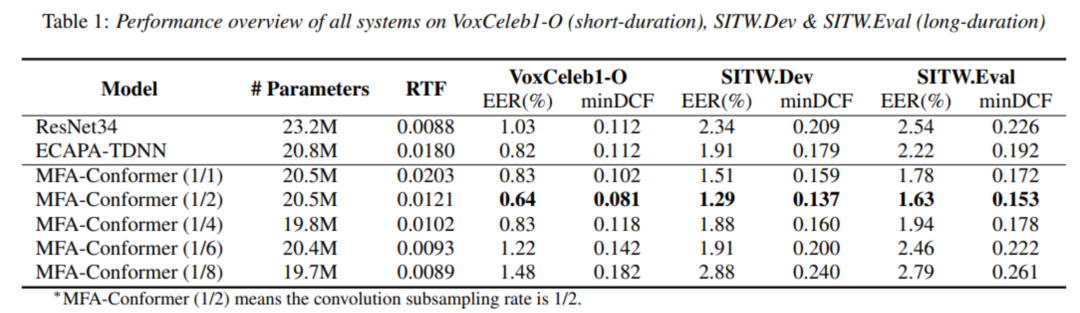
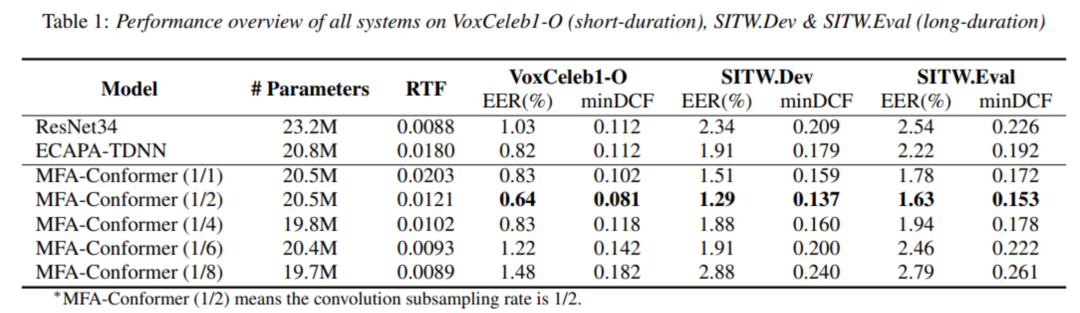
全局建模对声纹识别性能的影响
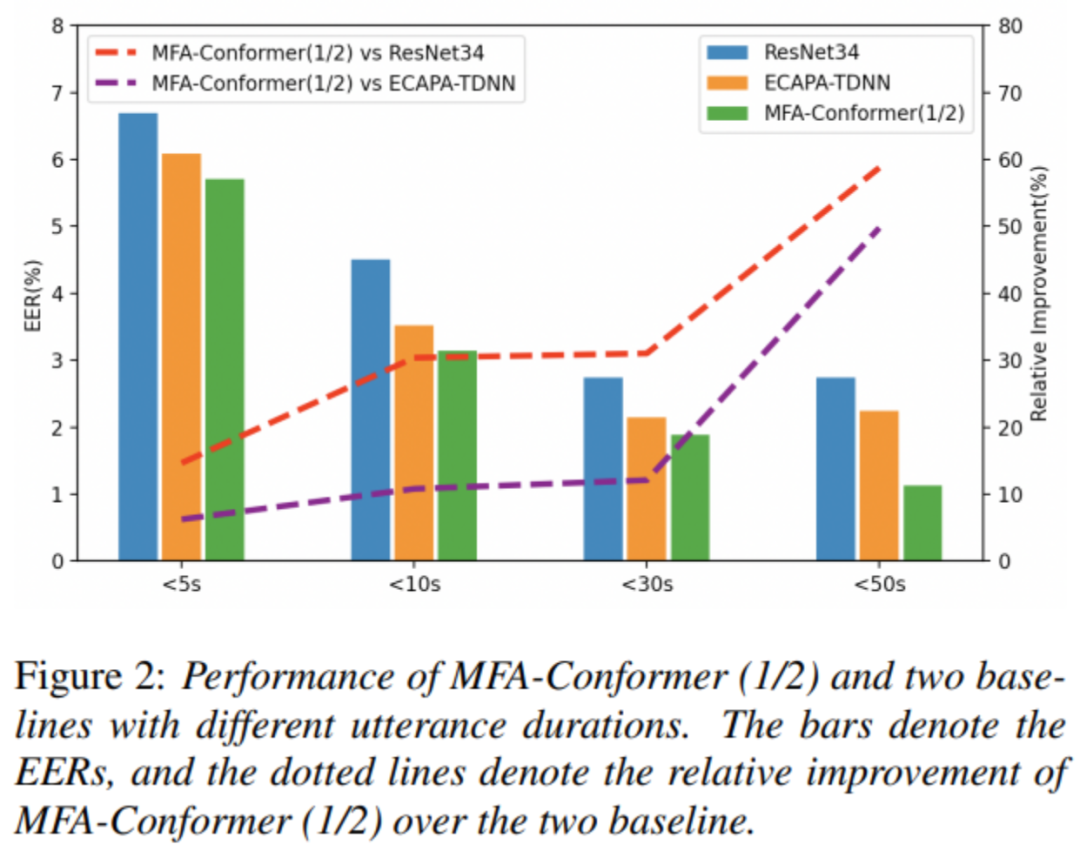
局部建模对声纹识别性能的影响
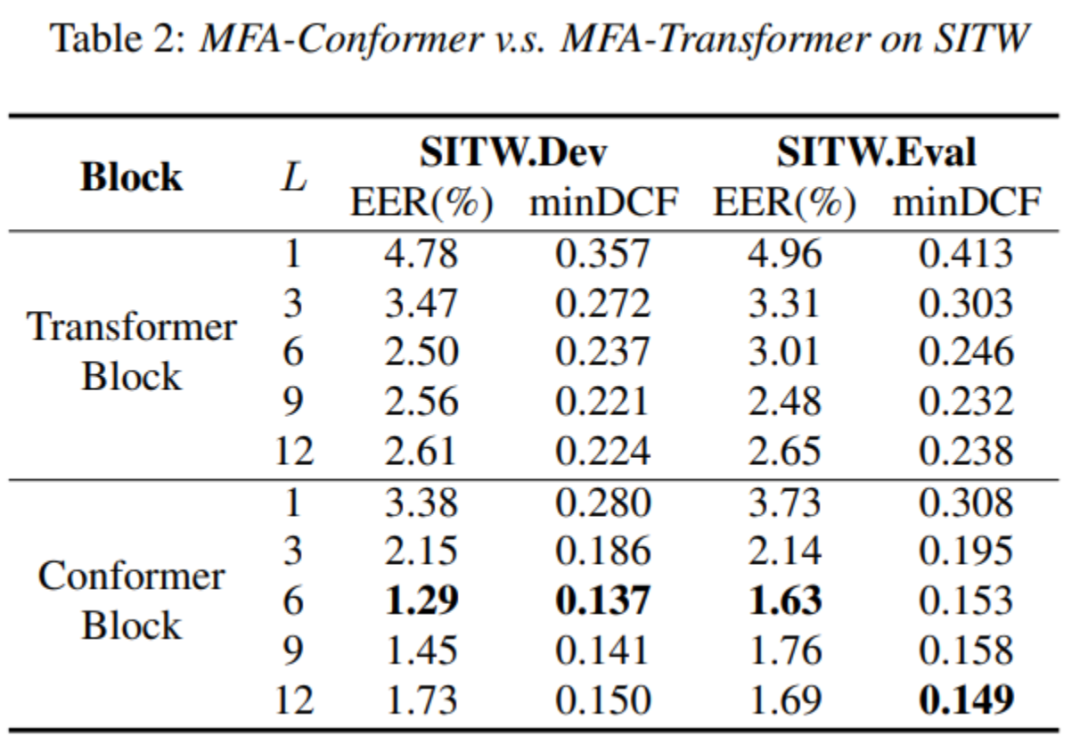
消融实验
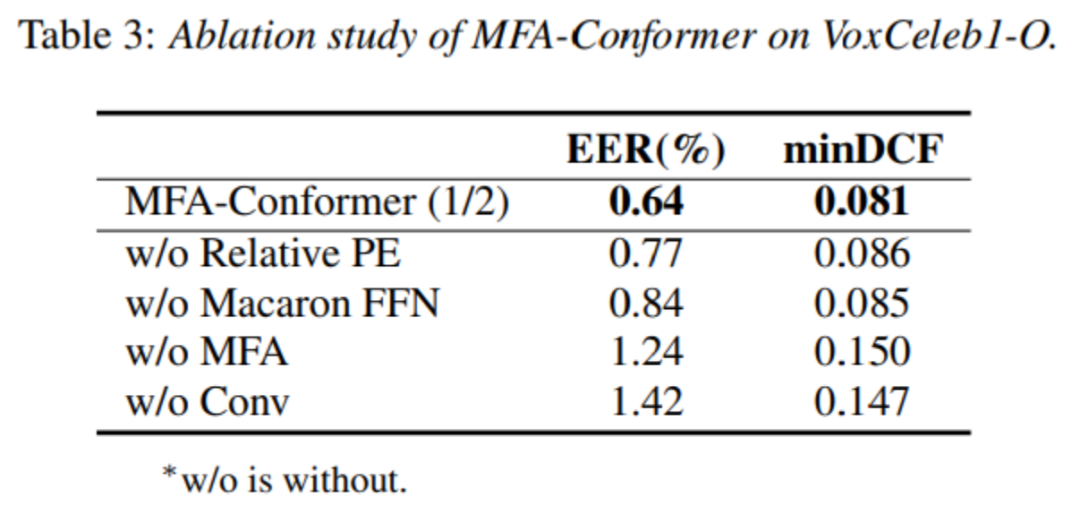
05 结语
本文提出了MFA-Conformer: 一种基于Conformer的多尺度特征融合的说话人识别模型,通过融合Conformer各层输出不同尺度的特征,增强说话人特征的表征能力。 MFA-Conformer在不同时长的测试场景下都有出色的表现,相比于业内主流的ECAPA-TDNN网络,MFA-Conformer无论是在识别性能还是推理速度上有明显优势。 在企业落地应用方面也有显著优势,可以在现有端到端语音识别引擎基础上实现快速迁移和部署,复用已有的语音识别加速算子和代码,从而降低系统的研发成本。 未来我们将基于MFA-Conformer在预训练和多任务上进行进一步的探索。
