文章来源于THUHCSI人机语音交互实验室,作者HCSIers
本文由清华大学与腾讯 AI Lab、香港中文大学合作。人类语音中丰富多样的表现变化常常来源于所表达内容中蕴含的信息与意图,因此从文本中挖掘尽可能丰富的语义知识并输入给声学模型,将有助于表现力语音合成(Expressive TTS)的实现。在这方面,以往方法通常利用大规模预训练语言模型提取的自监督文本表示来提升合成语音的韵律及自然度,但仅利用该预训练词嵌入或通过简单微调,仍然不足以提供充分的表现力语义建模。于是,我们引入了与语义分析密切相关的依存解析(Dependency Parsing),提出了一种用句子的依存结构增强预训练词级语义表征的方法,结合关系型门控图网络(Relational Gated Graph Network,RGGN)将特定句法依存信息自然地融入语义表征中,以进一步增强文本信息、从而提升合成语音的表现力及韵律效果。在普通话和英语单说话人语料上的实验结果表明,所提方法均有更好的性能表现、能够改善合成语音的自然度和表现力。其中与经典基线系统 BERT-Tacotron 2 相比,所提方法在两种语言上的主观平均意见得分均有0.4以上的显著提升。
扫码阅读论文
https://www.isca-speech.org/archive/interspeech_2022/zhou22e_interspeech.html
合成样例试听
https://thuhcsi.github.io/interspeech2022-dependency-semantic-tts/
文本转语音(Text-to-Speech,TTS),又称为语音合成,旨在对给定文本生成自然、流畅且具有丰富表现力的语音波形。随着深度学习技术的发展,目前基于神经网络的TTS系统已能够合成流畅自然的语音,但在表现力方面仍有巨大的改进空间。人类语音中存在着丰富多样的表现变化,这些变化取决于内容含义、说话方式、表达情感、传递意图等等因素,在本文中我们聚焦于内容方面,也即研究如何从待合成文本中更好地建模和预测表现力。
传统TTS系统的文本输入一般是经过字音转换(Grapheme-to-Phoneme,G2P)后的音素序列,或是在其中增添一些韵律标记。这些输入虽然可以“告诉”TTS系统该如何发音以及何处有停顿、升降语调,但一是它们的表征能力不够精细、无法建模语音中存在的多样且细微的变化,二是并未让模型“理解”实际文本含义、过分依赖于韵律标签而无法实现推理阶段的自发预测。因此从原始文本中挖掘尽可能丰富的语义知识并输入给TTS系统,有助于声学模型对表现力风格的有效建模和合理预测。受益于大规模预训练语言模型的发展,BERT在诸多自然语言处理(NLP)下游任务上表现卓越,一些工作开始将BERT提取的文本表示应用于TTS中,它们或直接作为声学模型的额外输入、或用来预测语音中提取的风格嵌入,均有效地改善了合成语音的韵律与自然度。然而仅利用BERT的预训练词嵌入或通过简单微调的方式,仍然不足以提供表现力建模所需的充分语义知识,这些知识包括但不限于对词间关系的描述——尽管有研究证明BERT中的注意力头(attention head)可以捕捉一些词间关系但反映的也并不明确和全面。依存解析是由语言学专家提出的一种用于语义分析的文本结构抽取方法,它用有向的依存路径将句子中相关单词连接起来并指明它们之间的依赖关系,梳理这些关系有助于我们进一步明确整个句子所表达的含义及每个词的重要程度。由此,便引出本文所提方法的动机:为了提供更加有效的文本语义信息,我们使用显式的词间依存关系重新加工从预训练BERT中提取的词嵌入,并将这种经过依存结构增强的词级语义表征送入声学模型,以期TTS系统能够合成既具有高表现力同时表达合理的语音。
本文提出了一种基于依存结构和预训练词嵌入的词级语义表征增强方法,以提高合成语音的表现力。具体而言,原始文本首先被输入到预训练依存解析模块Stanza和预训练语言模型BERT,分别得到句法依存树和池化后的词级嵌入,用来构建带有语义信息的依存图;其次为更好地使用依存结构,引入关系型门控图网络(RGGN)让语义信息沿着特定正向/逆向拓扑结构在相关词节点之间流动聚合,获得经依存信息增强后的词级语义表征;接着将该表征恢复成序列,上采样到音素级别,输入到声学模型中。在普通话和英语语料上的实验结果表明,所提方法能够改善合成语音的自然度和表现力;另外可视化结果显示,增强后的语义表征相比原始词嵌入在分布空间上具有更显著的分散程度和区分性。
03 解决方案
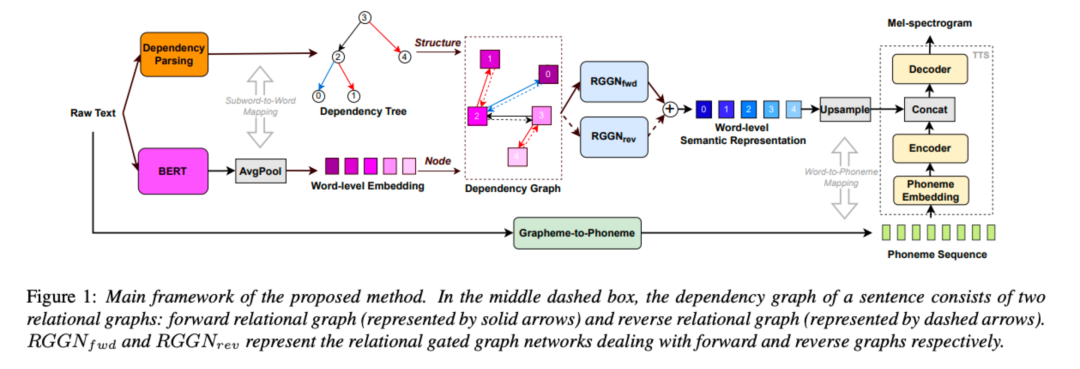
本文提出的模型结构如上图所示,先是根据从原始文本中提取的依存结构和词嵌入构建依存图,然后使用两个独立的的RGGN模块分别从正向/逆向角度来增强词节点的语义信息,最后将词级别表征作为附加输入传递给TTS模型,以提高合成语音的表现力。
在一个依存树中我们使用双词依存(bilexicalized dependencies)来描述单词之间的二元非对称关系,具体指一个被修饰主题(head)如何依赖于一个修饰语(dependent)。比如下图所示的这句话中,“fox”是“jumped”的名词主语,那么便用一条边将它们连接起来并由“jumped”指向“fox”,其边类别为“nsubj”。通过这样的解析方式,我们可以将一个扁平化的句子转换为一个具有拓扑结构的依存树。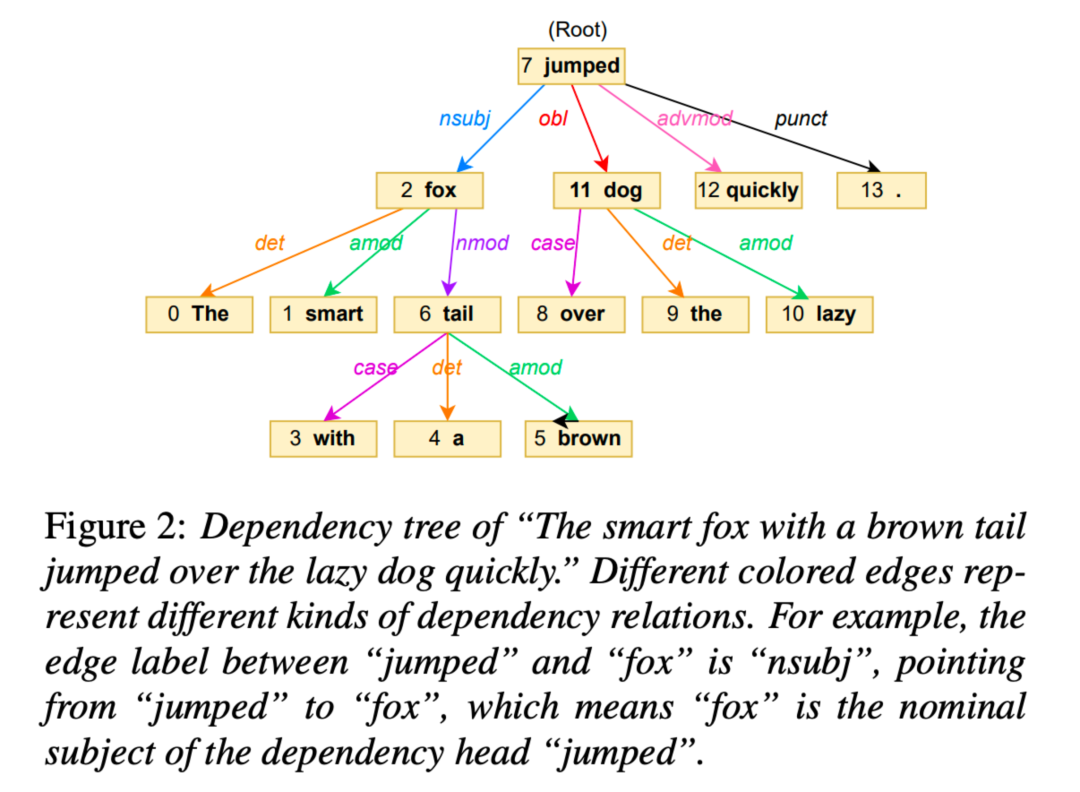
根据上述的依存树和从预训练语言模型BERT中提取的词嵌入,我们便可以开始构建带有基本语义信息的依存图:1)首先由于BERT模型提取的结果一般是子词级(subword-level),为了统一节点信息的粒度,我们按照依存解析的分词标准对该结果做一个池化,得到词级嵌入(word-level embedding),用来作为每个词节点的初始化语义表示,定义为节点集合Vsem。2)考虑到dependent和head之间的相互影响,仅按照原始依存树这样一种单向关系路径显然不够,于是我们引入了双向信息流的概念,并且为了不混淆两种方向的传播意义,进一步设置了正向和逆向两种关系集合,其中逆向依存边是将原始依存树的有向边方向反转(注:尽管在建图时逆向依存边与原始正向依存边来自于同一套类别标签,但它们传递信息的能力可能是不一样的,需要靠模型去学习),得到两组有向边集合Efwd和Erev。3)根据以上,分别得到正向关系图Gfwd=(Vsem, Efwd)和逆向关系图Grev=(Vsem, Erev),构成最终依存图表示。考虑到门控图神经网络(Gated Graph Neural Network,GGNN)在信息流长期传播方面的优势,我们将其扩展到关系型门控图网络(RGGN)用来处理上述具有正向/逆向关系集合且包含多种依存关系类别的依存图。在关系图网络的一次迭代中,每个词节点首先聚合来自其相邻指入节点的语义信息,并且聚合权重取决于边所对应的依存关系类别,然后通过GRU网络更新自身隐状态。经过多次传播迭代(注:本文中设置迭代次数为5,因为我们认为通常句子中5次可到达最远词节点),语义信息便沿着图拓扑结构和特定依存关系流向所有相关节点: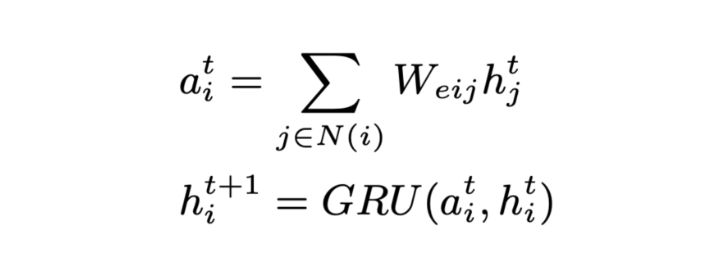
处理正向关系图和逆向关系图的RGGN分别记为RGGNfwd和RGGNrev,如模型框架图中所示。它们具有相同的结构但独立非共享的权重参数,这样正向和逆向的信息传递路径互相不受影响干扰。经过传递更新后,我们将来自于两个RGGN模块输出的对应节点表示加到一起,并恢复成序列形式作为最终的增强语义表征。本文中采用Tacotron 2作为合成模块,当然其他声学模型也可适配。这部分思路较为直接:上述词级语义表征按照词典映射关系被扩展到音素级别,然后与TTS编码器的输出拼接到一起,再传递给解码器用来合成语音的Mel谱。为了显示所提方法的通用性,我们分别在普通话和英语单说话人语料上进行训练和测试。普通话使用的是标贝开源的标准女声音频数据集(12小时),英语使用的是LJSpeech英文女声数据集(24小时)。每个数据集我们均保留100句话作为测试集,然后将95%用于训练集,5%用于验证集。对比模型
我们基于PyTorch版Tacotron 2实现了以下4种系统,包括2个基线模型和2个提出模型:Vanilla:原始Tacotron 2,仅输入音素序列。
BERT:即经典的BERT-Tacotron 2模型,将BERT词嵌入直接扩展成音素级别并拼接到TTS编码器输出上。
BERT-Dep(BLSTM):为了验证RGGN的有效性,设计了另一种使用双向长短时记忆网络(BLSTM)增强语义表征的方法。具体做法是将每个词直接指入的依存关系类别和head所在位置当作依存特征、并与BERT词嵌入拼接,传给BLSTM来学习增强语义表征。
BERT-Dep(RGGN):所提方法,同时使用RGGNfwd和RGGNrev模块增强语义表征。
主观实验
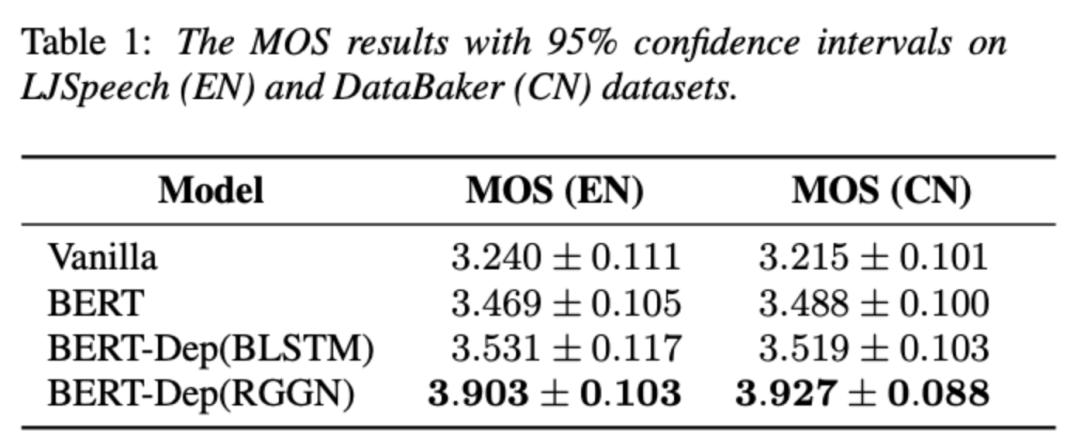
为了验证本文所提的基于依存结构增强词级语义表征方法的有效性,我们采用平均意见得分(Mean Opinion Score,MOS)对合成语音的自然度和表现力进行了主观评估,如下表所示,其中BERT-Dep(RGGN)得分最高,约为3.91,分别超过Vanilla 0.69、BERT 0.44和BERT-Dep(BLSTM) 0.39。从实验结果可以看出,本文所提方法在普通话和英语上均明显优于其他所有系统。与Vanilla相比,三个使用了BERT的系统均有提升,说明引入语义信息确实有助于表现力语音合成。与BERT相比,BERT-Dep(RGGN)在MOS上取得了显著改进、而BERT-Dep(BLSTM)的提升基本可以忽略,说明用RGGN这种图网络来将具有拓扑结构的依存信息建模到语义表征中是有效的,而单纯将依存信息作为附加特征可能不起作用。为了进一步明确所提方法中究竟是哪个部分发挥作用,我们进行了三组消融实验:分别在BERT-Dep(RGGN)中去除RGGN_fwd、RGGN_rev和边的依存关系标签(Edgelabels),按照相同策略训练这三个系统,并采用比较平均意见得分(ComparisonMOS,CMOS)作为评估指标。如表2所示,去除这些特定设计都会不同程度地导致性能下降,其中去除RGGN_fwd会导致性能下降严重(甚至在LJSpeech中产生不少bad case现象),而去除RGGN_rev只会致使少许下降,这表明正向关系图对表现力语义建模的贡献更大。另外可以看出,去除Edge labels的CMOS表现仍然优于BERT-Dep(BLSTM),这反映了引入依存解析这种拓扑结构本身的优势。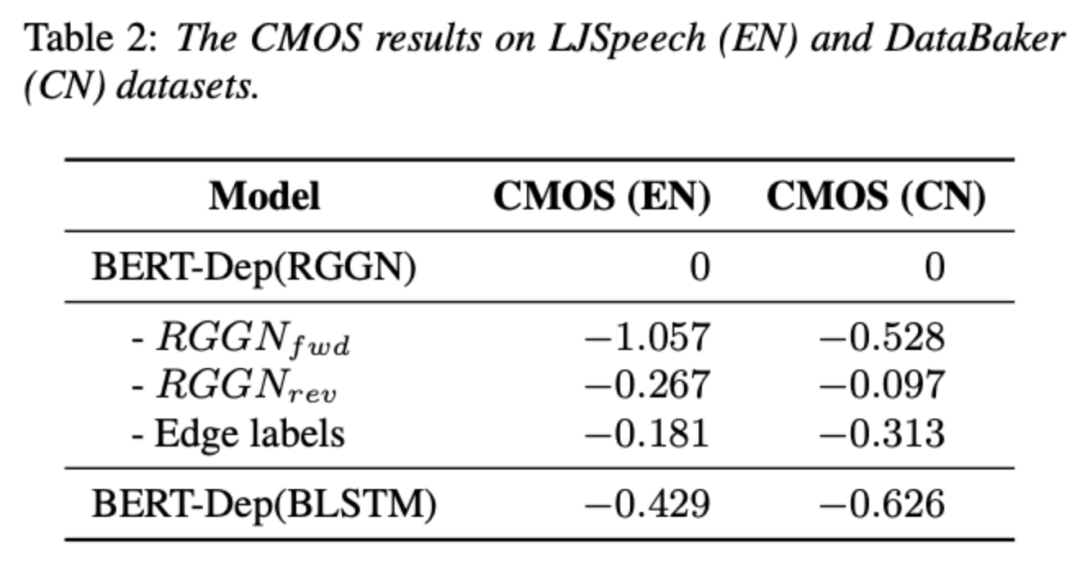
为了具象展示所提方法在表现力语音合成上的优势,我们进行了一组样例分析,比较不同系统合成语音的Mel谱、基频轮廓和强度曲线,如下图所示。其中合成文本是莎士比亚的经典名句“To be, or not to be: that is the question.”,音频特征是由Praat提取而得。从图中可以看出,BERT的两个“to be”在发音上很接近、基频也相对平坦,因为从文本表征提取上看它们的词嵌入会非常相似;两个使用依存信息的系统的第一个“to be”的基频都高于第二个,而BERT-Dep(RGGN)中两个“to be”的发音和基频变化更有区分性,这是由于两个“be”在依存结构及相关词上有差异。另外,在BERT-Dep(RGGN)中第一个逗号对应的停顿更为明显。对于“that”和“question”,可以观察到“question”在BERT和BERT-Dep(BLSTM)中被强调,这可能是由于它的BERT预训练词嵌入语义信息比“that”更强;相反,BERT-Dep(RGGN)强调的是“that”而不是“question”,因为“question”的语义信息通过依存结构传递给了“that is the”,而强调“that”(代指前面的陈述部分)会让整句话的表达更加自然。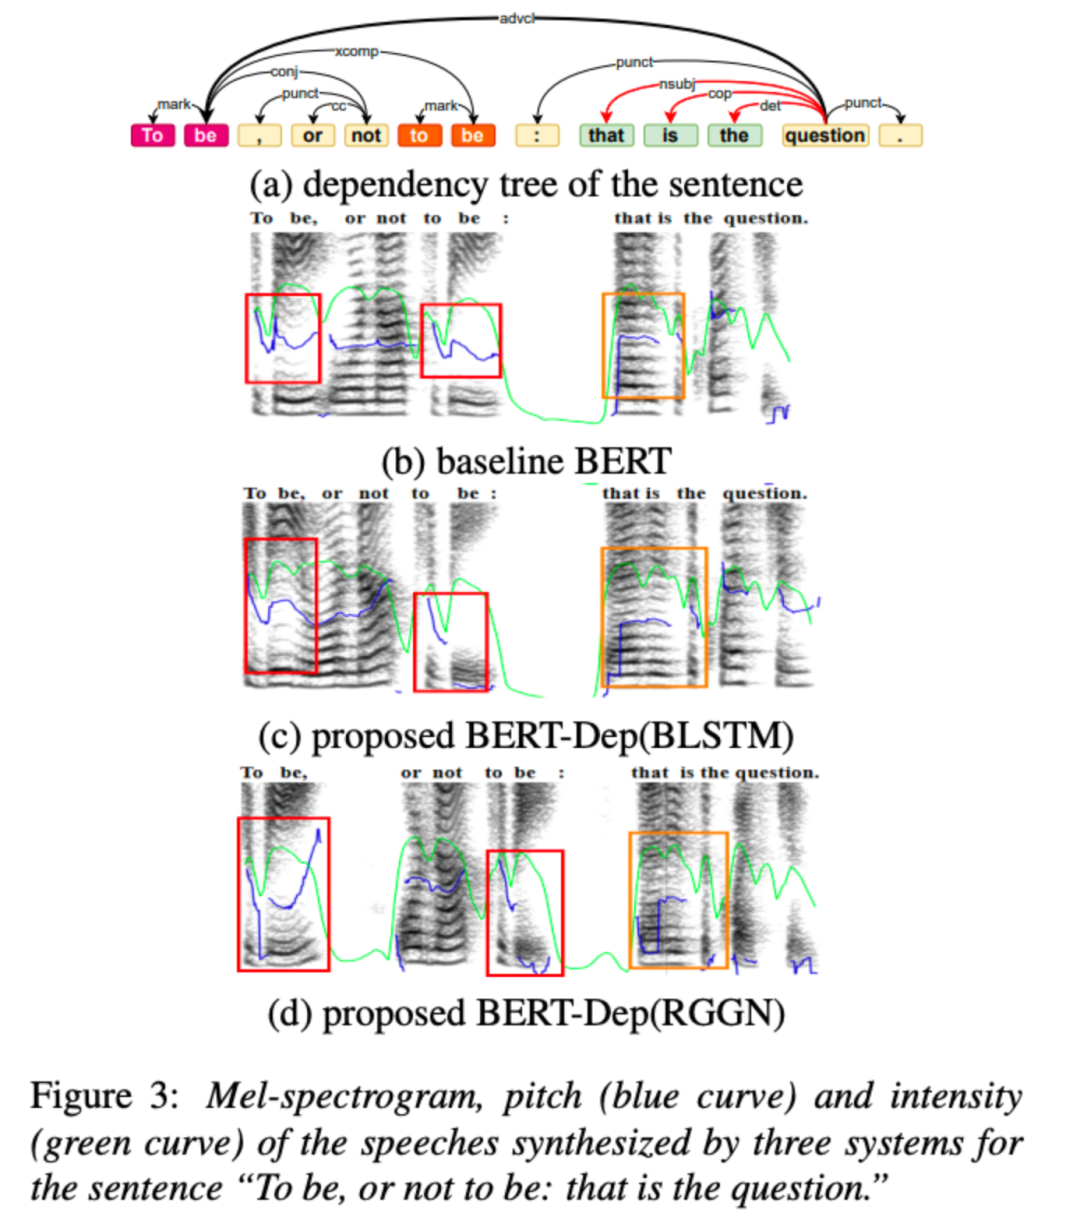
此外,我们通过二维t-SNE可视化展示了这句话的词级语义表征的分布情况,如图4所示。可以看出所提方法学习的语义表征(红色)比其他两个系统在空间分布上更加散开。这说明通过引入依存结构,该方法可以进一步增强BERT预训练词嵌入的区分性或多样性。举例而言,在BERT-Dep(RGGN)中两个“be”的距离更远,也对应于上述合成语音中的音频现象。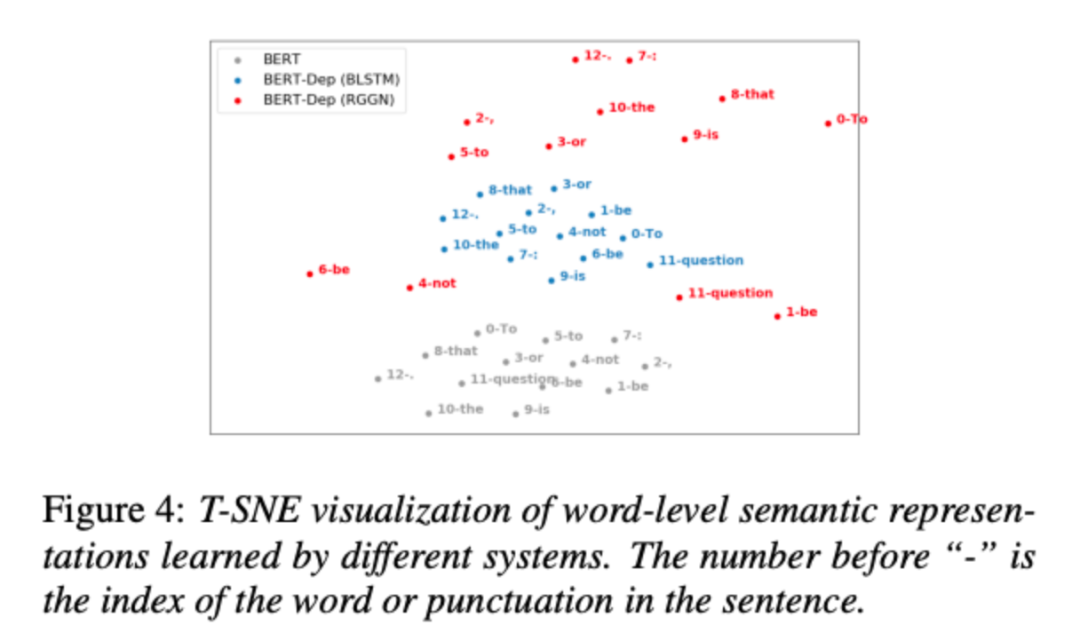
本文为表现力语音合成任务提出了一种基于依存结构的词级语义表征增强方法。该方法考虑了每个词在句中的依存结构位置及相关词的信息,重新处理预训练BERT模型提取的词嵌入,从而生成更有效、更适用于表现力语音合成的语义表征。在普通话和英语数据集上的实验结果表明,所提方法能够进一步提升合成语音的表现力和自然度。

 THUHCSI人机语音交互实验室