
 THUHCSI人机语音交互实验室
SECap:基于大语言模型的语音情感描述生成
代码和模型开源及结果展示:https://github.com/thuhcsi/SECap
01、背景介绍
语音交流在人们日常生活中起着关键作用。作为人际交流的核心载体,语音不仅承担着传递信息的功能,更涉及到情感和意图等”言外之意“的传递。准确识别和解读语音情绪对于增强交流效果至关重要。因此,如何从语音中准确提取出说话者的情绪信息,已逐渐成为语音处理领域的一个重要课题。
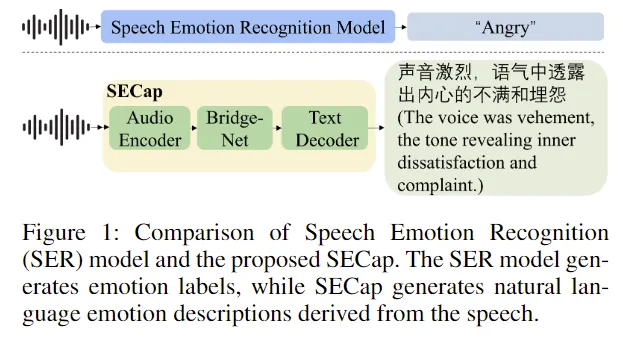
过往研究通常将语音情绪获取视为分类任务,也即语音情感识别(speech emotion recognition, SER),例如将语音中的情绪划分为恐惧和快乐等离散的类别。然而,传统的SER存在局限性,因为单词标签往往缺乏细微差别,无法传达如强度和波动等详细的情绪信息。另一方面,语音情绪通常是多面的,一个音频中可能包含多种情绪状态(例如同时存在的快乐和紧张)。将语音分类为单一的情绪类别可能无法充分捕捉到真实的情绪。此外,情绪也是具有主观性的,个体在解读复杂语音时的情绪分类往往存在潜在的不一致性。
考虑到语音情绪分类的局限性,本文致力于使用自然语言的句子而不是标签来描述语音情绪,并为此提出了一个新的任务,语音情感描述(speech emotion captioning,SEC),并构造了SECap模型来解决SEC任务。
02、主要挑战与解决方法
SEC任务主要有两个挑战:一是如何从原始语音输入中提取与情感相关的语音特征;二是如何生成高质量、接近人类水平的语音情感的自然语言描述。
对于第一个挑战,由于带有情感标注的语音数据有限,从头开始训练音频编码器具有一定难度。受到预训练模型在SER任务中成功应用的启发,本文采用HuBERT作为SECap的音频编码器,以实现稳定有效的语音特征提取。然而,直接使用帧级的HuBERT特征可能导致计算负担过重。为解决这一问题,受到BLIP-2的启发,本文采用Q-Former作为桥接网络(Bridge-Net)对HuBERT特征进行压缩处理。值得注意的是,HuBERT特征中的声学信息和内容信息都与语音情感有关。但通常来说,声学信息与语音情感的关系更为直接,而内容信息可以通过转录轻松获取。因此,在Bridge-Net中,本文旨在从HuBERT特征中分离提取与情感相关的声学信息,同时去除内容信息。为此,本文运用语音-情感描述对比学习和语音-转录互信息学习训练Bridge-Net,以便更好地提取与情感相关的声学信息。
对于第二个挑战,由于GPT-4等大语言模型的进步及其令人印象深刻的自然语言理解能力,本文采用LLaMA作为文本解码器,基于Q-Former提取的语音特征生成流畅且连贯的语音情感描述文字。同时,本文使用LLaMA来指导Q-Former的训练,使其更好地将语音情感特征投射到LLaMA的空间中,从而最终获得更高质量的语音情感描述。
03、研究方案
模型整体架构
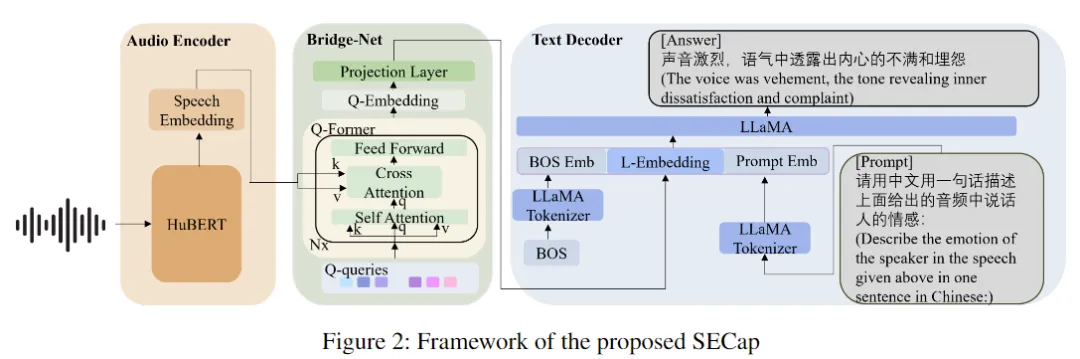
受声学事件描述(automatic audio captioning,AAC)任务的启发,SECap采用了编码器-解码器架构,如上图所示。音频编码器(Audio Encoder)提取语音特征,桥接网络(Bridge-Net)提取与情感相关的语音特征并将它们转换成文本解码器的特征空间。然后,文本解码器(Text Decoder)根据这些特征生成语音情感描述文字。
本文使用HuBERT来获取语音嵌入,然而,帧级的HuBERT特征可能导致计算成本过高。因此,本文采用基于Q-Former的Bridge-Net来压缩HuBERT提取的特征同时将其投影到LLaMA的表征空间,充分利用其卓越的自然语言理解能力,生成合适通顺的语音情感文本描述。为了与LLaMA的输入格式保持一致,本文将Bridge-Net得到的特征置于“BOS”和文本提示之间,旨在通过提示限制LLaMA的输出空间,从而产生更准确的语音情感描述。
获取情感更相关的语音特征
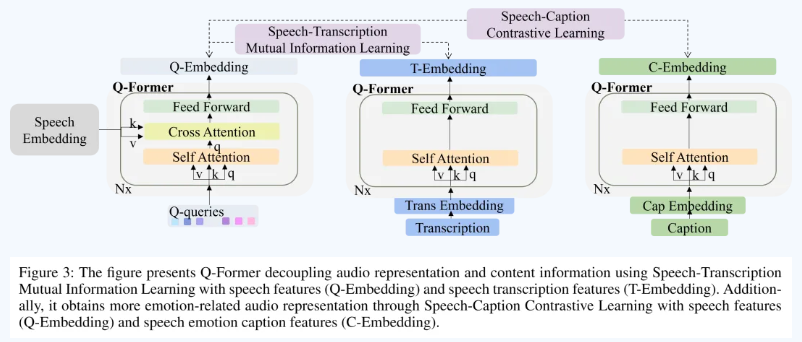
由于HuBERT语音特征的冗余性,本文设计并采用了Q-Former来压缩和提取与情绪相关的语音特征,它由自注意力层(self attention layer)、交叉注意力(cross attention layer)和线性层(feed forward)组成。Q-queries是用于提取语音特征的的可学习参数,并通过交叉注意力机制作为query查询HuBERT提取的语音特征中与情感更相关的部分。
为了向LLaMA提供更多与内容无关但与情感相关的语音特征,本文同时结合人工标注的语音情感描述(Caption)和转录文本(Transcription)来进行特征学习。如上图所示,这些信息通过一个Q-Former进行处理,其结构与原始Q-Former基本一致,只是去掉了交叉注意力模块。这个过程产生了C-EmbeddingQc和T-EmbeddingQt。本文进而采用语音-转录文本互信息学习(Speech-Transcription Mutual Information Learning,STMIL)来将语音特征与语音内容分离;此外,还利用语音-情感描述对比学习(Speech-Caption Contrastive Learning,SCCL)来提取更多与情感相关的语音特征。
语音-转录文本互信息学习(STMIL)
语音内容可能会影响情感评估,例如,平静地表达喜悦的陈述。为了尽量减小语音特征与内容之间的相关性,从而降低语音内容对LLaMA生成语音情感描述文本的影响,本文提出了语音-转录文本互信息学习策略。如上图所示,本文同时将语音和其对应的转录引入到Q-Former中,得到Q-EmbeddingQc和T-EmbeddingQt。这使得可以在统一的表示空间内比较语音及其内容。为了评估Qe和Qt之间的相关性,本文采用互信息I(Qt;Qe)作为度量指标:
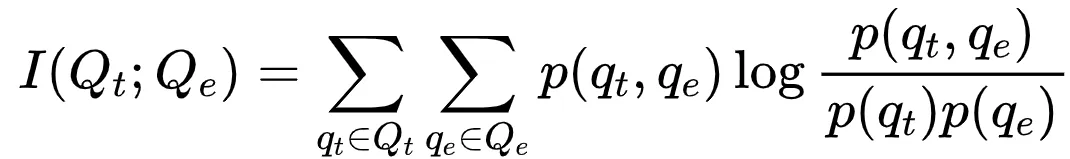
然而,由于Qe和Qt的高维性质,直接计算它们之间的互信息是不可行的。尽管先前的方法如MINE和infoNCE可以估计互信息的下界,但它们并不适合用于控制最小化过程。因此本文借鉴了vCLUB方法,使用以下公式来估计互信息的上界,并将其作为损失函数来减小语音特征与内容之间的相关性:
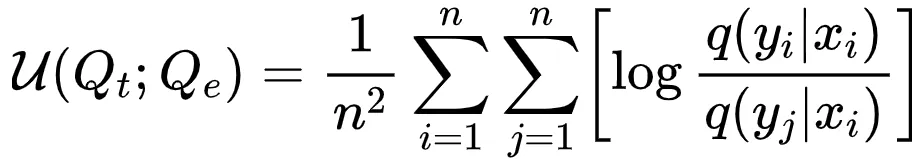
语音-情感描述对比学习(SCCL)
由于语音表示的高维度和冗余性,语音特征包含丰富的信息,如内容和背景噪声,其中只有一部分与情绪相关。为了减轻LLaMA处理语音特征的复杂性,本文希望Q-Former能够提取与语音情感描述高度相关的特征,从而减少语音特征和文本模态之间的差距。如上图所示,本文的目标是最小化Qe和Qc之间的距离,促使Q-Former提取更多与情绪相关的特征,并逐渐接近文本模态。受到CLAP的启发,本文采用对比学习方法来准确表示不同语音样本的Qe之间的距离,确保具有相似情绪的语音产生更接近的Qe距离,而情绪不同的语音则产生更远的Qe距离。
训练步骤
为了提高LLaMA生成的语音情感描述质量,本文设计了一个两阶段的训练过程。
第一阶段压缩HuBERT提取的语音特征以获得与情感相关的属性;随后将这些特征与LLaMA的表示空间对齐。受BLIP-2启发,本文使用预训练的BERTbase参数初始化Q-Former。在第一阶段的训练中,本文结合STMIL和SCCL进行协同训练,同时保持HuBERT模型参数冻结。
在第二阶段的训练中,本文对Q-Former和投影层进行微调,以便将Q-Former提取的语音特征更有效地融入LLaMA。同时,LLaMA和HuBERT的参数保持不变。本文在L-Embedding之前插入一个“BOS”标记,以使其与推理格式对齐。为了提高SECap的泛化能力,本文设计了30个语义相近的句子,每个句子的意义都与“用一句中文描述说话者的情感”相近。在训练过程中,随机选择一个句子与L-Embedding进行拼接作为输入,并使用交叉熵损失进行训练。
04、实验验证
实验数据
由于缺乏公开的SEC数据集,本文使用了名为EMOSpeech的内部数据集。EMOSpeech数据集由5名女性和2名男性演讲者组成,总计包括41.6小时的语音,涵盖30526个句子,采样率为24kHz。EMOSpeech中的每段语音都有三到五个由人类标注的语音情感描述文本(speech emotion caption)和人类标注的语音情感标签(speech emotion label),这些标签由不同的标注者进行标注,每句话并附有相应的转录文本(transcription)。本文随机选取600个句子作为测试集,600个句子作为验证集,其余29326个句子作为训练集。
评测指标
由于目前还没有用于评估语音情感描述的现成方法,本文根据SEC任务的性质设计了客观和主观的评估方法。
在客观评测中,本文借鉴了AAC任务的客观评估指标,包括BLEU1、BLEU4、METEOR、ROUGE1、CIDEr和SPICE。然而,这些指标主要关注词级别的匹配。为了更有效地在句子级别评估两个中文情感字幕的相似性,本文结合上述标准,进一步采用了两个预训练的语言模型进行句子相似性的评估SIM1和SIM2。
在主观评测中,本文制定了一个三阶段的评分标准,以减少由于评估者对情感理解不一致导致的差异性。第一步是确定生成的句子是否描述了一种情绪。第二步是评估当生成的句子被总结为一种情绪时,是否与语音匹配。第三步是评估生成的句子是否在情绪强度上与语音相符。
客观评价实验
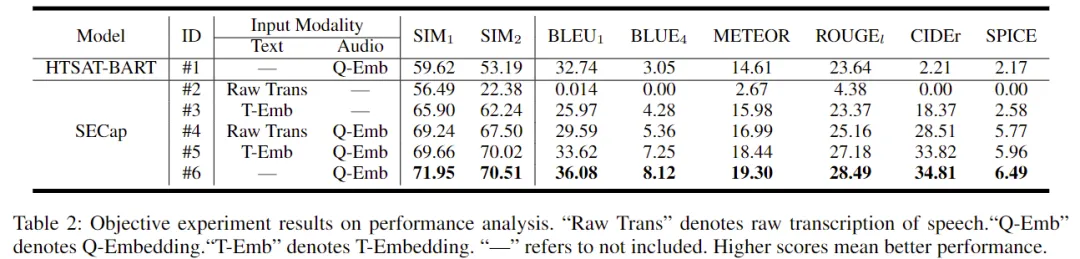
上表显示不同实验中大多数指标具有相对一致的趋势。因此,本文后续的分析将主要集中于从两个反映中文句子相似性的指标SIM1和SIM2所获得的结论。如上表所示,当只包含语音特征时,所提出的SECap(#6)在所有客观指标上都超过了HTSAT-BART(一个AAC任务中的通用模型)基线,这表明与HTSAT-BART模型相比,SECap有能力生成更自然、更像人的语音情感描述文本。本文进一步尝试加入了不同的特征,包括句子的文本内容以及嵌入的方式(Raw Trans, T-Emb),实验结果发现当仅仅加入音频特征时,所进行的客观评测实验的客观指标会呈现更好的效果。
主观测评实验
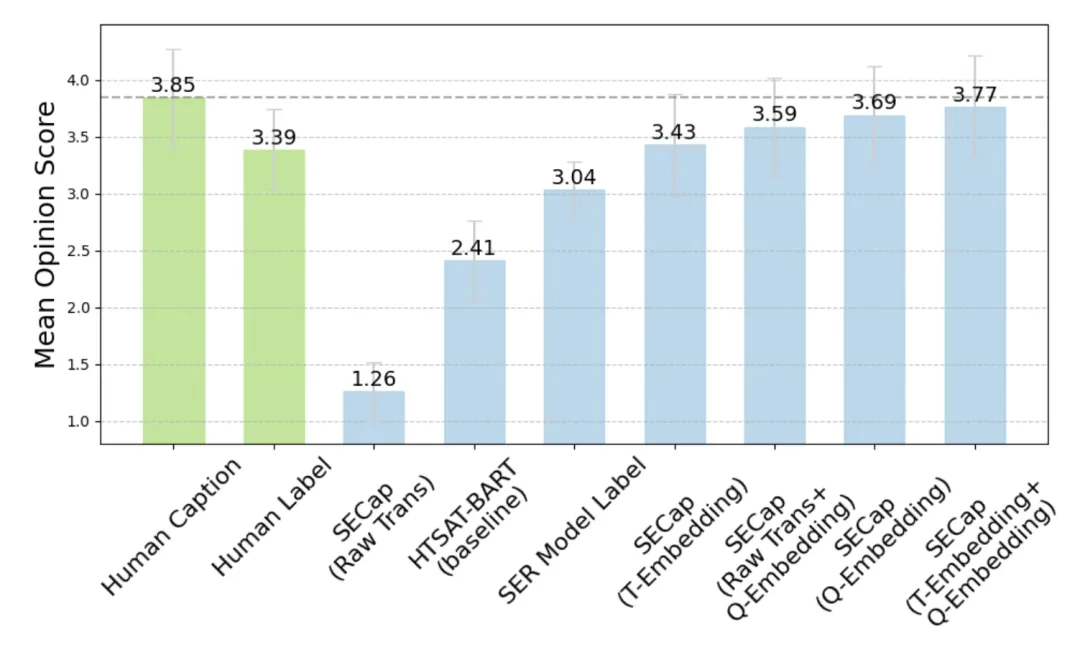
上图展示了SECap在主观评测上的结果,可以很明显的从图中看出:人工标注的语音情感描述(human caption)超过了人工标注的语音情感标签(human label)和SER模型所识别的标签(SER model label)。这个结果符合SEC任务的目标,即用一句话描述情感是更全面以及更准确的。值得注意的是,最好的SECap模型的表现超过了人工标注的语音情感标签,并与人工标注的语音情感描述相当。此外,从上图中还可以发现,如果仅使用原始转录(SECap (Raw Trans))作为输入,SECap的性能并不是非常突出。然而,其他SECap输入方法在主观评估指标上超过了人工标注的情绪标签和基线(HTSAT-BART),表明了SECap生成适当的、被认为更能代表情感的语音情感描述的能力。
然而,将Q-Embedding和T-Embedding都作为输入生成的主观评估结果优于仅使用Q-Embedding作为输入的结果。这与客观评测实验中#5和#6的结果相反。这可能是因为依赖预定义规则的客观指标可能与基于人类感知和理解的主观评估存在差异。由于评估者往往更关注微妙的细节,如情感表达的自然性和上下文信息,这些是客观指标难以捕捉的,因此可能会出现差异。此外,本文在实验时还观察到,评估者最初主要关注语音内容。而当内容和情感出现冲突的情况下,评估者往往倾向于给那些与语音内容更相关的情感描述以更高的分数。例如,以平淡的语气说出“我今天感觉很糟糕”时,当只考虑语音表征时可能会产生描述平淡语气的情感描述文本,而同时考虑语音表征和内容表征时则会产生描述悲伤和平淡的情感描述文本。
06、结论
为了更好地表达语音情感,本文提出了一种创新的任务:语音情感描述(Speech Emotion Captioning),它使用自然语言描述而非单一标签来表征语音情感。本文提出的语音情感描述模型SECap,整合了基于HuBERT的音频编码器、基于LLaMA的文本解码器和基于Q-Former的Bridge-Net,能够生成高质量的语音情感描述文本,其性能达到了与人工标注媲美(on par with human)的结果。这个开创性的任务和方法为语音情感理解提供了一个崭新的视角。
