
 THUHCSI人机语音交互实验室
MSStyleTTS:面向表现力语音合成的多尺度风格建模
1- 背景动机
2-贡献
本文提出了一种多尺度风格建模方法MSStyleTTS,该方法首次尝试从层级上下文信息中建模全局、句子和字级别三个不同尺度的说话风格,从而实现富有表现力的语音合成。
为了学习风格表征,本文提出了一种多尺度风格提取器,它用于从不同范围的梅尔谱中提取上述三个级别的风格嵌入,然后显式地指导预测器的训练。同时,本文将不同层次的风格表示为残差,以减少不同层次风格之间的冗余,从而使后续的预测任务变得更容易。为了更好的预测风格表征,本文提出了一个层级上下文编码器和两个层级风格预测器,既考虑了上下文中的结构关系,也考虑了预训练BERT模型提供的上下文信息,并且通过残差连接一步步预测不同层次的风格。此外,本文针对基于段落的合成设计了一个自回归的风格预测器,进一步提升了模型在合成段落语音时的表现力。
在域内和域外的有声读物数据集上的实验结果表明,MSStyleTTS生成的语音的自然度和表现力明显优于三个基线模型。并且广泛的消融实验证明了本文提出的各项技术的有效性,尤其是上下文信息的使用和多尺度风格表征方面。
3-研究方案
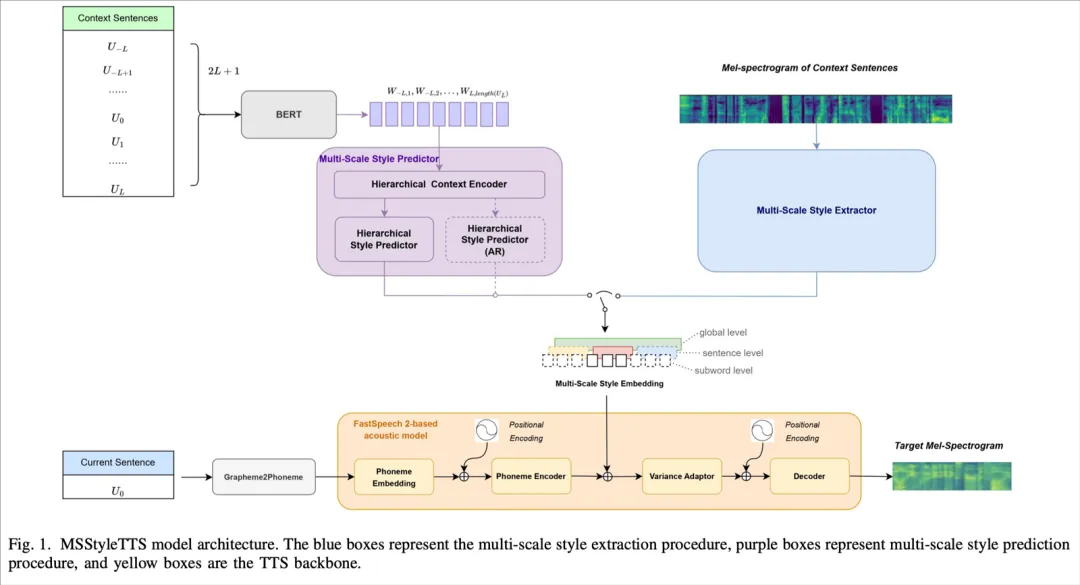
本文提出的模型结构如上图所示,它主要包括:(1)改进的FastSpeech 2声学模型;(2)多尺度风格提取器;(3)多尺度风格预测器。提取器将用于提取三个不同层级的说话风格表征,而预测器用于从上下文中预测这些风格表征。声学模型在提取器或者预测器提供的多尺度风格表征的帮助下合成当前句子富有表现力的语音。各组成部分的详情如下。
多尺度风格提取器
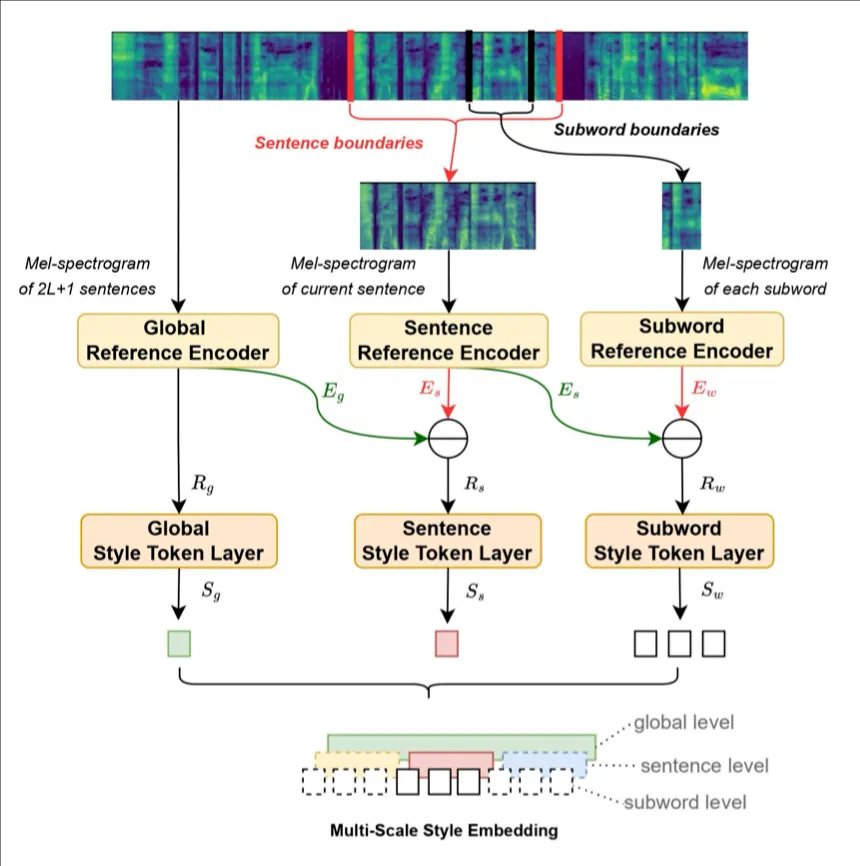
对于多尺度风格表征的提取,本文采用了三个参考编码器和风格标记层,分别对应全局级别、句子级别和字级别。除了当前句子外,本文还考虑了与上下文文本范围对应的整段音频,并按照句子边界、字边界切分得到当前句子和句子内每个字对应的音频片段,不同层级的音频片段将通过对应层级的参考编码器获得相应的语音表征。接下来,考虑到不同层次的语音表征之间的语音表征会有重叠部分,本文提出采用残差表征来代表不同层级的有效风格变化,送入对应的风格标记层。最后,不同层级风格标记层的输出,就是所得到的当前句子不同层级的风格表征。
多尺度风格预测器
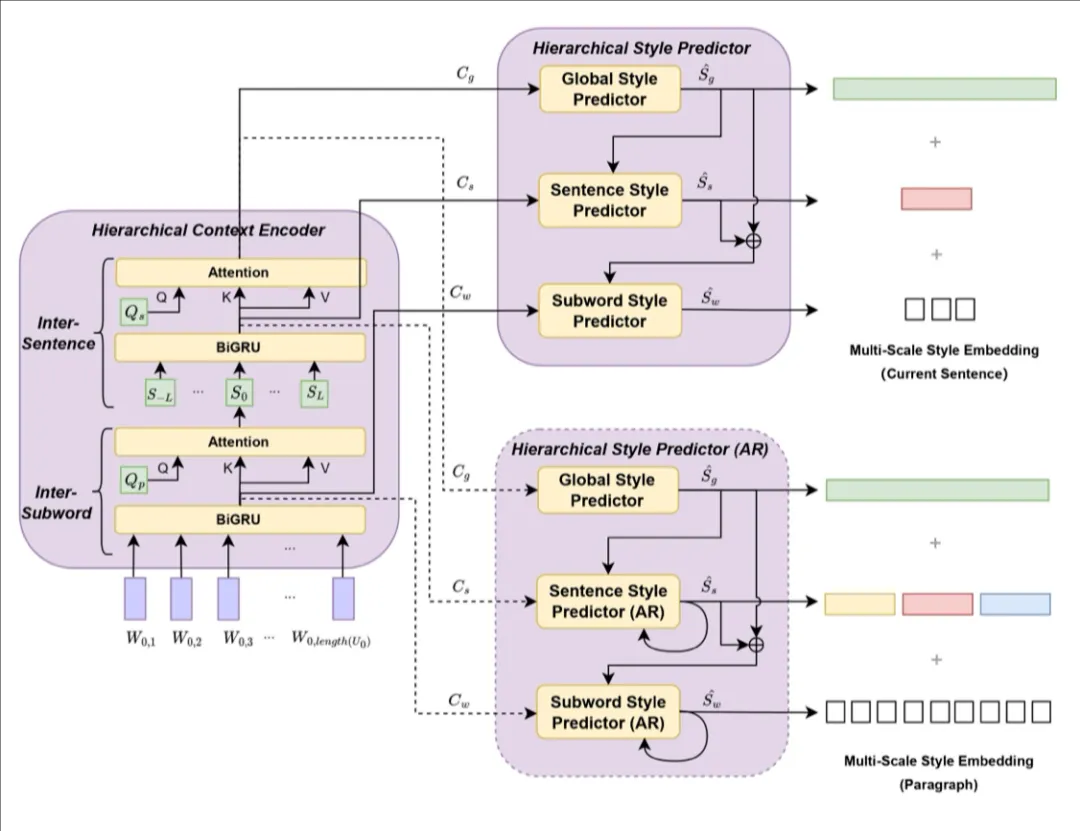
本文结合了预训练的BERT模型、层级上下文编码器和两个层级风格预测器,以从固定数量的上文句子、当前句和下文句子组成的上下文文本中预测多尺度的风格表征。所有的上下文文本先通过预训练的BERT模型获得字级别的语义表征序列,作为层级上下文编码器的输入。层级上下文编码器先后利用字级和句子级的两个注意力网络对上下文的字间关系和句间关系进行建模,得到具有层级关系的段落级别、句子级别和字级别的上下文语义信息。
另一方面,考虑到语音风格自上而下的层次结构,即更接近全局尺度的高层级语音风格会对低层级的语音风格产生影响,为此,本文设计了一种层级风格预测器,通过三个基于残差连接的风格预测器从高层级到低层级依次对语音风格进行建模。具体来说,更接近全局级别的粗粒度风格嵌入由相应级别的风格预测器预测,然后作为条件输入输入到更细粒度的风格预测器中,这与多尺度风格提取器中的残差策略是对称的。
此外,为了直接合成段落级文本输入的语音,本文还额外提出了层级风格预测器的可选扩展。考虑到段落级别语音需要兼顾句子的表现力和句子之间的风格连贯性,该预测器将通过自回归的方式利用过去的风格表征来帮助预测当前的风格表征,被称为层级风格预测器(AR)。
训练和推理
在训练时,为了鼓励模型更好地学习风格表征,本文采用知识蒸馏策略,分三步对MSStyleTTS的参数进行训练。
第一阶段:通过无监督学习的方式联合训练提取器和声学模型。同时,为了避免训练时多尺度风格的学习相互干扰,段落级别、句子级别和字级别的参考编码器和风格标记层将依次训练,当训练其中一个层级的模块时,其余层级的模块被冻结。
第二阶段:利用知识蒸馏策略将知识从提取器转移到预测器。在这一阶段中,首先用提取器提取训练集中每一段语音的多尺度风格表征,并作为目标指导预测器从上下文语义对多尺度风格表征进行预测。这一阶段只训练预测器,其余的模块被冻结。
第三阶段:以较低的学习率联合训练和调优声学模型和预测器,以进一步提高合成语音的音质和自然度。
在对当前句子进行推理时,MSStyleTTS将自动从上下文中推导出多尺度风格表征,并在其帮助下根据当前句子的音素序列生成梅尔谱。在基于段落的推理过程中,MSStyleTTS倾向于使用层级风格预测器(AR),它可以直接预测整个段落的多尺度风格表征。然后,将每个句子对应的多尺度风格嵌入和音素序列送入声学模型,生成每个句子的梅尔谱,并且按顺序将它们组合起来。
实验设置
本文在一个内部的普通话有声读物数据集上进行训练和测试,该数据集包括由专业男性演讲者录制的约87章小说、总时长约30小时的录音。该数据集适合用于表现力语音合成,因为不同语句的风格各不相同,而且每个语句的韵律特征都有明显的波动。此外,为了测试模型在域外数据上的性能,本文从其他不同的有声读物中选择了30个句子及其上下文作为域外实验的评估数据集。
FastSpeech 2:开源实现的FastSpeech 2模型,其架构与本文的声学模型一致。
WSV*:词级风格变化模型。为了进行公平的对比,本文用FastSpeech 2代替原始版本的Tacotron 2作为声学模型,还通过一个额外的双向GRU来考虑上下文信息。因此,它也是一种上下文感知的方法,但是只在词级别对风格进行建模。
HCE:层级上下文编码器模型,它从上下文中预测句子级别的说话风格。
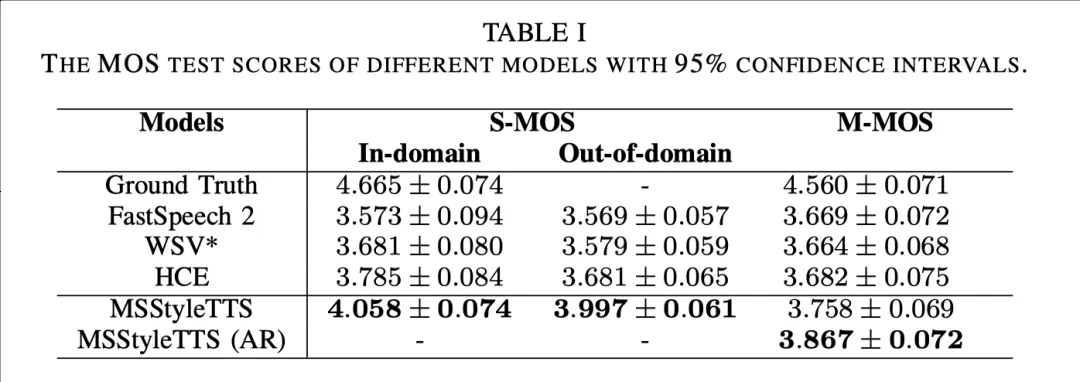
本文比较了不同方法所合成的语音在单句(S-MOS)和多句(M-MOS)上的主观平均意见分,结果如上表I所示。
从S-MOS的结果中可以看到,与FastSpeech 2相比,考虑了上下文信息的三个模型(WSV*、HCE和MSStyleTTS)都表现得更好,说明考虑上下文信息建模说话风格确实有助于表现力语音合成。而在这三个模型中,MSStyleTTS表现最好,这表明虽然两个单一尺度风格基线模型对合成语音的表现力都有不同程度的改善,但通过将它们合并为一个全面的多尺度风格模型,整体性能可以得到显著提高。在域外数据集上,可以观察到每个模型的得分与域内数据集相比都有所下降,而MSStyleTTS的得分仍然最高。这表明本文提出的模型成功地学习了不同层次的风格表征建模,具有鲁棒性和泛化能力。
从M-MOS的结果中可以观察到,FastSpeech 2合成的语音在句子之间的风格过渡相对平滑,但缺乏表现力;而WSV*和 HCE合成的语音则具有丰富的表现力,但句子之间的风格差异很大,这两种情况都导致基于段落的合成表现不佳。本文提出的模型得益于建模了全局级别的风格表征,有更好的表现。此外,在自回归风格预测器的帮助下,MSStyleTTS (AR) 的M-MOS得分进一步获得了提高。这表明,在基于段落的合成中,合成语音的风格一致性对感知质量非常重要。
消融实验
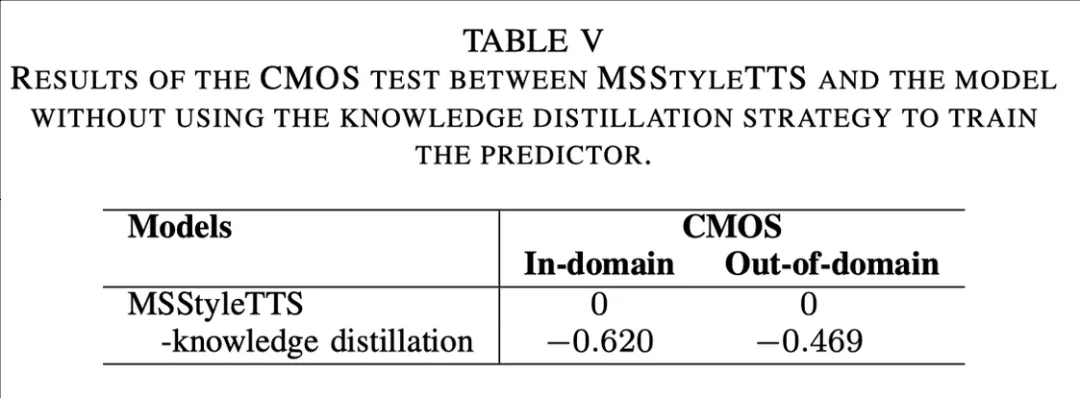
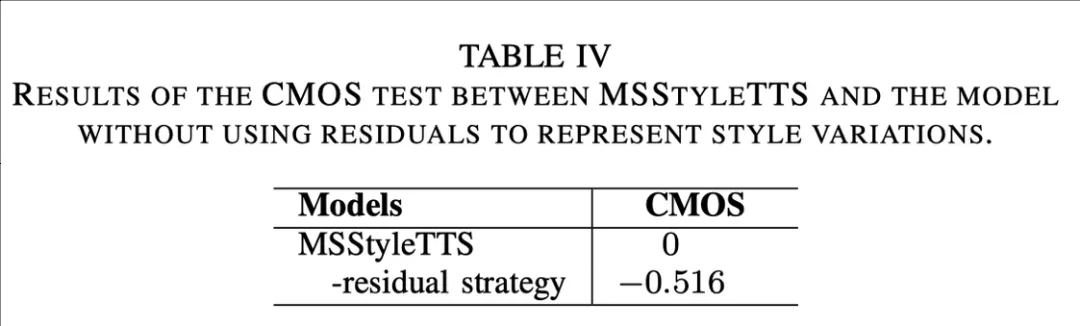
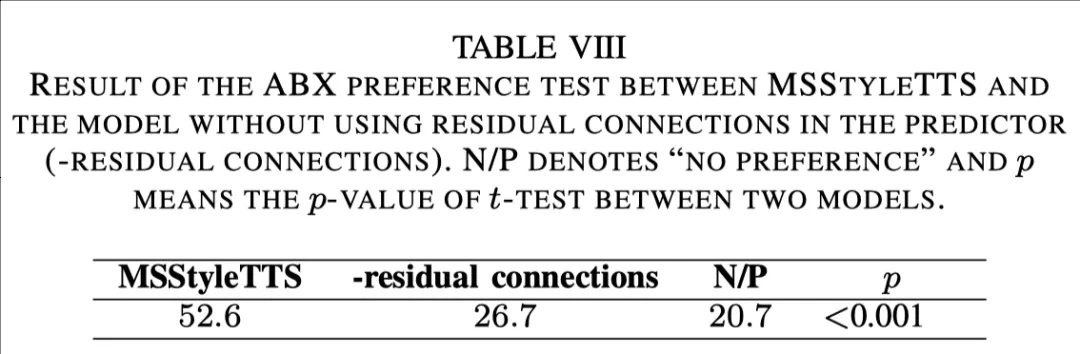
在消融实验中,本文首先探究了知识蒸馏策略(上表V),风格提取时的残差策略(上表IV)以及风格预测时的残差连接(上表VIII)对模型效果的影响。从实验结果可以看出,这三项技术都有助于提升模型的效果。这说明当在进行多尺度的风格建模时,知识蒸馏策略可以帮助预测器更好的训练,残差策略可以通过减少不同层次之间的干扰或冗余部分来促进后续的预测,风格预测时的残差连接可以帮助模型更好的预测细粒度的风格,都是有效的。
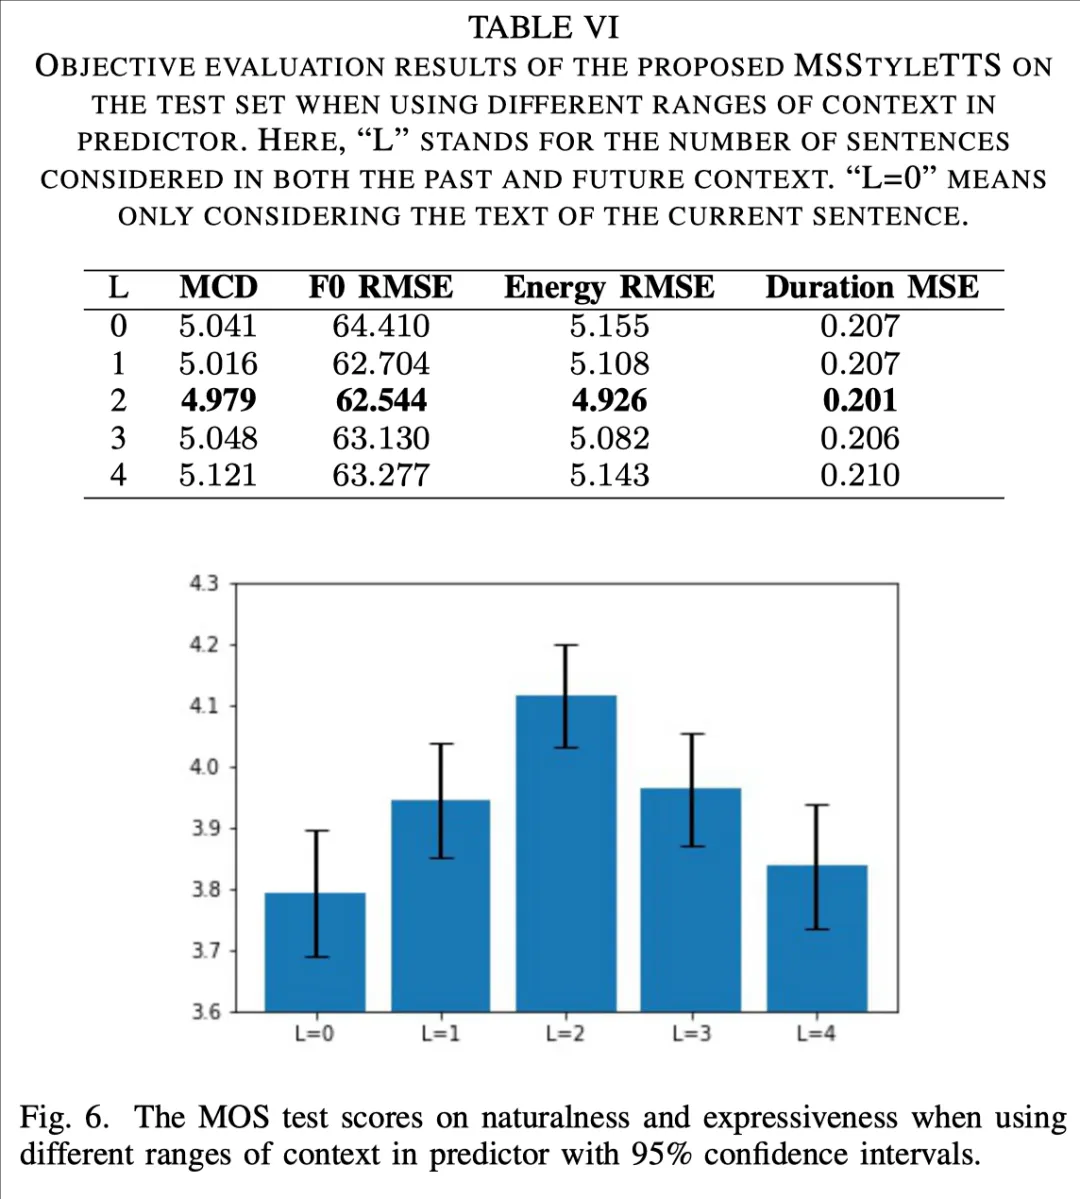
接下来本文进一步探究了考虑的上下文信息范围对风格预测效果的影响(上表VI和图6)。本文用L表示模型分别在上文和下文中考虑的句子数目,通过设置不同的L值,得到了上图所示的实验结果。可以看到,除了只考虑当前句子文本的模型(L=0)和考虑上下文中过多句子的模型(L=4)外,其他模型在表达能力方面都表现良好。当L=2(即上下文中考虑的句子数量为5)时,模型在所有评价指标上都达到了最佳性能,也就是说,相邻句子的上下文信息对语音合成的表现力至关重要,增加上下文信息的范围可以改善语音的韵律表现。但是当上下文中考虑的句子数量大于5个时,合成语音的表现力会随着上下文范围的增大而降低。其原因可能在于与当前句子距离较远的上下文与当前句子的风格相关性较低。
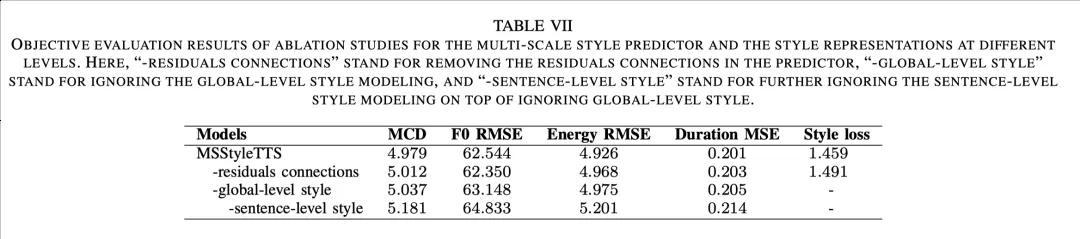
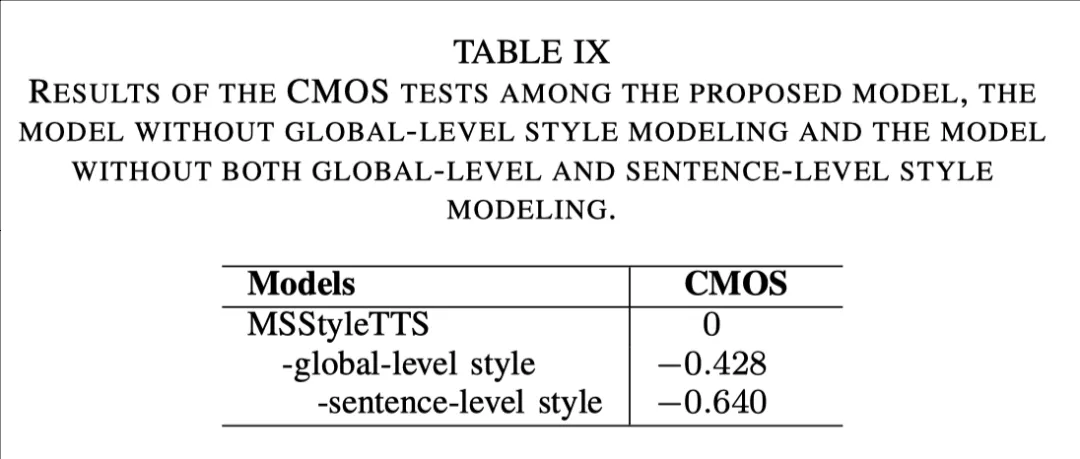
最后,本文比较了全局级别、句子级别和字级别的风格表征的有效性。首先通过删除全局级风格提取模块和预测模块建立了一个消融模型。然后,通过进一步去除句子级模块,即只根据上下文对字级别风格建模,建立了另一个消融模型。可以发现,忽略全局级风格会影响合成语音的感知质量,而进一步忽略句子级风格会使合成语音的感知质量下降得更明显。这再次验证了除了细粒度风格建模(如词级)外,粗粒度风格建模(如句级和全局级)对合成语音的感知质量同样有贡献。
5-结论
