
 THUHCSI人机语音交互实验室
INTERSPEECH 2022
基于多层级上下文信息的中文韵律结构预测
扫码阅读论文:
https://www.isca-speech.org/archive/interspeech_2022/chen22b_interspeech.html
合成样例试听:
https://thuhcsi.github.io/mlc-PSP/
在人对话时,说话人通过在语音的不同位置进行停顿来准确表达语义和意图。中文语音的停顿将中文语音文本分割为不同的韵律成分,分别是韵律词(prosodic word, PW),韵律短语(prosodic phrase, PPH)和语调短语(intonational phrase, IPH)。正确地预测韵律结构对语音合成的自然度和可懂度有重要作用。
现有的韵律结构预测工作将韵律结构预测视为一个序列到序列的分类任务:模型需要预测每个字符后是否存在一个韵律停顿。已有工作尝试使用人工设计的特征、词向量、BERT(bidirectional encoder representation from Transformers)、语法信息作为输入特征,还尝试使用BLSTM-CRF模型、最大熵模型、基于自注意力机制的模型、基于多任务学习的模型进行韵律结构预测。
但是,现有的韵律结构预测模型仍然不能完全建模人类语音的自然度和表现力,尤其是篇章语音的自然度和表现力。一些研究已经揭示,在篇章语音中存在高于句子级别的韵律模式。来自上下文其他语句的文本信息能够提升韵律结构预测的精度。
02 贡献
本文提出了一个基于多层级上下文信息的韵律结构预测模型,其核心是在韵律结构预测模型中引入来自上下文其他语句的文本信息提升韵律结构预测的精度。多层级上下文信息包括了句子内部的文本信息和上下文其他语句的文本信息。为了提取多层级上下文信息,本文设计了一个编码器-解码器结构的韵律预测模型。该模型由一个层级编码器(hierarchical encoder)和一个多任务学习解码器(multi-task learning decoder)构成。其中,层级编码器负责从输入文本的字符级别,句子级别,段落级别提取多层级上下文信息;多任务学习解码器则负责从多层级上下文信息预测韵律词、韵律短语和语调短语。
03 方法
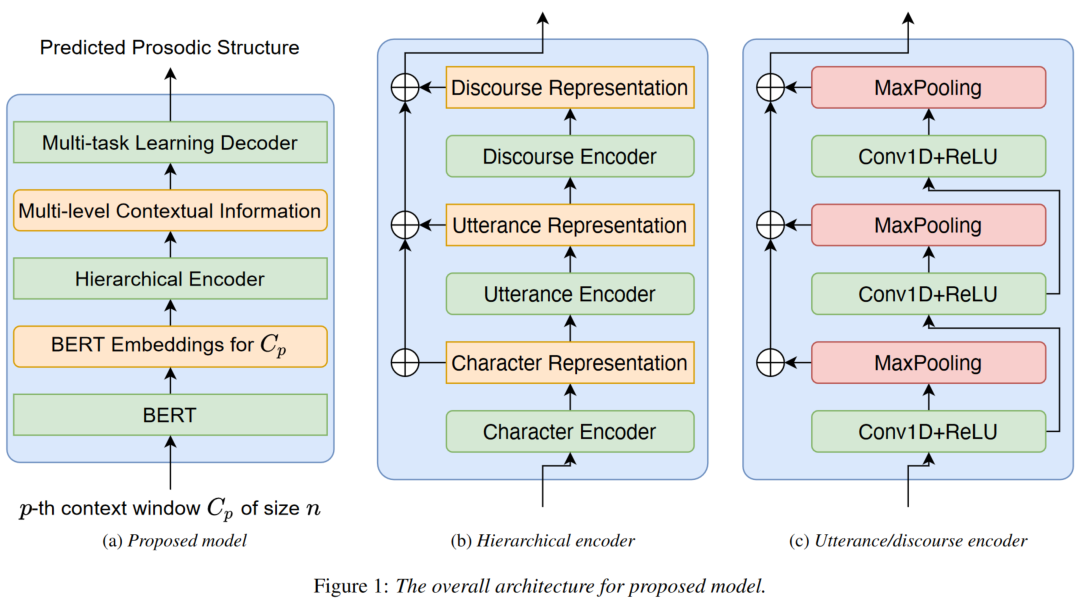
本文提出的模型结构如上图Figure 1(a)所示,它主要包括层级编码器(hierarchical encoder)和多任务学习解码器(multi-task learning decoder)。Figure 1(b)展示了层级编码器的结构。层级编码器负责从输入文本的字符级别,句子级别,段落级别提取多层级上下文信息,它由基于Transformer编码器的字符编码器(character encoder),基于多层卷积的句子编码器(utterance encoder)和段落编码器(discourse encoder)构成。多任务学习解码器则负责从多层级上下文信息预测韵律词、韵律短语和语调短语。Figure 1(c)是句子编码器和段落编码器的结构。
层级编码器
设上下文窗口大小为n。n句连续文本输入模型后,先经过一个预训练的BERT模型将每一句文本独立编码为BERT向量。n句话的BERT向量随后输入到层级编码器中。层级编码器由字符编码器、句子编码器和段落编码器构成。其中,字符编码器由Transformer编码器构成,句子编码器和段落编码器则是一个多层卷积网络。字符编码器负责从每句话中提取字符表征(character representation)。句子编码器负责将每句话的字符表征聚合为单个向量,提取句子表征(utterance representation)。段落编码器则从输入的n句话的句子表征提取段落表征(discourse representation)。段落表征聚合了上下文其他语句的文本信息。字符表征、句子表征和段落表征在对应位置进行拼接,即可得到多层级上下文信息。
多任务学习解码器
多任务学习解码器由三个GRU(gated recurrent unit)网络构成,每一个GRU网络后还有一个全连接层。三个GRU网络分别负责根据多层级上下文信息预测韵律词、韵律短语和语调短语。GRU网络之间还互相共享预测结果,从而建模韵律结构的层级依赖关系。
04 实验
实验数据
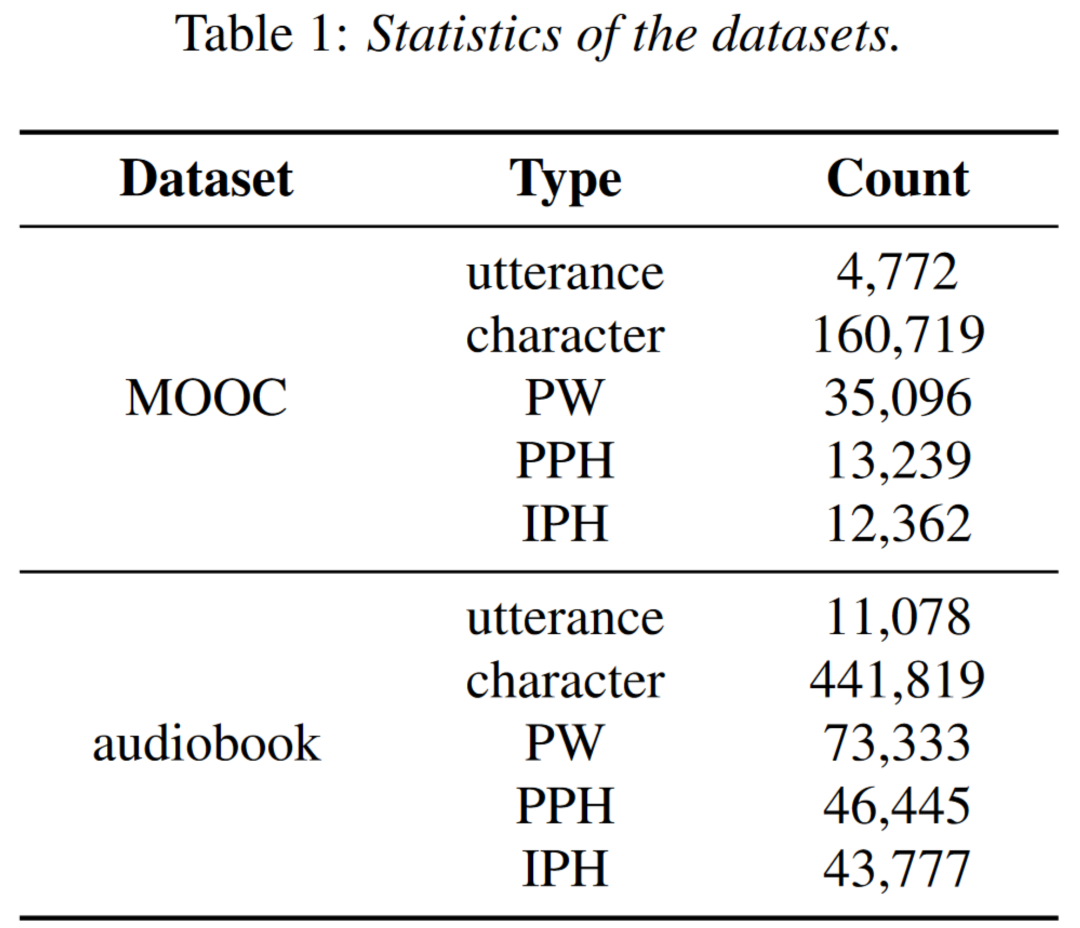
本文准备了两个数据集用以验证本文提出方法的有效性。MOOC数据集是从网络公开课转录而来;audiobook数据集是从有声小说转录而来。两个数据集的标注都经过人工校对。Table 1是两个数据集的统计信息。
基线模型
BLSTM-CRF:在序列标注任务上取得较好效果的BLSTM-CRF模型。
Transformer:由数个Transformer Encoder Block构成的模型。
对比实验
为验证本文所提出的基于多层级上下文信息的中文韵律结构预测模型的有效性,我们分别通过客观评测和主观评测对各个模型进行了比较。其中,客观评测选取韵律词,韵律短语和语调短语的F1 score作为评测标准。主观评测采用ABX测试。Table 2展示了客观实验结果。Figure 2展示了主观实验结果。
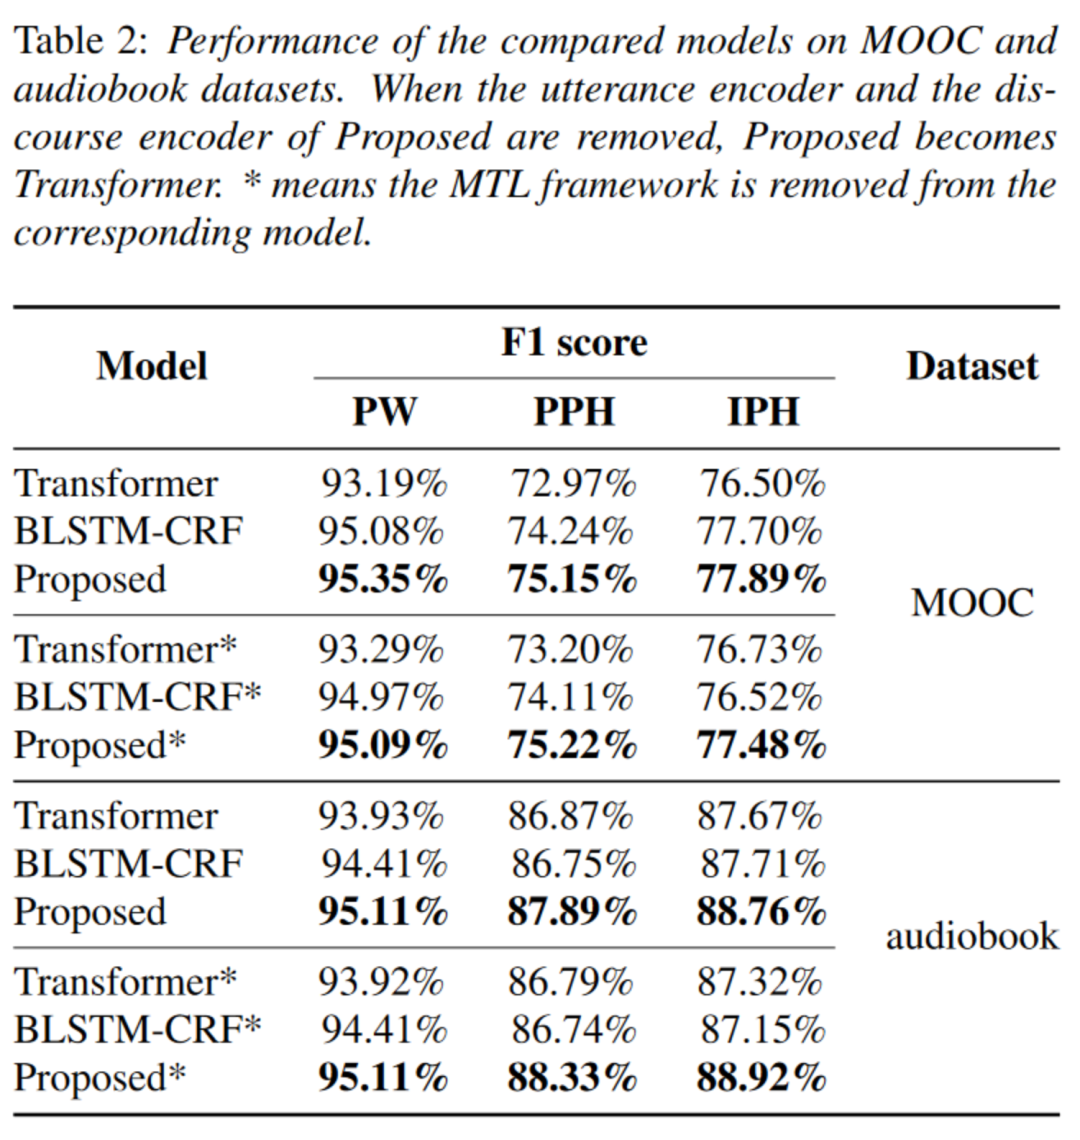
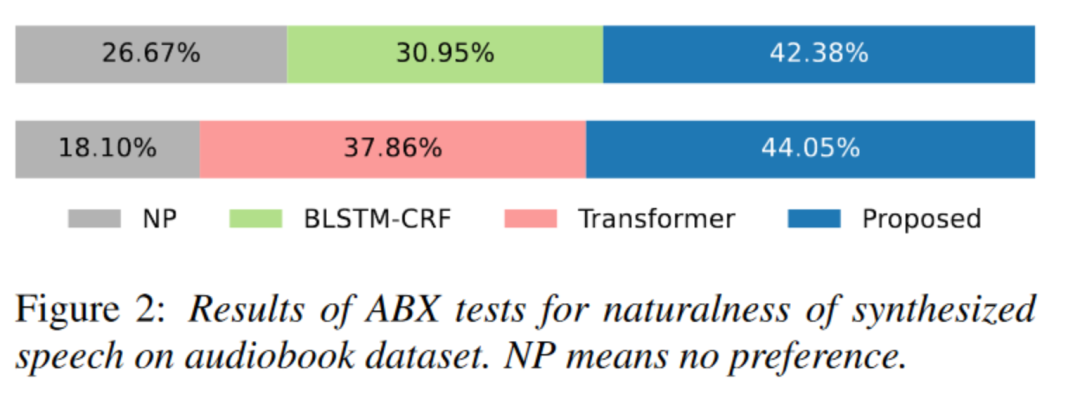
从客观实验结果可以看到,在两个数据集上,无论是否在模型中加入多任务学习,本文所提出的方法在韵律词、韵律短语、语调短语的F1 score上均超过了基线模型。主观实验的结果也说明了,相比基线模型,基于本文所提方法预测的韵律结构可以合成自然度更高的语音。这表明,多层级上下文信息对韵律结构预测的精度提升有重要作用。
上下文窗口大小实验
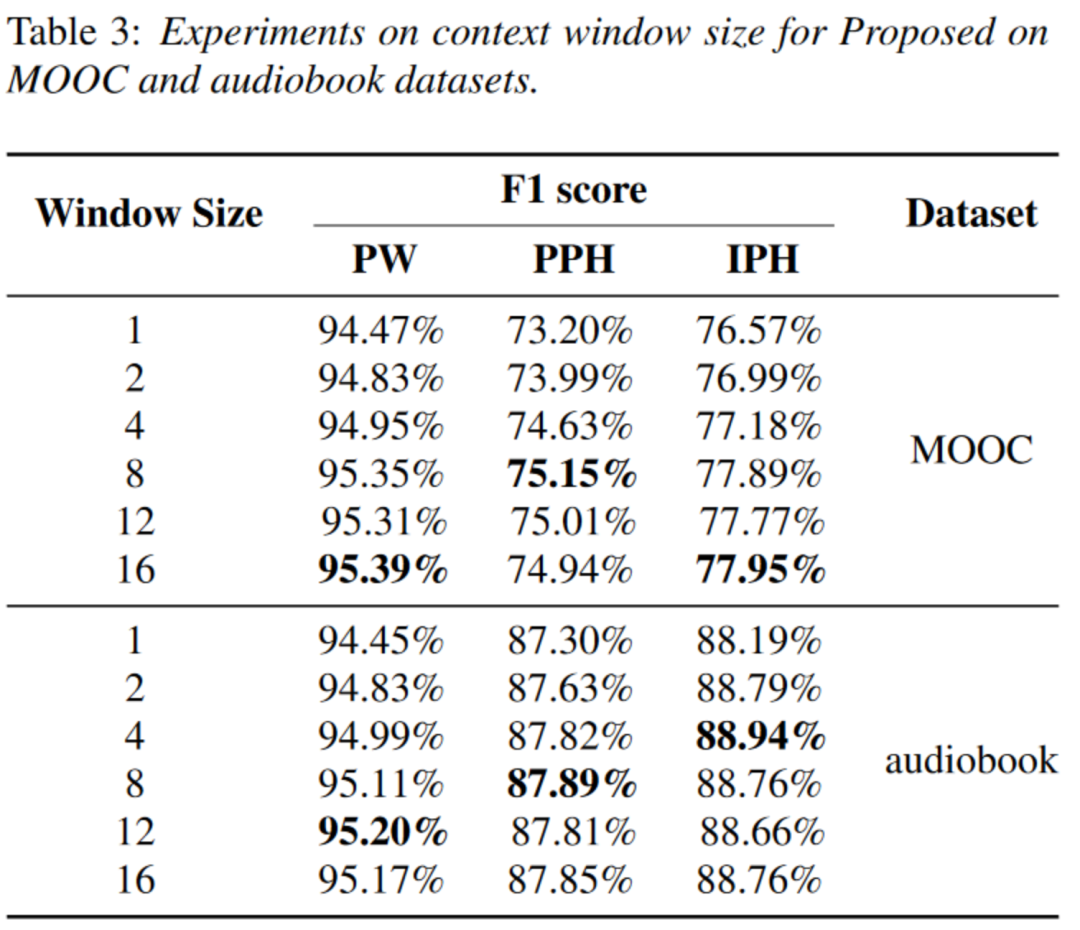
为了找到最合适的上下文窗口大小,本文在两个数据集上对窗口大小进行了实验。可以看到,随着上下文窗口不断增大,模型预测的F1 score也逐渐增大,但是F1 score的增长呈递减趋势。最终,上下文窗口的大小设置为8以平衡计算开销和模型的预测精度。
05 结论
本文提出了一个基于多层级上下文信息的韵律结构预测模型,其核心是在韵律结构预测模型中引入来自上下文其他语句的文本信息提升韵律结构预测的精度。为了提取多层级上下文信息,本文设计了一个编码器-解码器结构的韵律预测模型。该模型由一个层级编码器和一个多任务学习解码器构成。客观实验表明,本文所提出的方法能够提升韵律结构预测的F1 score。主观实验表明,基于本文所提方法预测的韵律结构可以合成自然度更高的语音。
