本文由清华大学与香港中文大学合作,面向电子有声读物的自动智能生成,提出了一种跨说话人的语音风格迁移方法。该方法可以在目标说话人缺乏特定朗读风格数据的真实场景下,通过灵活组合音色和风格表征,将朗读风格迁移至任意目标说话人,并最终合成出整体风格一致的有声读物。主观评测结果表明,所提出的方法在风格迁移结果的音色相似度、风格相似度和音质上,相对基线模型分别提升了 11.4%、4.2% 和 16.2%。

扫码阅读论文

https://www.isca-speech.org/archive/interspeech_2022/li22ca_interspeech.html

合成样例试听

https://thuhcsi.github.io/is2022-cross-speaker-reading-style-transfer/


01 背景动机

基于神经网络的参数式语音合成方法经过不断发展,已经可以生成自然度和音质较好的合成语音,并有了广泛的应用。而在现代生活中的有声读物生成、虚拟个人助理等应用场景中,需要语音合成方法进一步生成能够覆盖多种说话人音色且具有高表现力的语音。但是,真实世界中的高表现力语音数据受限于其对发音人专业能力的高要求和采集过程的高成本,往往只能覆盖少量的音色。为了将具有较高表现力的语音风格,应用到更多的说话人音色上,从而拓宽合成系统应用场景,跨说话人语音风格迁移应运而生。

跨说话人语音风格迁移旨在基于给定的特定语音风格,和训练数据中不包含该类型风格的目标说话人,实现使用目标说话人的音色合成带有该类型风格的语音。
现有的跨说话人语音风格迁移方法,大多基于表现力合成中主流的从参考语音 (reference speech) 中提取语音风格信息的建模范式,并通过使用句子级别的显式风格标签,如韵律类型(prosody class,如读古诗、客服语音)、情感类别(emotion category, 如高兴、愤怒、伤心)等,进行语音风格的建模,并结合对抗训练等方法进行风格与音色表征的解耦,从而实现跨说话人的语音风格迁移。
然而,有声读物等自然朗读得到的高表现力人类语音数据,相比较按照句子级别风格标签逐句录制得到的语音数据,往往具有更高的风格自由度和多样性,使得其单句上的风格较难通过固定的风格类别来进行准确标注,从而无法直接使用现有方法进行跨说话人语音风格迁移。相应的,本文根据对有声读物语音的数据观察,提供了一种从多尺度 (multi-scale) 视角出发的朗读风格解构:
1.局部尺度上 (local-scale),存在紧贴情节递进而产生的丰富节奏、语调等韵律变化(prosody variation);
2.全局尺度上 (global-scale),存在基于读物主题而总体统一的整体风格类型 (genre),用于营造整段朗读内容的氛围和谐感。


02 贡献

本文基于上述数据观察,面向有声读物数据上的跨说话人风格迁移任务,提出了块级多说话人多尺度参考风格编码器(Chunk-wise multi-speaker multi-scale reference encoder),依托多尺度的表征进行层级化的语音风格建模,并在全局尺度上基于语句块输入进行表征整合,提高建模结果稳定性和准确性。并特别设计了可切换对抗分类器(Switchable adversarial classifier, SAC),用于在风格迁移场景中常见的[风格类型-说话人身份] (genre-speaker) 标签组合覆盖不完全的训练数据上,对参考风格编码器所提取的说话人音色表征和风格类型表征进行解耦。


03 解决方案
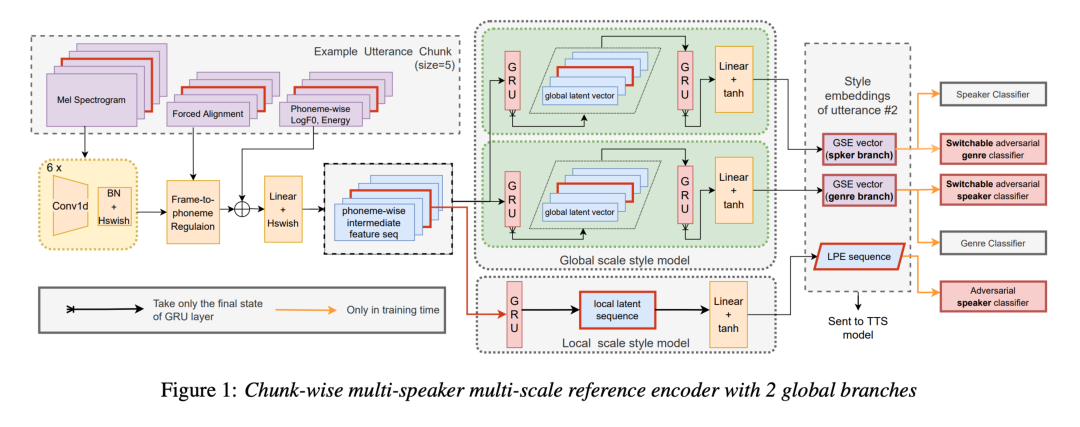

本文基于 Tacotron2 语音合成框架,使用上述块级多说话人多尺度参考风格编码器从参考语音中提取多尺度风格表征,作为声学模型解码器的额外输入条件,形成一套多说话人表现力合成系统。特别地,训练阶段会加入分类器(含可切换对抗分类器)来辅助风格表征空间的学习与解耦。

块级多说话人多尺度参考风格编码器

该参考风格编码器首先将输入的帧级别参考语音声学特征通过6层1维卷积网络,并基于强制对齐工具 (forced alignment) 预处理得到的音素时长信息进行整合得到音素级表征,随后拼接上音素级基频、能量信息,并通过线性输出层得到音素级中间表征(phoneme-wise intermediate feature sequence)序列。该表征随后被分别应用到不同尺度的风格模型上作为共享输入:
1.局部尺度风格模型 (local scale style model)将该输入序列通过一层门控反馈单元 (gated recurrent unit, GRU) 和 线性输出层得到最终的局部韵律表征 (local prosody embedding, LPE)序列,用于对局部韵律起伏的建模;
2.全局尺度风格模型 (global scale style model)将该输入分别送入具有同种网络结构的两个网络分支 (branch) 中,并分别得到一个全局风格表征 (global style embedding, GSE)向量,用于对说话人音色 (timbre)和整体风格类型 (genre)的建模。
具体地,在后者的每个分支上,输入的音素级中间表征首先通过一层 GRU 并取出最后一个时间步上的输出向量,随后,同一个块 (chunk)内多个语句上的输出向量被首尾相连,组成的序列通过另一层 GRU 并取最后一个时间步输出向量,最终再通过线性输出层后得到 GSE 向量。实际运行中,语句块的划分依据有声读物数据集的文本段落划分结果而定,而基于块对风格表征进行整合,是为了平滑相邻句子之间的文本、韵律差异带来的表征误差,同时提供更大的模型感受野,最终达到更好的建模结果。
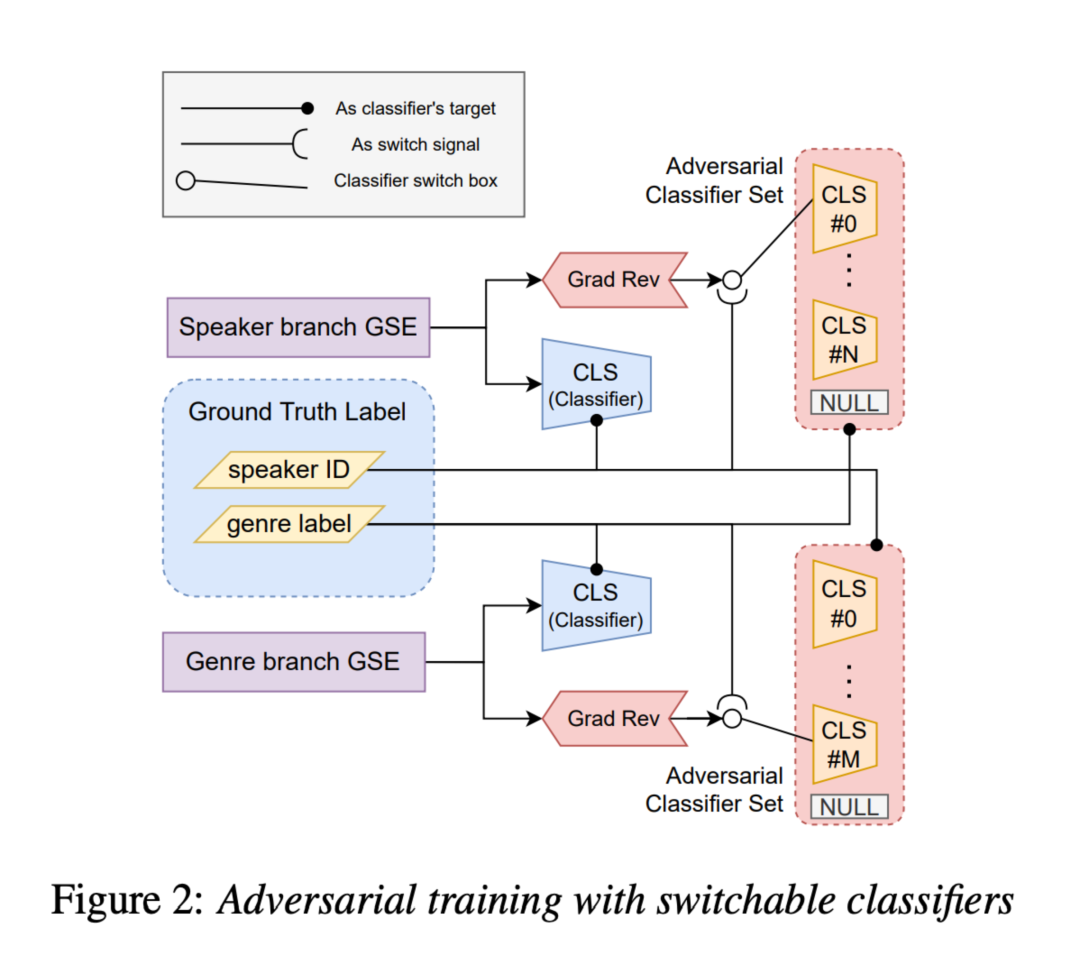
为了辅助风格表征的学习,参考风格编码器输出的 LPE 序列将同时被送入基于梯度反转层的对抗说话人分类器中,剔除说话人信息;而 timbre / genre 分支上的 GSE 向量,则将分别被送入 timbre / genre 分类器,和可切换的 genre / timbre 对抗分类器,用于得到解耦后的 timbre / genre 表征,从而支持基于表征组合的跨说话人风格迁移。

可切换对抗分类器 (SAC)


相比较传统方法中使用单个对抗分类器来进行表征的解耦,本方法中面向跨说话人风格迁移任务中常见的标签覆盖不完全数据场景,特别设计了可切换的对抗分类器。由于训练数据中标签组合覆盖不完全,特定的 genre 类别可能只出现在某个或者少数几个 speaker 的数据上,同理,单个 speaker 的数据中也往往只包含一到两种 genre,因而,使用单个对抗分类器来对各类 genre / speaker 标签进行解耦,会不可避免地导致信息泄露,并最终破坏解耦效果。而所提出的可切换对抗分类器通过初始化一组对抗分类器,并为每个标签指定其专属的对抗分类器来避免上述问题。具体实现上,即每个 speaker 会被分配其专属的对抗 genre 分类器,而每个 genre 会被分配其专属的对抗 speaker 分类器。


04 实验验证

实验数据与设置

本文在包含多个不同类型数据的中文普通话数据集上进行了验证实验:
1.Audiobook_FM: 包含 8 名说话人的私有 24.3 小时有声读物数据,共有童话故事、武侠小说两种 genre 标签,合计 1,315段(13,718句)。其中一名男性说话人和一名女性说话人的数据覆盖了两类读物,其他说话人的数据只覆盖其中一种;
2.DB:包含 1 名女性说话人的私有中性 TTS 数据 10,000句,该说话人同样出现在 Audiobook_FM 数据中,朗读了童话故事类型的文本;
3.MST-Originbeat: ICASSP 2021 M2VoC challenge 提供的开源中性 TTS 数据,包含一男一女两名说话人,各自 5,000 句。
所形成的混合数据集中合计包含10名说话人,3种整体风格类型(童话故事 fairy tale、武侠小说 martial arts fiction、中性 neutral)。其中,将后两个普通中性 TTS 数据集应用到本文提出的块级参考风格编码器上时,由于数据文本中没有连续的语句段,在块的采样方法上采取了在同一说话人数据内进行随机抽样10句进行组合的方法。
在训练策略上,我们采用了前继工作中所提出的两段式训练方法 [2] 来避免不同尺度的风格模块在训练上的互相干扰:
1.第一阶段去除参考风格编码器中的全局风格模块,只训练局部风格模块,对于说话人信息的建模任务,则指定了一个随机初始化的临时 embedding table ;
2.第二阶段去除临时的说话人 embedding table ,引入全局风格模块,冻结训练好的局部风格模块和TTS 框架中的文本编码器,重新初始化 TTS 框架中的解码器,继续训练。
具体细节上,本文中第一阶段训练了 380,000 步,第二阶段训练了 260,000 步;至于后端波形生成工具,则统一使用了一个预训练好的 HiFi-GAN Vocoder [3]。

风格迁移方法

训练完毕后,可以通过多尺度风格表征向量的组合来实现跨说话人的朗读风格迁移。具体操作上,如果希望将童话故事朗读风格从说话人 A 迁移给 B,即可使用所提出的参考风格编码器,从提供风格参考的说话人 A 朗读童话故事的音频中提取 LPE 序列和 genre GSE 向量,从提供音色参考的说话人 B 朗读任意风格类型的音频中提取 timbre GSE 向量,将其组合后指导 TTS 框架合成出说话人 B 朗读童话故事风格的音频。

基线模型

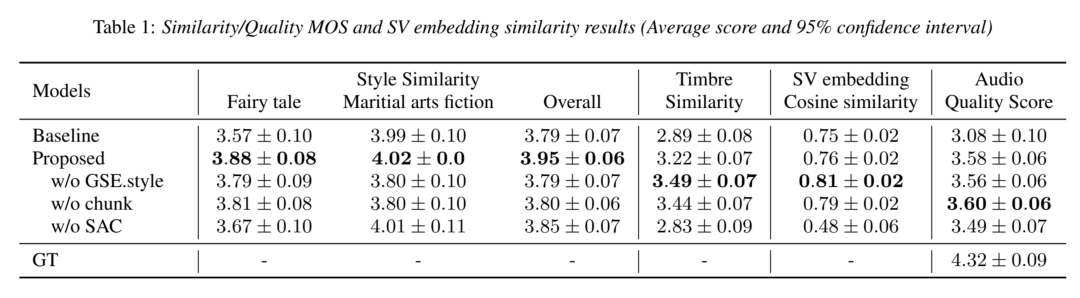
作为对比,我们保留相同的模型框架,而将所提出的多尺度参考风格编码器中全局风格模块的两个分支替换为了基于 embedding table 的传统方法得到了基线模型。其在风格迁移结果的风格、音色相似度和音质的主观评测结果上,以及基于说话人认证(speaker verification, SV) 模型的音色相似度客观评价上,均逊色于所提出的模型 (Proposed),证明了所提出的方法在跨说话人风格迁移任务上的有效性。

消融实验

为了逐个说明所提出模型中各模块设计的有效性,本文进行了如下剥离实验进行分析:
1.去除全局风格模块中建模 genre 的分支,发现风格迁移结果的风格相似度主观评测指标明显下降(上表),表明在全局尺度上显式建模有声读物整体风格类型的必要性;但音色相似度略有上升(上表),这是因为该配置下全局风格模块不再同时肩负 风格-音色 解耦任务,只专注于说话人音色建模;
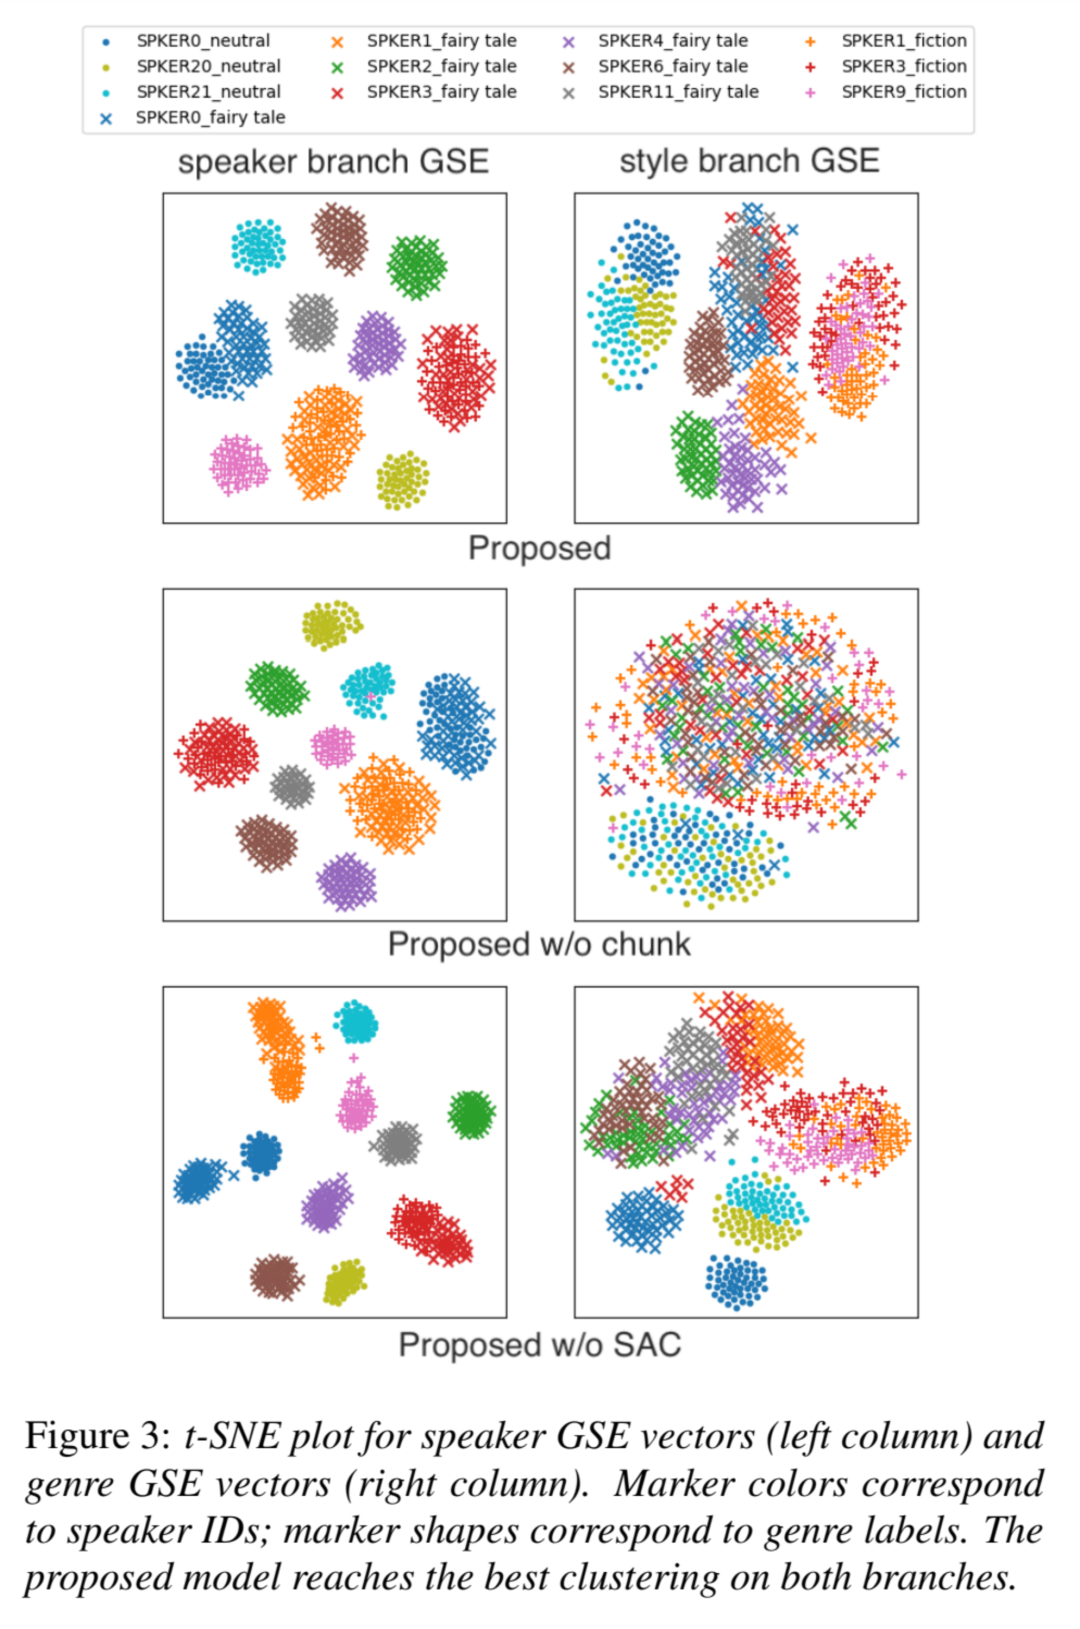
2.将全局风格模块中基于块级输入的建模方法替换为了基于句子级输入的传统方法,发现风格迁移结果的风格相似度主观评测指标明显下降(上表),且所提取的 genre GSE 向量可视化结果中不同genre 类别对应的 GSE 存在混杂(下图),这说明模型感受野缩小为句子级别后,风格建模准确性出现了下降,验证了基于块级输入进行表征整合的优势;
3.将所提出的可切换对抗分类器替换为传统的对抗分类器,所得结果中风格迁移的音色和风格相似度均出现了严重下降(上表),且所提取的 speaker GSE 向量可视化结果中同一说话人数据下仍出现了按照 genre 类别聚类的现象(下图),存在明显的信息泄漏,证明了所提出的可切换对抗分类器在标签覆盖不完全数据上改善解耦效果的有效性。


05 结语

本文针对解决表现力语音合成数据音色较少问题的跨说话人风格迁移任务,面向有声读物等自然朗读、缺乏句子级别风格类别标注的数据,提出了块级多说话人多尺度参考风格编码器以及可切换对抗分类器,分别来进行说话人音色和风格的建模与解耦。实验结果表明所提出的参考风格编码器对于有效提高风格迁移结果中风格相似度,而所设计的可切换对抗分类器在标签组合覆盖不完全的训练数据上显著改善了解耦过程中的信息泄漏问题,最终成功实现了跨说话人的朗读风格迁移。


主要参考文献:

[1] Q. Xie, X. Tian, G. Liu, K. Song, L. Xie, Z. Wu, H. Li, S. Shi, H. Li, F. Hong, H. Bu, and X. Xu, “The multi-speaker multi-style voice cloning challenge 2021,” in ICASSP 2021 - 2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 2021, pp. 8613–8617.

[2] X. Li, C. Song, J. Li, Z. Wu, J. Jia, and H. Meng, “Towards MultiScale Style Control for Expressive Speech Synthesis,” in Proc. Interspeech 2021, 2021, pp. 4673–4677.

[3] J. Kong, J. Kim, and J. Bae, “Hifi-gan: Generative adversarial networks for efficient and high fidelity speech synthesis,” in Advances in Neural Information Processing Systems, 2020.