
 西工大音频语音与语言处理研究组
随着语音技术的不断发展,在诸如会议转录和语音助手等各种应用中,大家对对话语音接口的需求出现了迅速增长。我们需要在现有语音系统的基础上,进一步拓展其对对话语音的识别能力。对话语音有其独有的特征,如角色偏好(role preferences)和局部连贯性(topical coherence)等。具体来说,上述特征是指对话时,不同说话人对某些词和短语出现概率的影响,以及话题和话语结构对相邻句子中语义相关词共现的影响[1,2]。先前的研究表明,在待识别的语音中加入上文内容可以显著提高对话语音识别的性能[3]。
最近,西工大音频语音与语言处理研究组(ASLP@NPU)与马上金融合作的论文 “Conversational Speech Recognition by Learning Audio-Textual Cross-Modal Contextual Representation” 在语音研究领域顶级期刊IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP)上发表,该论文针对上述问题开展了深入研究。具体来说,为了更好的识别对话语音,在之前[4,5]工作的基础上,我们引入文本-语音跨模态对话表征来增强对话ASR系统对上文的利用能力。利用跨模态提取器,将预训练的语音和文本模型结合起来,同时使用CVAE模型来隐式地传递上文信息,避免显式误差传递。现对该论文进行简要的解读和分享。
发表论文截图
语音识别(ASR)通常以句为单位进行模型训练。然而在对话这种长音频中,利用对话的特征和更长的上文内容有助于对当前句语音的识别[1,2,3]。近期对对话语音上文的利用仍存在着一些局限性,如训练与解码时内容的不匹配,上文信息的误差传递,冗余信息过多等问题。本文结合了Conditional Variational Autoencoder(CVAE) 方法[5]和跨模态表征[4]方法,采用跨模态特征在较长的上文中提取对话级表征,隐式利用上文信息,从而避免了过长的文本信息带来的错误传播问题。跨模态提取器和CVAE方法技术细节可以参考下面的推文。
提出了一个新的对话ASR方法,它集成了跨模式表征和CVAE模块,增强了模型利用对话中上下文信息的能力。 该方法显著降低了对话ASR的识别错误率,在HKUST和MagicData-RAMC数据集上分别实现了8.8%和23%的相对CER降低。 考察了不同预训练模型和上文输入长度对对话语音识别性能的影响,通过实验分析得到了最优的CVAE输入配置。
本文对话ASR模型由一个Conformer编码器、一个跨模态提取器、一个对话表征提取器和一个conditional解码器组成。如图1所示,在训练时,语音预训练模型提取的特征将同时被输入到跨模态提取器和Conformer编码器中。然后将上下文跨模态表征输入到CVAE模块,生成两种对话表征,即局部连贯性表征和角色偏好表征。通过条件解码器,将这两种对话表征集成到语音识别解码过程中,最终帮助语音识别模型获得对话上下文信息。
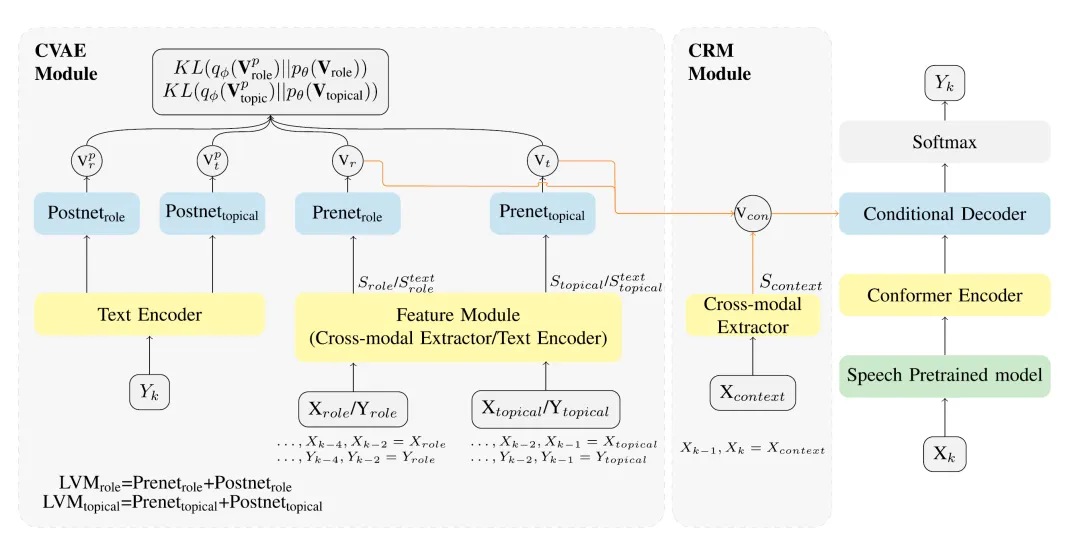
图1基于跨模态表征的对话语音识别框架
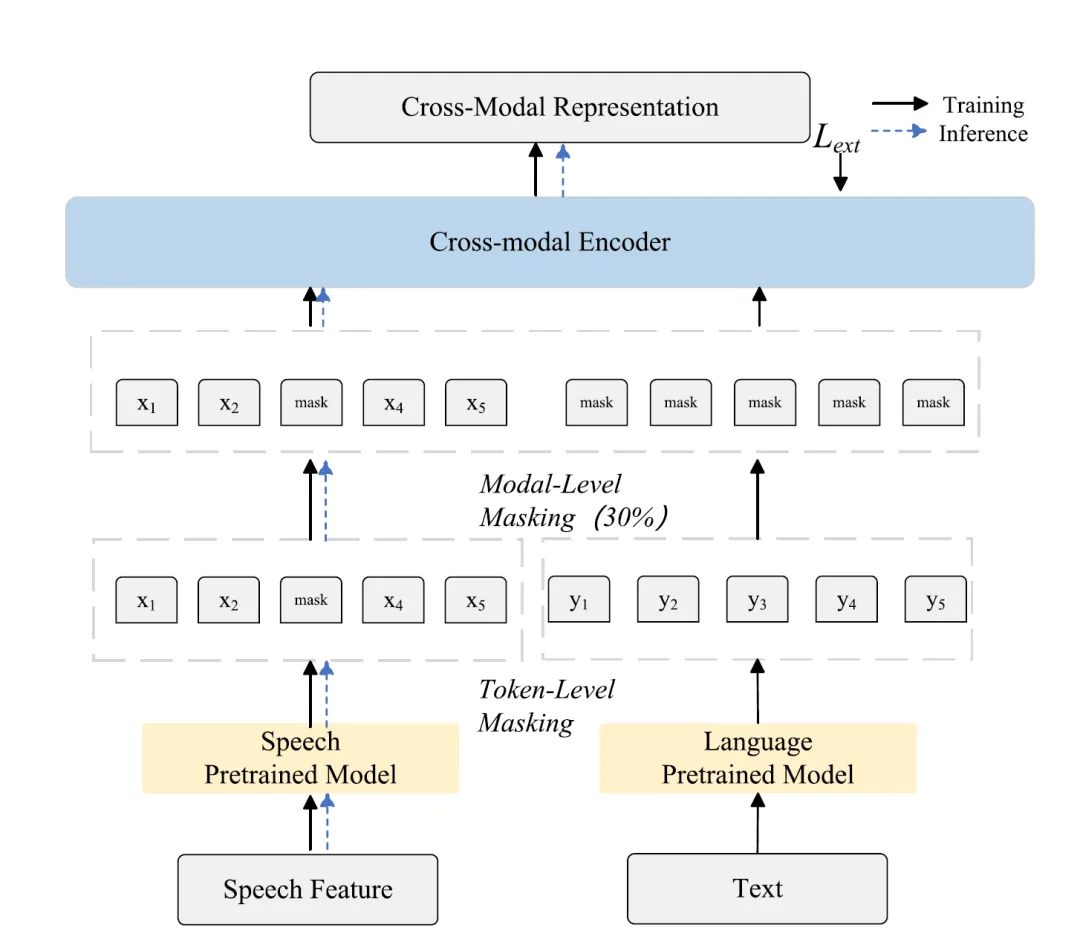
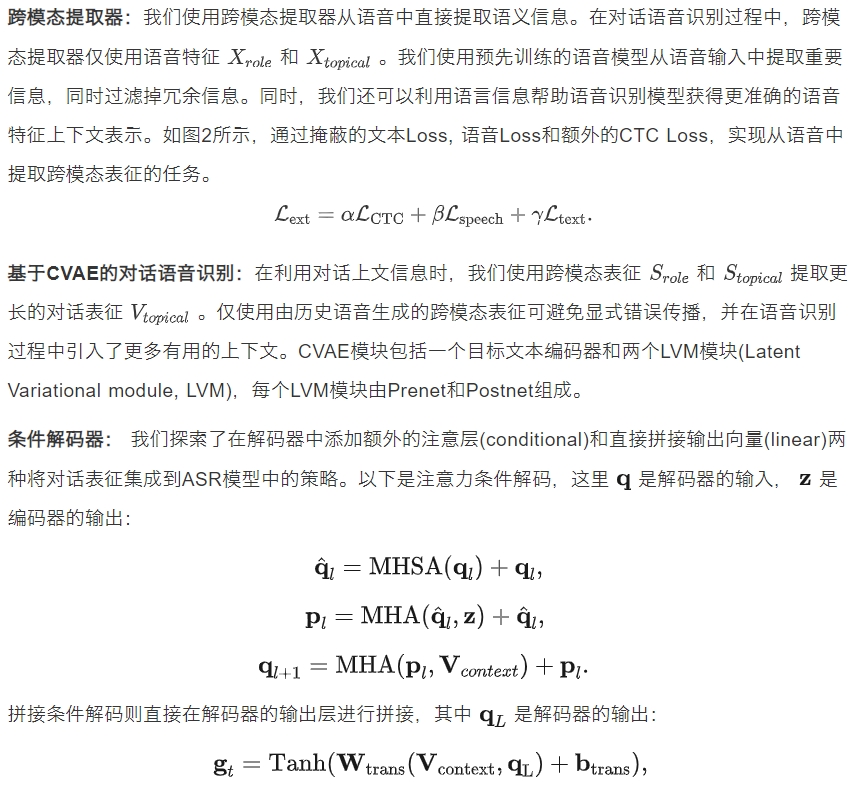
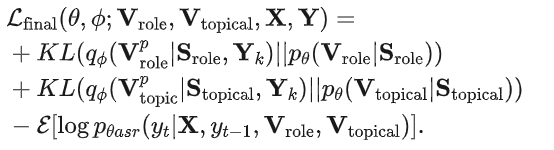
表1不同对话语音识别模型的识别结果(CER%)
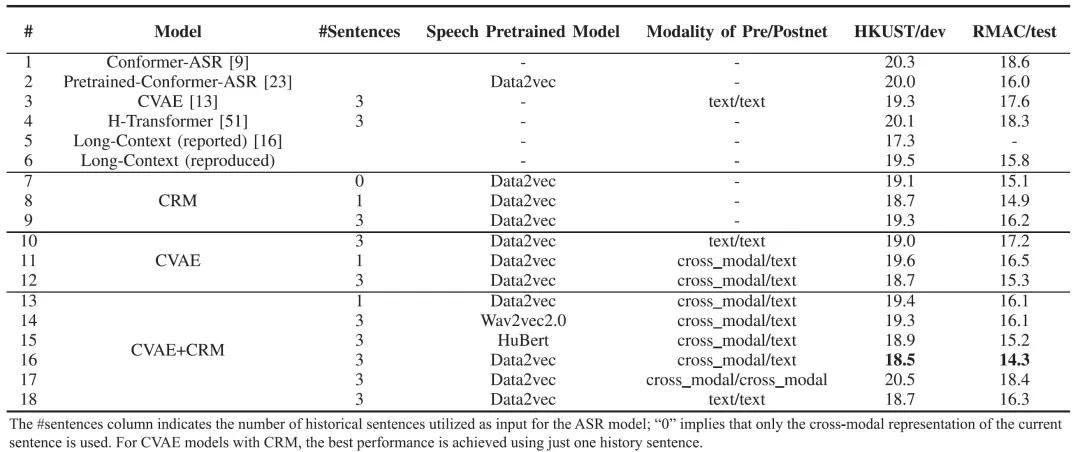
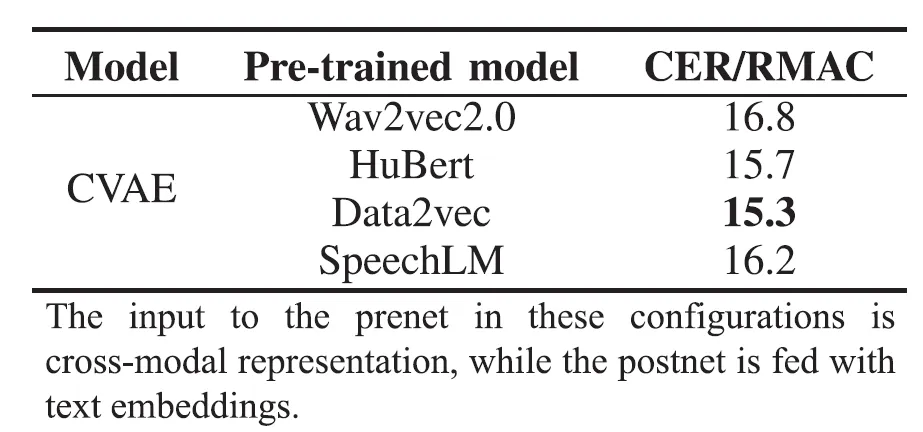
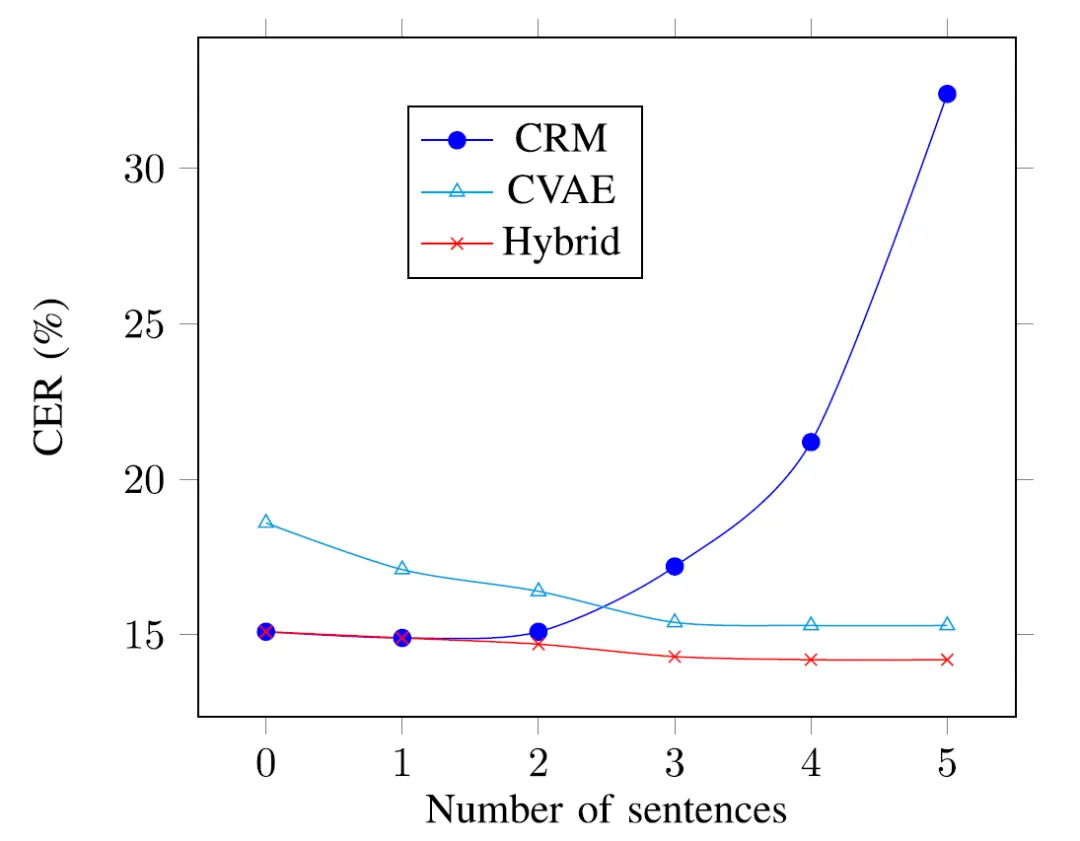
图3 上文长度对识别结果的影响
[1] Y. Liang, F. Meng, Y. Chen, J. Xu, and J. Zhou, “Modeling bilingual conversational characteristics for neural chat translation,” in Proc. Assoc. Comput. Linguistics, 2021, pp. 5711–5724.
[2] W. Xiong et al., “Toward human parity in conversational speech recognition,” IEEE/ACM Trans. Audio, Speech Lang. Process., vol. 25, no. 12, pp. 2410–2423, Dec. 2017.
[3] S. Kim, S. Dalmia, and F. Metze, “Cross-attention end-to-end ASR for two-party conversations,” in Proc. Interspeech, 2019, pp. 4380–4384.
[4] K. Wei, Y. Zhang, S. Sun, L. Xie, and L. Ma, “Conversational speech recognition by learning conversation-level characteristics,” in Proc. IEEE Int. Conf. Acoust., Speech, Signal Process., 2022, pp. 6752–6756.
[5] K. Wei, Y. Zhang, S. Sun, L. Xie, and L. Ma, “Leveraging acoustic contextual representation by audio-textual cross-modal learning for conversational ASR,” in Proc. IEEE Int. Symp. Circuits Syst. Interspeech, 2022, pp. 1016–1020.
[6] Z. Yang et al., “Open source magicData-RAMC: A rich annotated mandarin conversational (RAMC) speech dataset,” in Proc. Interspeech, 2022, pp. 1736–1740.
[7] Y. Liu, P. Fung, Y. Yang, C. Cieri, S. Huang, and D. Graff, “HKUST/MTS: A very large scale mandarin telephone speech corpus,” in Proc. 5th Int. Symp. Chin. Spoken Lang. Process., 2006, pp. 724–735.
[8] Zhang, Z., Chen, S., Zhou, L., Wu, Y., Ren, S., Liu, S., Yao, Z., Gong, X., Dai, L., Li, J. and Wei, F, “SpeechLM: Enhanced speech pre-training with unpaired textual data,” IEEE/ACM Trans. Audio, Speech, Lang. Process., vol. 32, 2024,pp. 2177–2187.
