
 西工大音频语音与语言处理研究组
论文题目:Unveiling the Potential of LLM-Based ASR on Chinese Open-Source Datasets
作者列表:耿雪龙,徐天翼,魏坤,穆秉甡,薛鸿飞,王贺,李泱泽,郭鹏程,戴宇航,李龙豪,邵明辰,谢磊
论文预印版:https://arxiv.org/abs/2405.02132
大语言模型(LLM)在人工智能领域扮演着重要角色,特别是在理解和生成人类语言的能力方面表现突出。研究人员利用LLM的优势,探索将其与语音识别(ASR)等技术相结合的可能性,并已在多个应用场景中取得显著成效。ASR是同时依赖于声学和语言建模的任务,常用的语言模型包括n-gram和神经网络语言模型(NNLM)[1]。当下,LLM在训练数据规模和模型尺寸上的优势,为ASR的语言建模提供了新的尝试机会。
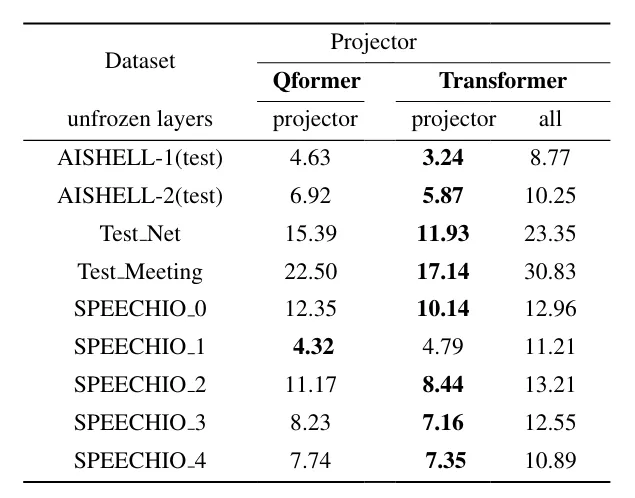
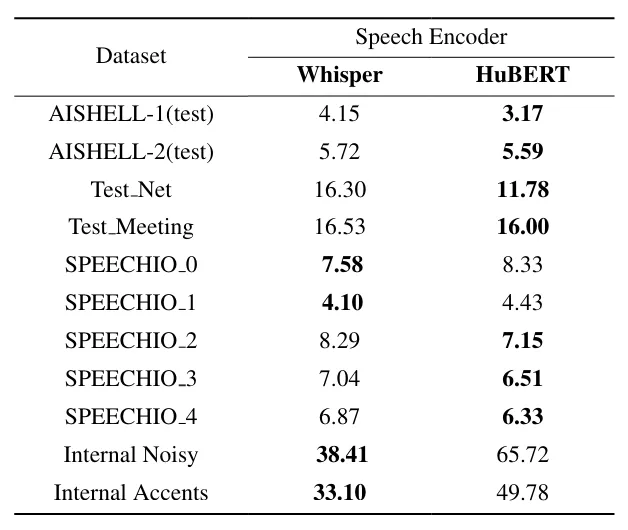
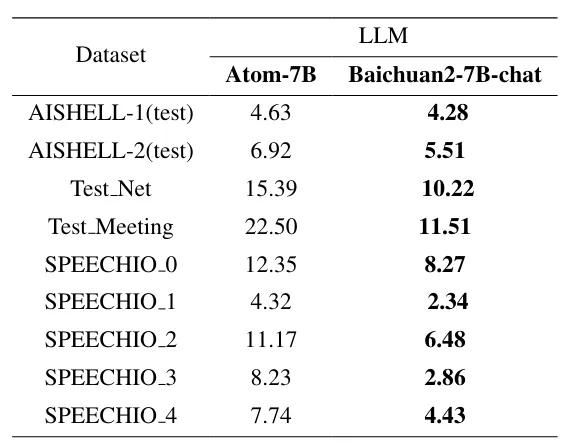
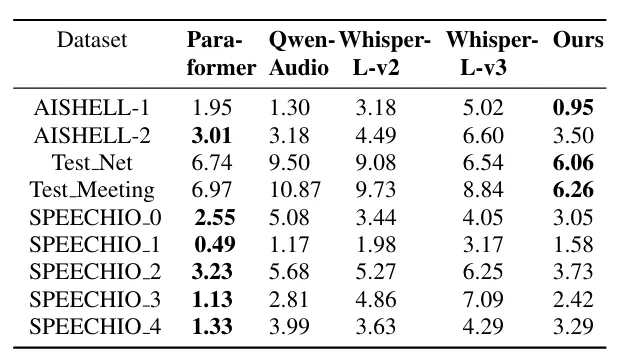
语音编码器:Whisper在鲁棒性方面表现优异,但相较于HuBERT[6]的可塑性较低。 连接层:在中文语音识别任务上,Transformer作为连接层的能力超过Qformer。 LLM:LLM集成的ASR系统在中文语音识别上的性能与LLM本身在中文任务上的表现正相关。 训练方法:三阶段训练策略整合了语音基座模型的预训练声学建模与语言建模能力,并使得我们模型最终在AISHELL-1、Test_Net和Test_Meeting测试集上取得了SOTA性能。
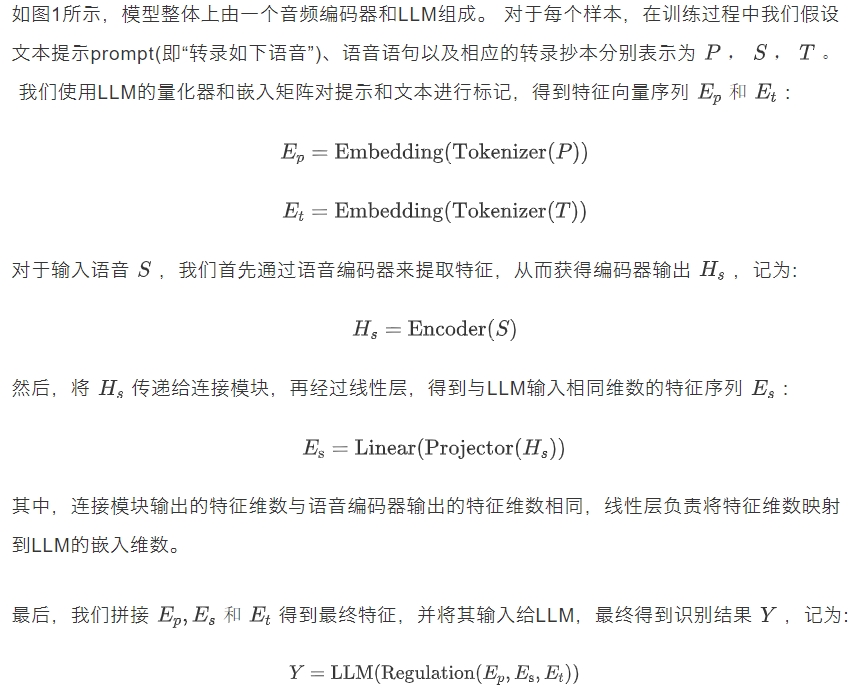
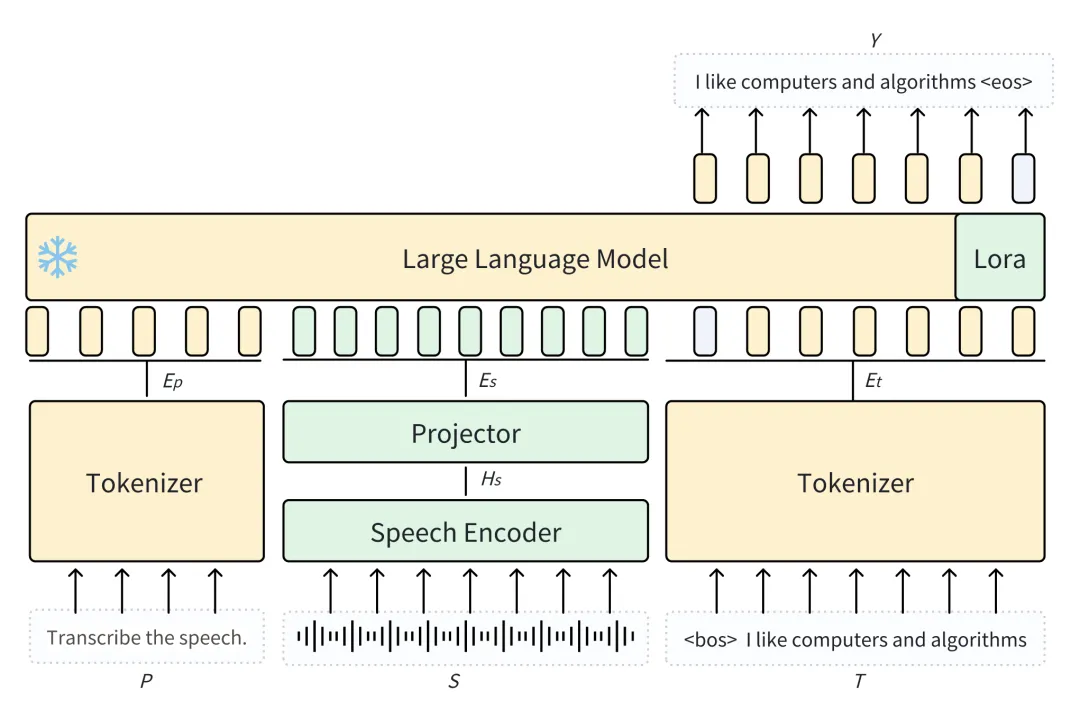
实验数据
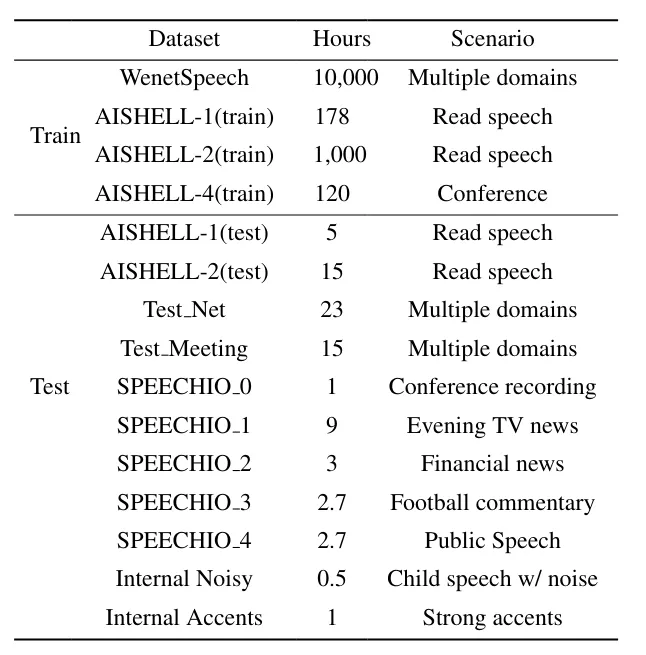
训练数据用WenetSpeech(10000小时), AISHELL-1(178小时),AISHELL-2(1000小时), AISHELL-4(120小时)。在9个公开测试集和2个内部挑战测试集上分别进行了测试。具体数据情况如表1所示。
训练策略
我们引入了一个三阶段的训练策略,以增强模型对齐声学和文本信息的能力。最初,我们尝试在训练过程中同时解冻语音编码器、连接模块和LLM的LoRA矩阵。但是这导致了模型收敛失败,最后的性能较差,如表2所示。我们猜测这是因为我们的数据集与用于训练编码器和LLM的数据相比相对较小,这导致LLM中的语音和文本表示之间的不匹配。本文利用一种三阶段训练方法来缓解这个问题:首先只训练连接模块,冻结所有其他组件,旨在训练连接模块使其在声学和文本模态之间快速对齐。其次,我们解冻编码器,只关注编码器,这使语音编码器适应我们的数据集。最后,用LoRA(低秩自适应)对LLM进行微调从而使LLM输出适应ASR转录的风格。
连接模块
表2:不同连接模块的对比
语音编码器
找不到中文语音预训练模型?中文版 Wav2vec 2.0和HuBERT来了,腾讯游戏知几AI团队和西工大ASLP组联合出品
LLM
最后我们对Atom-7B 和百川-7B-chat两个7B的LLM进行了对比。 我们固定语音编码器为HuBERT, 连接层为Transformer, 并仅解冻连接层进行了训练,训练轮数均为1个epoch。结果如表4所示。
最佳组合
我们将HuBERT、Transformer和Baichuan-7B-chat组合在一起,采用三阶段训练策略进行训练,训练数据为表1中的11000小时数据。具体而言,我们仅解冻Transformer训练1个epoch,接着仅解冻HuBERT训练2个epoch,最后我们仅解冻LLM的LoRA矩阵训练2个epoch。得到的最终模型在AISHELL-1、Test_Net和Test_Meeting上取得了最佳性能,同时我们与之前在这些测试集上取得SOTA的模型(Paraformer-large [7] 和Qwen-audio)分别进行了比较,其中Paraformer在60000小时的中文数据上训练得到,Qwen-audio在30000小时中文数据上训练得到,同时还有基于Whisper-large的v2(使用表1中的训练数据)和v3版本(Wenet团队使用WenetSpeech数据集Finetune版本)的全量参数微调后的结果,具体结果如表5所示。
表5: 与主流模型的对比
[1] C. Shan, C. Weng, G. Wang, D. Su, M. Luo, D. Yu, and L. Xie, “Component Fusion: Learning Replaceable Language Model Component for End-to-end Speech Recognition System,” in ICASSP, 2019.
[2] C. Tang, W. Yu, G. Sun, X. Chen, T. Tan, W. Li, L. Lu, Z. Ma, and C. Zhang, “SALMONN: Towards Generic Hearing Abilities for Large Language Models,” 2023.
[3] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust Speech Recognition via Large-Scale Weak Supervision,” in ICML, 2023.
[4] Y. Chu, J. Xu, X. Zhou, Q. Yang, S. Zhang, Z. Yan, C. Zhou, and J. Zhou, “Qwen-Audio: Advancing Universal Audio Understanding via Unified Large-Scale Audio-Language Models,” 2023.
[5] Z. Ma, G. Yang, Y. Yang, Z. Gao, J. Wang, Z. Du, F. Yu, Q. Chen, S. Zheng, S. Zhang, and X. Chen, “An Embarrassingly Simple Approach for LLM with Strong ASR Capacity,” 2024.
[6] W. Hsu, B. Bolte, Y. H. Tsai, K. Lakhotia, R. Salakhutdinov, and A. Mohamed, “HuBERT: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units,” ACM, 2021.
[7] Zhifu Gao, Shiliang Zhang, Ian McLoughlin, Zhijie Yan, “Paraformer: Fast and Accurate Parallel Transformer for Non-autoregressive End-to-End Speech Recognition,” in Interspeech, 2022.
