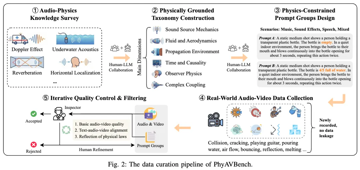
音画同步生成的「音频物理真实感」,终于有了硬核标尺|PhyAVBench 论文详解

以下文章来源于SV4Good AI Lab 引言 Sora、Kling 等文生音视频模型,能画出逼真画面、配上同步声音,但真的懂声学物理吗?吹空瓶子 vs 吹装水瓶子、敲木头 vs 敲金属,模型能生成符合物理规律的声音吗? 本文介绍由香港科…
28 0 0

以下文章来源于SV4Good AI Lab 引言 Sora、Kling 等文生音视频模型,能画出逼真画面、配上同步声音,但真的懂声学物理吗?吹空瓶子 vs 吹装水瓶子、敲木头 vs 敲金属,模型能生成符合物理规律的声音吗? 本文介绍由香港科…
来源丨智东西 今天,小米正式开源 MiMo-V2.5 系列模型,采用MIT协议,允许商用推理部署与二次训练,无需额外授权。 ▲MiMo-V2.5-Pro在Hugging Face的开源页面截图 此前,该系列模型于4月23日开启公测,包括Mi…
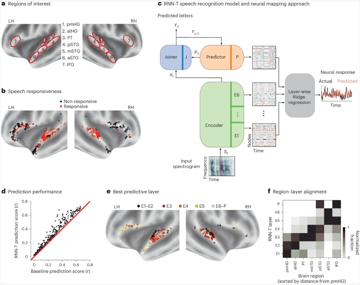
在过去几十年中,计算机科学家开发了许多能够处理不同语言的人类语音的人工智能(AI)系统。然而,这些模型在多大程度上复刻了人类理解口语时的大脑运作机制,目前尚无明确结论。 哥伦比亚大学、IBM研究院和费恩斯坦医学研究所的研究人员最近开展了一项…
FireRed-OpenStoryline将复杂的视频创作转化为自然直观的对话体验。兼顾易用性和企业级可靠性,让视频创作对初学者和创意爱好者都变得简单友好。 项目简介 FireRed-OpenStoryline是FireRedTeam团队开…
今天,阶跃正式发布新一代自动语音识别模型StepAudio 2.5 ASR! 这款模型的核心突破在于速度与精度的兼得。我们率先将大语言模型(LLM)的推理加速技术引入语音识别领域,基于 ASR+MTP-5 深度融合架构,实测推理速度提升40…
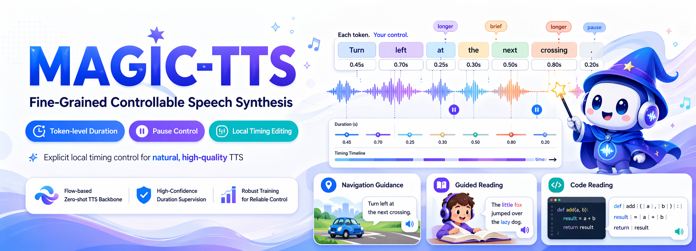
在今天的语音合成系统里,听起来自然已经不再稀缺,但哪里该慢一点、哪个字该拉长、哪个位置该停顿、停多久,依然很难真正交给用户来控制。 但这恰恰是很多真实应用场景在意的问题。 比如导航播报里,“前方路口左转”中的“左转”往往需要更清楚、更突出;…
今天,小米发布MiMo-V2.5-TTS Series与MiMo-V2.5-ASR—— 一套面向 Agent 时代的全链路语音模型系列,覆盖识别与合成两大核心能力,让语音的输入与输出都可以被语言自由调度。 MiMo-V2.5-TTS Ser…
近期,浙江大学研究者提出了WavAlign: Enhancing Intelligence and Expressiveness in Spoken Dialogue Models via Adaptive Hybrid Post-Trai…
