
Doubao-Seed-2.0-lite升级,支持全模态理解

今天,Doubao-Seed-2.0-lite 升级新版本,这是豆包大模型家族首款全模态理解模型,支持视频、图像、音频、文本原生统一理解,Agent、Coding 与 GUI 能力同步升级。在同等算力成本下,是企业大规模、批量化部署全模态推…
33 0 0

今天,Doubao-Seed-2.0-lite 升级新版本,这是豆包大模型家族首款全模态理解模型,支持视频、图像、音频、文本原生统一理解,Agent、Coding 与 GUI 能力同步升级。在同等算力成本下,是企业大规模、批量化部署全模态推…
在当前指令遵循式语音合成(Instruction-Following TTS)快速发展的背景下,如何系统性地评估模型是否真正“听懂并执行”了用户的自然语言声音指令,已成为制约该领域发展的关键瓶颈。现有的评测方案普遍面临覆盖维度有限、诊断粒度…
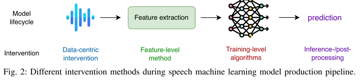
本文来源:模型之声 标题:《Toward Fair Speech Technologies: A Comprehensive Survey of Bias and Fairness in Speech AI》 链接:https://arxi…


在语音降噪风雨六十载(上)——传统信号处理黄金时代中介绍了传统信号处理算法在语音降噪中的应用,下面用一个视频总结下信号处理不同算法的优缺点。 过去 15 年间,深度学习方法已得到广泛普及。凭借其强大的高维非线性建模能力,它已被成功应用于计算…

以下文章来源于SV4Good AI Lab 引言 Sora、Kling 等文生音视频模型,能画出逼真画面、配上同步声音,但真的懂声学物理吗?吹空瓶子 vs 吹装水瓶子、敲木头 vs 敲金属,模型能生成符合物理规律的声音吗? 本文介绍由香港科…

标题:《TTS-PRISM: A Perceptual Reasoning and Interpretable Speech Model for Fine-Grained Diagnosis》 链接:https://arxiv.org/pd…


让语音大模型学会“听声辨意”,不只是转文字,更要懂语气、知情绪、会安慰。 🙋 一个真实的场景 你对着智能语音助手说:“早上好”, 声音里带着轻微的咳嗽。
