ICASSP 2022 | SpanPSP:一种基于跨度的端到端中文韵律结构预测模型

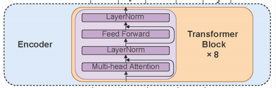
本文由清华大学与香港中文大学、北京世纪好未来教育科技有限公司合作,提出了一种面向语音合成的基于跨度(span)的端到端韵律结构预测模型SpanPSP,该模型直接接受汉字字符序列作为输入,不需要任何的分词、词性标注等预处理,且相比于现有的所有…
461 1 0

本文由清华大学与香港中文大学、北京世纪好未来教育科技有限公司合作,提出了一种面向语音合成的基于跨度(span)的端到端韵律结构预测模型SpanPSP,该模型直接接受汉字字符序列作为输入,不需要任何的分词、词性标注等预处理,且相比于现有的所有…
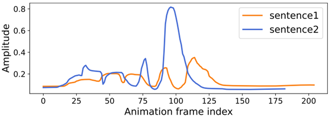
本文由清华大学与上海交通大学、微软中国合作,提出了一种从语音预测虚拟人脸部动画参数(Speech-to-Animation, S2A)的方法,能够稳定且高效地生成与语音内容同步的面部表情动作。与传统方法相比,本文利用音素后验概率图来表征语音…
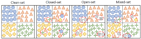
论文转载厦大智能语音实验室 声纹识别是指从说话人的语音信号中提取声纹特征,并通过有效的分类识别模型,对说话人的身份进行校验和鉴别。声纹识别广泛应用于刑侦、人机交互声纹口令验证、银行声纹身份验证等领域。当前的声纹识别系统通常包括两个模块:神经…
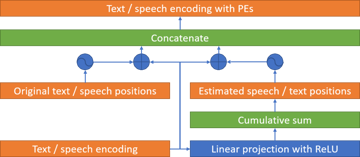
本文由清华大学与香港中文大学、字节跳动公司合作,提出了一种新的双向注意力机制(bidirectional attention mechanism)以及基于该机制的神经网络强制对齐(forced alignment)模型NeuFA。该模型基于…
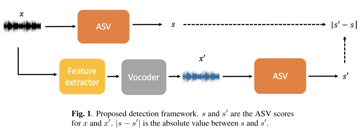
本文由台湾大学、清华大学、香港中文大学与腾讯科技有限公司合作,针对说话人验证系统很容易受到对抗性样本攻击的问题,提出了一种基于神经声码器的、用于说话人验证系统的对抗样本检测的方法。 扫码阅读论文: https://arxiv.org/abs…
本文由清华大学与微软亚洲研究院合作,提出了一个同时利用声学特征、语音学特征和语言学特征的音素级别错误发音检测与诊断(mispronunciation detection and diagnosis,MD&D)框架。其中语音学特征提取自用大规…
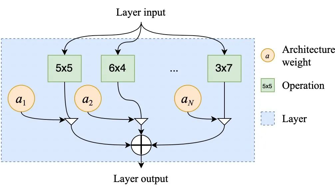
本文由香港中文大学、清华大学合作,研究面向语音情感识别的神经网络架构搜索,提出了一种均匀路径丢弃(uniform path dropout)的训练策略以改进神经架构的搜索速度,有效地提升了神经网络的情感识别准确率,也降低了模型的参数量。
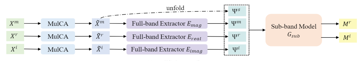
本文由清华大学与广州虎牙信息科技有限公司、香港中文大学合作,提出了一种新型的基于通道注意力机制的复数谱单通道语音增强网络 FullSubNet+,在低信噪比(SNR) 的条件下于抑制噪声恢复语音信号任务上取得了良好的效果,超越了现有的最好的…
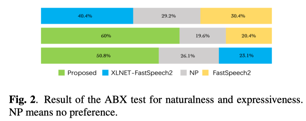
本文由清华大学与虎牙信息科技有限公司、香港中文大学合作。传统的表现力语音合成主要考虑当前语句内部的信息,而没有考虑当前语句所处上下文的影响,导致同一输入文本的合成语音,其说话风格相对固定、缺乏变化。为了建模更有表现力的说话风格,模型需要考虑…
个性化语音增强(personalized speech enhancement, PSE)也称为目标说话人提取(target speaker extraction,TSE),其主要目的是通过目标说话人的注册语音从复杂的受干扰的语音(如带噪、…