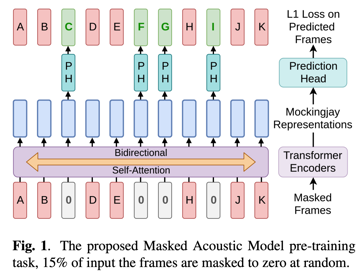
论文分享 | Mockingjay: 基于双向Transformer编码的无监督语音表征学习
文章来源于智能语音新青年,作者ttslr 本次分享台湾大学李宏毅老师团队在ICASSP 2020会议发表的论文《MOCKINGJAY: UNSUPERVISED SPEECH REPRESENTATION LEARNING WITH DEE…
107 0 0

文章来源于智能语音新青年,作者ttslr 本次分享台湾大学李宏毅老师团队在ICASSP 2020会议发表的论文《MOCKINGJAY: UNSUPERVISED SPEECH REPRESENTATION LEARNING WITH DEE…
今日论文合集:cs.SD语音4篇,eess.AS音频处理4篇。 cs.SD语音 【1】 Goniometers are a Powerful Acoustic Feature for Music Information Retrieval…
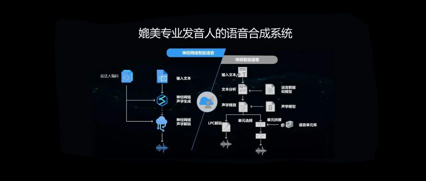
多年来,微软持续探索 AI 语音合成与识别技术,获得了大量成果:Azure Neural TTS(text-to-speech,语音合成)与 STT(speech-to-text,语音识别)支持的语言区域达到 140 余个,并支持超过 40…
今日论文合集:cs.SD语音2篇,eess.AS音频处理2篇。 cs.SD语音 【1】 Epic-Sounds: A Large-scale Dataset of Actions That Sound 标题:史诗-声音:一个大规模的行动数据…
今日论文合集:cs.SD语音6篇,eess.AS音频处理6篇。 cs.SD语音 【1】 InstructTTS: Modelling Expressive TTS in Discrete Latent Space with Natural…
声学模型共享方法是极低资源小语种语音识别一种解决方案,能够实现不需要任何语音数据的语音识别。本文介绍清华大学语音与音频技术实验室的零资源韩语语音系统,其在不使用任何韩语语音数据的情况下,在Zeroth韩语数据集上的测试CER达到了27.33…
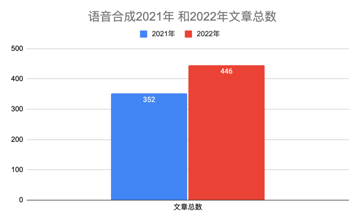
论文统计每月更新一次,主要跟踪语音合成和语音识别的发展状况。很多文章都是在会议后才发出,但不影响统计。统计过程难免存在疏漏,因此统计结果仅供参考。 所有文章语音合成领域统计列表请访问: http://yqli.tech/page/tts_p…
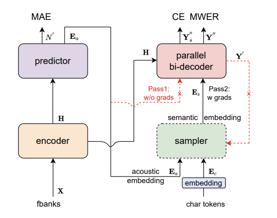
近期,阿里巴巴达摩院发布新一代语音识别模型Paraformer,这是业界首个应用落地的非自回归端到端语音识别模型,在推理效率上最高可较传统模型提升10倍,且识别准确率在多个权威数据集上名列第一。 目前,该模型于魔搭社区面向全社会开源,适用语…
通过 Azure 认知服务的智能语音功能[1],用户可以使用语音 SDK 开发工具包快速构建支持语音交互的各种应用。将语音转录为准确的文本 (STT,或语音识别)或者将文本转换成生动的语音 (TTS,或语言合成),从未像今天如此简单。这些工…