

声浪

论文分享丨IMU语音理解与生成实验室3篇录用论文分享

分享3篇IMU语音理解与生成实验室被中科院一区Top期刊Information Fusion 录用的论文,内容涵盖对话语音合成、视听语音识别生成式纠错、语音鉴伪等。 《Information Fusion》在中科院分区中为计算机科学大类一区…
15 0 0
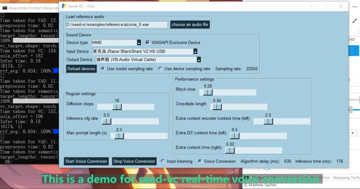
Seed-VC:零样本实时转换语音和歌声,实时语音延迟最低300毫秒!
Seed-VC 是由开发者 Plachtaa 在 GitHub 上开源的项目,其灵感来源于字节跳动的 SEED-TTS 架构,是一款超强大的开源语音转换和歌曲转换工具。 项目地址:https://github.com/Plachtaa/se…
19 0 0


IEEE SPM | 模块化端到端远场语音处理:以远场自动语音识别为例
近期上海交通大学听觉认知与计算声学实验室,联合美国卡内基梅隆大学CMU和日本电报电话公司NTT,合作的论文“Module-Based End-to-End Distant Speech Processing: A Case Study of…
19 0 0

NAACL 2025丨上交大跨媒体语言智能实验室5篇论文分享
北美计算语言学协会年会(The North American Chapter of the Association for Computational Linguistics,NAACL)成立于1998年,每年举办一届,是自然语言处理和计算…
19 0 0

港中大(深圳)开源语音理解大模型Soundwave,1/50训练数据媲美Qwen2-Audio!
在 NLP 领域,大模型(LLMs)凭借其强大的理解和推理能力,正在重塑行业格局。另一方面,多模态大模型,尤其是以语音交互为核心的模型也开始崛起,技术发展迅猛,前景广阔。以 GPT-4o 为例,语音与大模型的端到端结合展示出了高实时性与强表…
20 0 0


LIFT:将长上下文知识注入模型参数,提升大模型长文本能力
来源丨机器之心 长文本任务是当下大模型研究的重点之一。在实际场景和应用中,普遍存在大量长序列(文本、语音、视频等),有些甚至长达百万级 tokens。扩充模型的长文本能力不仅意味着可以在上下文窗口中装入更长的文本,更是能够更好地建模文本段落…
14 0 0