使用pyannote.audio进行语音分离和说话人识别

链接:https://github.com/pyannote/pyannote-audio pip install pyannote.audio
171 0 0

链接:https://github.com/pyannote/pyannote-audio pip install pyannote.audio

SOTA 语音合成效果。 来源丨机器之心 文本到语音合成(Text to Speech,TTS)作为生成式人工智能(Generative AI 或 AIGC)的重要课题,在近年来取得了飞速发展。在大模型(LLM)时代下,语音合成技术能够扩展…


人类语音传达丰富的情感,不同地区和文化的人们在情感表达上既有相似之处又展现独特风采。多语种情感语音合成(Multilingual Emotional Speech Synthesis)的目标是为每位说话人提供多语言且情感丰富的表达能力,尤其…


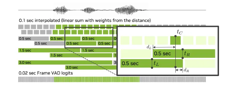
语音领域每年都有很多比赛,每个比赛都有自己的侧重点,其中CHiME系列比赛的侧重点就是多通道远场语音识别,与其他的语音识别比赛有所区别的是,CHiME提供分布式麦克风和麦克风阵列数据,这样可以选择合适的前端算法以降低识别的WER,著名的CG…

近期,微软、中科大、港中大(深圳)、浙大等机构联合发布了一种全新的TTS系统——NaturalSpeech 3,它从语音数据的“表示”和“建模”两个角度出发,利用创新的属性分解扩散模型和属性分解语音神经编码器 FACodec,在零样本情况下…