又快又好! 基于Consistency Model的一步采样歌声转换模型CoMoSVC已开源

在2023年,AI虚拟歌手如AI孙燕姿等已经引起了广泛的关注,而大多数应用都是基于开源框架SoVITS。最近,香港科技大学和微软亚洲研究院推出了一种基于Consistency Model的歌声转换系统CoMoSVC,它在歌声转换速度上与基于…
9 0 0

在2023年,AI虚拟歌手如AI孙燕姿等已经引起了广泛的关注,而大多数应用都是基于开源框架SoVITS。最近,香港科技大学和微软亚洲研究院推出了一种基于Consistency Model的歌声转换系统CoMoSVC,它在歌声转换速度上与基于…
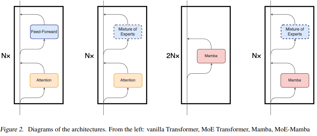
今天分享10篇最近刚刚公布的论文,涉及大模型微调、Transformer替换、LoRA、实体关系抽取、大模型幻觉等热门研究方向。其中关于将多个模型协同混合可媲美ChatGPT,论文特别有意思。 LLM后预训练方法 https://arxiv…

今日论文合集:cs.SD语音5篇,eess.AS音频处理6篇。 cs.SD语音 【1】LCB-net: Long-Context Biasing for Audio-Visual Speech Recognition 标题

项目简介 使用开源LLM生成关于任何主题的多轮训练数据!节省您手动编辑数千个 AI 聊天来构建自己的数据集的时间(然后由于个人声誉风险,您无论如何都无法开源)。轻松配置提示和设置以生成符合您的品味和兴趣的对话。避免因为不使用 OpenAI…

今日论文合集:cs.SD语音10篇,eess.AS音频处理10篇。 cs.SD语音 【1】Contrastive Loss Based Frame-wise Feature disentanglement for Polyphonic So…
在本届ICASSP 2024 各类音频国际挑战赛中,字节跳动流媒体音频团队联合西北工业大学音频语音与语言处理研究实验室,在丢包补偿(Packet Loss Concealment, PLC)与音质修复(Speech Signal Impro…

今日论文合集:cs.SD语音10篇,eess.AS音频处理11篇。 cs.SD语音 【1】 Noise-robust zero-shot text-to-speech synthesis conditioned on self-superv…
标题:Improving ECAPA-TDNN Performance with Coordinate Attention 作者:刘双红,宋志达,何亮 单位:新疆大学计算机科学与技术学院、清华大学电子工程系 研究背景 尽管深度学习在说话人验…

人工智能的进步使得听起来真实的语音合成成为可能,以至于一个人无法再区分自己是在与另一个人交谈还是与一个合成的声音交谈。如果一个人自己的声音在未经其同意的情况下被第三方“克隆”,恶意行为者就可以利用它来发送他们想要的任何消息。 这是可用于创建…

今日论文合集:cs.SD语音12篇,eess.AS音频处理12篇。 cs.SD语音 【1】Masked Audio Generation using a Single Non-Autoregressive Transformer