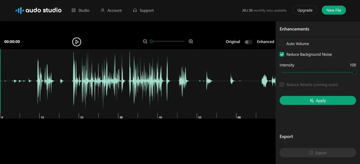
6 种 AI 工具可轻松消除音频或视频录制中的背景噪音
在理想世界中,我们会在宁静的空间里进行所有音频和视频录制。然而,我们大多数人的日常现实与此不同。外面的交通和邻居的噪音并不总是在我们的控制范围内。 如果您的录音中存在噪音,想要修复,那么本文正适合您。您将找到一些可用于消除录音中背景噪音的最…
32 0 0

在理想世界中,我们会在宁静的空间里进行所有音频和视频录制。然而,我们大多数人的日常现实与此不同。外面的交通和邻居的噪音并不总是在我们的控制范围内。 如果您的录音中存在噪音,想要修复,那么本文正适合您。您将找到一些可用于消除录音中背景噪音的最…

今天凌晨,OpenAI 突然宣布终止对中国提供 API 服务,进一步收紧国内开发者访问 GPT 等高水平大模型。国内开发者真是太难了。 好在,随着开源大模型水平越来越高,开发者已经有很多不错的 “平替”,比如 Qwen2、DeepSeek…


是时候把数据Scale Down了!Llama 3揭示了这个可怕的事实:数据量从2T增加到15T,就能大力出奇迹,所以要想要有GPT-3到GPT-4的提升,下一代模型至少还要150T的数据。好在,最近有团队从CommonCrawl里洗出了2…

为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期是2024年导读栏目的第1期,也是INTERSPEECH 2024专题第一部分,共遴选了7篇论文,…

“Giga”一词源于“gigantic”,互联网上具有海量音频资源,但语音质量良莠不齐,高质量音频文本对数据十分稀缺且标注成本高昂,特别是在小语种领域。GigaSpeech 是一个非常成功的英文开源数据集,以 YouTube 和 Podca…

本次分享由江西师范大学与Institute for Infocomm Research, A*STAR联合投稿于EMNLP 2023 的一篇论文《Leveraging Contrastive Learning and Knowledge D…