
语音识别的"幻觉":听不清的时候,AI 为什么开始编

很多人第一次遇到语音识别的"幻觉",是在一段几乎没有人声的录音里。 会议散场后忘了关录音,最后十分钟只有空调声和收拾东西的动静。转写结果却工整地写着一句:"谢谢观看,请点赞订阅。" 没有人说过这句话。模型也不是听错了某个字,而是凭空写出了一…
313 0 0

很多人第一次遇到语音识别的"幻觉",是在一段几乎没有人声的录音里。 会议散场后忘了关录音,最后十分钟只有空调声和收拾东西的动静。转写结果却工整地写着一句:"谢谢观看,请点赞订阅。" 没有人说过这句话。模型也不是听错了某个字,而是凭空写出了一…
今日论文合集:CS.SD语音与音频 | 共 8 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Domain-Adaptive A…

本文旨在介绍论文《Fourier is Frontier: Frequency-Aware Autoencoding for High-Fidelity Music Reconstruction》的相关内容,详情如下: GitHub:htt…

今日论文合集:CS.SD语音与音频 | 共 4 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. EXAM$^2$: $\under…

今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Multi-Task Learn…
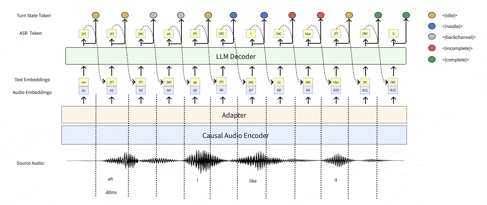
你有没有过这种体验:跟语音助手说话,刚停半秒,它就抢着回——其实你只是喘了口气; 或者你已经说完了,它还在干等,场面一度很尴尬。 这些「接话时机」问题,本质不是 ASR 认不清字,而是系统不会判断: 用户是说完了,还是话还没说完? 这句「嗯…
今日论文合集:CS.SD语音与音频 | 共 3 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Towards Quantifyi…
今日论文合集:CS.SD语音与音频 | 共 5 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Geometric Iterati…
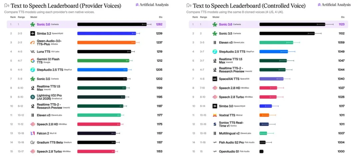
来源丨RTE开发者社区、Data接化发 Cartesia 发布 Sonic-3.6 TTS 模型,重点提升 44 种语言下的语音自然度,并称这是其目前最逼真的 TTS 版本。 相比三个月前发布的 Sonic-3.5,新版本根据开发团队反馈进…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. A Multiplication-…
