
Meta官宣收购智能体初创公司Manus

机器之心编辑部 今天,Meta 完成了一项大收购,将智能体初创公司 Manus 收入麾下。 目前,双方交易的具体细节(包括具体收购金额等)尚未公布。 自今年 3 月推出全球首款通用 Agent 以来,Manus 迅速走红,成为人工智能领域的…
20 0 0

机器之心编辑部 今天,Meta 完成了一项大收购,将智能体初创公司 Manus 收入麾下。 目前,双方交易的具体细节(包括具体收购金额等)尚未公布。 自今年 3 月推出全球首款通用 Agent 以来,Manus 迅速走红,成为人工智能领域的…
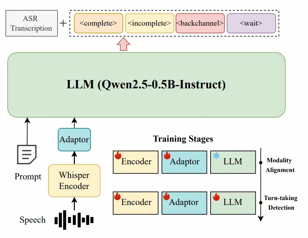
从2022年优化智能客服开始,我就开始尝试优化人机语音对话中的“语义完整度”模块。当时大部分人的精力都集中在优化识别率,在语音对话系统中,这不是一个核心模块,似乎是可有可无的,但语义上的完整度对于用户体验、信息收集的效率都有很大的影响。特别…

来源 | 量子位 现有的AI视频生成模型虽然在短片上效果惊人,但面对一首完整的歌曲时往往束手无策——画面不连贯、人物换脸、甚至完全不理会歌词含义。 近日,来自M-A-P、北京邮电大学、南京大学NJU-LINK实验室等机构的研究者们提出了Au…


最近一些朋友,包括从事投资方向的朋友,看到我的笔记和文章后,会找我聊语音相关的技术和现状,以及对当前一些技术和应用的看法。今天想分享一下,在我看来,大模型的AI时代,未来在智能语音方向,我只看好两个方向:语音理解和被动语音记录。 基础技术上…

来源丨PaperWeekly 无需重新训练,只要抑制 0.1% 的特定神经元,就能让模型“闭嘴”? 近年来,大语言模型(LLMs)在问答、推理与生成任务中展现出卓越能力,但其幻觉(Hallucination)问题仍然是制约实际应用的核心挑战…
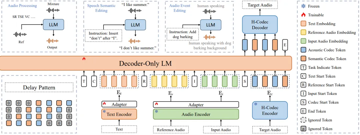
近日,千问C端AI人机交互团队联合通义实验室在音频大模型领域取得重要进展,正式开源QuarkAudio:一个面向端到端音频处理与生成的统一建模框架。QuarkAudio基于离散化音频表征实现了对语音修复、音频生成与编辑等多样化任务的统一建模…


说实话,今年语音模型的内卷程度已经到了不讲武德的地步。但这次,Qwen3-TTS 的更新,是真的有点狠。 阿里通义刚刚上线了 Qwen3-TTS 的两大核心能力: •VoiceDesign(VD-Flash):用文字“设计”声音,而不是选声…
