如何防止人工智能窃取你的声音
人工智能的进步使得听起来真实的语音合成成为可能,以至于一个人无法再区分自己是在与另一个人交谈还是与一个合成的声音交谈。如果一个人自己的声音在未经其同意的情况下被第三方“克隆”,恶意行为者就可以利用它来发送他们想要的任何消息。 这是可用于创建…
88 0 0

人工智能的进步使得听起来真实的语音合成成为可能,以至于一个人无法再区分自己是在与另一个人交谈还是与一个合成的声音交谈。如果一个人自己的声音在未经其同意的情况下被第三方“克隆”,恶意行为者就可以利用它来发送他们想要的任何消息。 这是可用于创建…

今日论文合集:cs.SD语音12篇,eess.AS音频处理12篇。 cs.SD语音 【1】Masked Audio Generation using a Single Non-Autoregressive Transformer

AudioCraft 是一个 PyTorch 库,用于对音频生成进行深度学习研究。AudioCraft 包含推理和训练代码 用于两个最先进的 AI 生成模型,以产生高质量的音频:AudioGen 和 MusicGen。 官方地址:https…

近几个月来,视频生成领域陆续发布了新技术、新模型和新工具,AI 生成的视频效果也得到了肉眼可见的提升和颠覆。 很多人认为,人工智能领域接下来公认的主战场,毋庸置疑是视频生成技术。 图 1:2023 年 AI 视频工具概览 图片来源: htt…
今日论文合集:cs.SD语音6篇,eess.AS音频处理8篇。 cs.SD语音 【1】MusicAOG: an Energy-Based Model for Learning and Sampling a Hierarchical Repr…
金磊 发自 凹非寺,量子位 | 公众号 QbitAI 2024开年,小冰再次归来,宣布将一系列测试产品转为正式发布!值得一提的是,小冰克隆人测试期间,部分大V网红年收入已破百万。 凭着AI,月入10万、年入100万,你敢想? 别不信,好几位…

超低功耗半导体解决方案供应商Ambiq®推出了其最新产品——神经网络语音增强器 (NNSE),并已将该方案加入到neuralSPOT的(开源模型)Model Zoo中。这一高度优化过的AI模型可以高效实时地将背景噪声从设备对话中去除,从而在…

今日论文合集:cs.SD语音10篇,eess.AS音频处理10篇。 cs.SD语音 【1】PosCUDA: Position based Convolution for Unlearnable Audio Datasets 标题:PosCU…
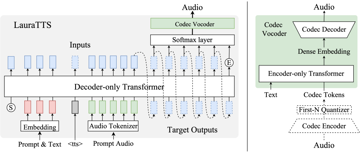
项目地址: https://github.com/alibaba-damo-academy/FunCodec https://modelscope.cn/models/damo/speech_synthesizer-laura-en-lib…

近日,2024年IEEE声学、语音与信号处理国际会议(2024 IEEE International Conference on Acoustics, Speech, and Signal Processing, ICASSP 2024)发…