
声浪
语音合成和语音识别资料查询说明

文章转载请标明出处:微信公众号 低调奋进 个人网站http://yqli.tech/本来整理语音合成相关的文章、数据以及开源工具等等。现在,我对资料进行整理,添加了语音识别模块,在这里分享给大家,节省读者查找资料的时间。接下来,我给大家详细…
467 0 0
调研报告|级联编码器 (Cascaded Encoders) 在线+离线混合 ASR 模型
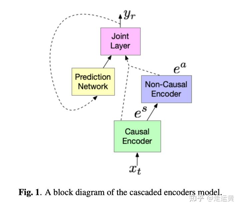
受到 Google 一篇论文CASCADED ENCODERS FOR UNIFYING STREAMING AND NON-STREAMING ASR的启发,准备采用级联编码来改善 Second Pass 的识别效果。 最近也有其他离在线…
350 1 0
OpenSpeaker之声纹数据整理
本文是OpenSpeaker系列的第二篇文章,全系列可参考这篇文章或者文末的专栏: https://zhuanlan.zhihu.com/p/419848589 根据规划,今天先来看第一部分数据整理: OpenSpeaker
497 0 0
百万小时无监督数据上训练80亿参数模型,多项语音任务上SoTA,语音的ImageNet时刻?(一)
0、摘要 本文总结了使用大型自动语言识别(ASR)模型进行的大量工作的结果,这些模型使用了包含大约一百万小时音频的无标签数据集进行预训练。作者发现,预训练、自监督训练和增大模型大小这三种方法的结合可以极大地提高数据有效利用率,即使对具有数万…
762 1 0
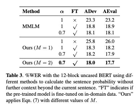
语音识别(ASR)论文优选:Adapting GPT, GPT-2 and BERT Language Models for Speech Recognition
1、研究背景 预训练模型的Bert, GPT,GPT2为下游诸多nlp任务提供很好的帮助,但其在ASR中应用却很少研究,因此本文主要研究这些预训练模型Bert, GPT,GPT2在ASR中的应用。 2、详细设计 本文主要回顾一下Transf…
423 0 0
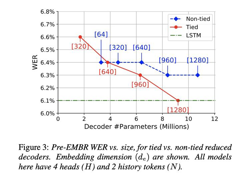
语音识别(ASR)论文优选:Tied & Reduced RNN-T Decoder
声明:平时看些文章做些笔记分享出来,文章中难免存在错误的地方,还望大家海涵。平时搜集一些资料,方便查阅学习:http://yqli.tech/page/speech.html。 如转载,请标明出处。欢迎关注微信公众号:低调奋进 Tied &…
220 1 0
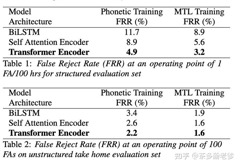
动态 Chunk Conformer 在线+离线混合 ASR 模型
这次要分享的是出门问问最近分享的一篇 Paper Unified Streaming and Non-streaming Two-pass End-to-end Model for Speech Recognition,他们团队还并奉上了训…
336 1 0
今年的 COSCon 中国开源年会,让我们聊点不一样的

人们常常说,在熬过了数十年寒冬,2020 -2021 我们终于迎来了本土开源的拐点,国家政策的引导、基础软件的崛起、开放协作精神的觉醒……各种各样的数据报告也无一不支撑着这一观点。 GitHub 2015 - 2020 年事件日志量、活跃仓…
179 0 0