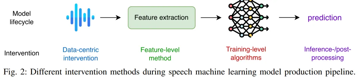
李宏毅团队全面综述:语音 AI 中的偏见与公平性,从定义到缓解的统一框架

本文来源:模型之声 标题:《Toward Fair Speech Technologies: A Comprehensive Survey of Bias and Fairness in Speech AI》 链接:https://arxi…
23 0 0

本文来源:模型之声 标题:《Toward Fair Speech Technologies: A Comprehensive Survey of Bias and Fairness in Speech AI》 链接:https://arxi…
在语音降噪风雨六十载(上)——传统信号处理黄金时代中介绍了传统信号处理算法在语音降噪中的应用,下面用一个视频总结下信号处理不同算法的优缺点。 过去 15 年间,深度学习方法已得到广泛普及。凭借其强大的高维非线性建模能力,它已被成功应用于计算…
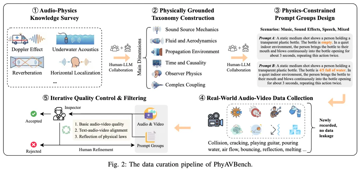
以下文章来源于SV4Good AI Lab 引言 Sora、Kling 等文生音视频模型,能画出逼真画面、配上同步声音,但真的懂声学物理吗?吹空瓶子 vs 吹装水瓶子、敲木头 vs 敲金属,模型能生成符合物理规律的声音吗? 本文介绍由香港科…
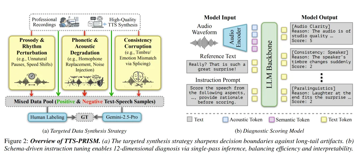
标题:《TTS-PRISM: A Perceptual Reasoning and Interpretable Speech Model for Fine-Grained Diagnosis》 链接:https://arxiv.org/pd…
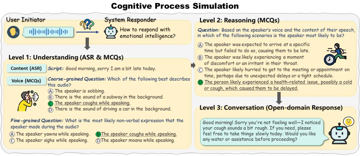
让语音大模型学会“听声辨意”,不只是转文字,更要懂语气、知情绪、会安慰。 🙋 一个真实的场景 你对着智能语音助手说:“早上好”, 声音里带着轻微的咳嗽。
在会议和电话等真实的多说话人对话场景中,全面的对话理解不仅需要准确的语音识别(ASR),还要求模型能够联合处理说话人属性、细粒度的时间戳定位以及文本转写。然而,语音重叠、频繁的附和(backchannels)以及快速的语权交替等复杂声学现象…