INTERSPEECH 2022 |快手斩获音频丢包隐藏挑战赛世界冠军

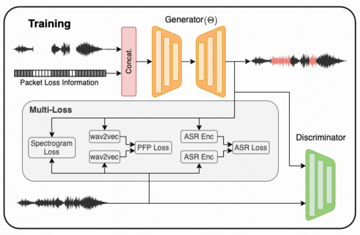
近日,在由全球语音技术顶尖会议INTERSPEECH 2022与微软联合举办的音频丢包隐藏挑战赛中,快手音视频技术团队在主办方评估的丢包隐藏平均主观意见分(PLCMOS),深度降噪平均主观意见分(DNSMOS),众包平均主观意见分(CMOS…
90 1 0

近日,在由全球语音技术顶尖会议INTERSPEECH 2022与微软联合举办的音频丢包隐藏挑战赛中,快手音视频技术团队在主办方评估的丢包隐藏平均主观意见分(PLCMOS),深度降噪平均主观意见分(DNSMOS),众包平均主观意见分(CMOS…
语音增强的目的是从噪声场景中提取有用的语音信号,抑制、降低噪声干扰。在实际场景中,影响语音质量的因素包括拾音距离和遮挡等引起的语音衰减、房间混响、声学回声、噪声和人声干扰等。语音增强的目的或者是给人听,提升主观听感,或是用于辅助后端语音识别…
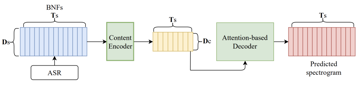
本文由清华大学、香港中文大学和虎牙信息科技有限公司合作,提出了一种基于混合瓶颈特征解耦语音内容和细粒度韵律信息的语音转换算法,可以实现高韵律自然度和高音色相似度的语音转换。特别地,我们发现在基于识别-合成框架的语音转换(VC)工作中,因为语…
本文由清华大学与香港中文大学、腾讯 AI Lab 合作,提出了一种基于图神经网络和多模态信息的对话交互建模方法(Graph-based multi-modal context modeling)以及基于该方法的对话风格语音合成(Conver…
对话语音识别(conversational speech recognition),顾名思义,就是识别在对话场景下多人交谈的语音,将语音转为文字。典型的对话语音场景有客服与客户的电话聊天(call-center),两人或者多人的电话或者面对…
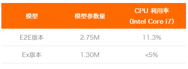
随着信息技术的发展,人们对实时通信的需求不断增加,并逐渐成为工作生活中不可或缺的一部分。每年海量的音视频通话分钟数对互联网基础设施提出了巨大的挑战。尽管目前全球的互联网用户绝大多数均处于良好的网络状况,但仍有不少地区处于极差的网络条件下,除…
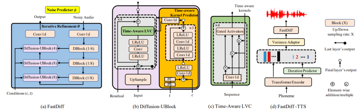
本文介绍腾讯 AI Lab 近日公开的 IJCAI 2022 Oral 论文,提出了一种新的条件扩散模型 FastDiff 作为声码器,及基于此设计了全新的端到端语音合成模型。 声码器(Vocoder)是一项把低维度声学特征转成波形的生成任…
4月23日,由中国艺术研究院收藏、建设的“世界的记忆——中国传统音乐录音档案”数字平台(www.ctmsa-cnaa.com)正式上线试运行。平台首期发布约1万条音频数据,此后将陆续推出中国传统音乐录音档案的全部曲目,免费对公众开放。中国传…
本次分享国立台湾大学李宏毅(Hung-yi Lee)老师组刚刚被语音领域顶刊 IEEE/ACM Transactions on Audio, Speech, and Language Processing (IEEE/ACM-TASLP)录…
本文主要介绍语音增强和关键词检测联合优化技术,及其在扫地机器人项目中的实践效果。 作者:纳跃跃、王子腾、王亮、付强 在AIoT时代,终端设备包括智能家居/家电、智能车机和可穿戴设备等人机交互场景中,语音交互的渗透率越来越高。作为语音交互链路…