ICASSP 2026 | MEANSE: 基于平均速度流的高效生成式语音增强

语音增强(Speech Enhancement, SE)旨在提升降质语音的质量,其中流匹配(Flow Matching)等生成模型因其卓越的感知质量而备受关注。然而,基于流的模型需要多次函数评估(Number of Function Eva…
31 0 0

语音增强(Speech Enhancement, SE)旨在提升降质语音的质量,其中流匹配(Flow Matching)等生成模型因其卓越的感知质量而备受关注。然而,基于流的模型需要多次函数评估(Number of Function Eva…
来源:龙猫LongCat 音频生成技术正在经历一场全新的范式迁移——从传统级联架构,逐步向端到端生成范式演进。长期以来,主流的做法是“曲线救国”:合成系统先将音频压缩成梅尔频谱图等中间表征,再依赖神经声码器“翻译”回波形。每一次转换都带来信…
来源丨千问大模型 今天,阿里发布图像生成与编辑统一模型 Wan2.7-Image 正式发布。 针对当前AI生图中的审美疲劳、色彩失控等痛点,Wan2.7-Image带来了更具“活人感”的人物生成、精准的色彩控制以及超长文本渲染能力。 体验…
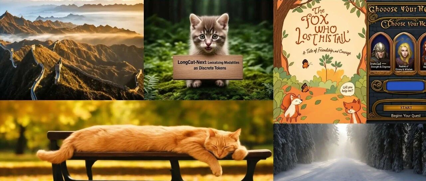
来源丨AIGC Studio 近日,美团开源了一款名为 LongCat-Next 的原生全模态模型,该模型能够接受文本、语音、图像的输入,并生成相应的文本、语音、图像输出。 LongCat-Next不仅简化了多模态建模的复杂性,还在图像理解…
语音理解与生成的飞速发展离不开大规模高质量语音数据集的推动。其中,语音识别(ASR)和语音合成(TTS)被公认为最首要的任务。但对于拥有约 1.2亿 母语使用者的川渝方言而言,受限于标注资源匮乏,研究进展缓慢,ASR 与 TTS 的表现始终…
近日,中国计算机学会(CCF)正式发布了第七版《中国计算机学会推荐国际学术会议和期刊目录》(https://www.ccf.org.cn/Academic_Evaluation/By_category/)。 值得关注的是,全国人机语音通讯学…
零样本语音转换(Zero-shot VC)旨在保留语音语言内容的同时,将源说话人音色迁移至任意未见过的目标说话人。日益丰富的应用场景对模型的流式推理能力提出迫切需求,亟需兼具快速、轻量与高保真特性的解决方案。然而现有流式方法依赖自回归(AR…
