基于WeNet的关键词识别WeKws - WeNet keyword spotting-3-其他模型构造
本次主要是想把剩下的几个配置文件,以及对应的模型,给搞一下: gru.yaml mdtc.yaml mdtc_small.yaml tcn.yaml 因为之前用的是ds_tcn.yaml的相关逻辑。 在三个模型之间“横跳“! 书接上回,目前…
316 0 0

本次主要是想把剩下的几个配置文件,以及对应的模型,给搞一下: gru.yaml mdtc.yaml mdtc_small.yaml tcn.yaml 因为之前用的是ds_tcn.yaml的相关逻辑。 在三个模型之间“横跳“! 书接上回,目前…
今天跟大家分享一篇语音相关的论文合集:cs.SD语音6篇,eess.AS音频处理7篇。 cs.SD语音 【1】 EEG2Mel: Reconstructing Sound from Brain Responses to Music 标题:…
文章来源于阿里语音AI,作者高志付 INTERSPEECH 是由国际语音通讯协会(International Speech Communication Association, ISCA)创办的语音信号处理领域顶级旗舰国际会议。历届 INT…
文章来源于音频语音与语言处理研究组,作者雷怡 当前包括语音合成和语音转换在内的语音生成任务需要目标说话人一定规模的数据参与到模型的训练或者参数更新过程中,而基于零资源(zero-shot)的语音生成任务旨在利用一句话生成系统未见过的目标说话…
今天跟大家分享一篇语音相关的论文合集:cs.SD语音4篇,eess.AS音频处理4篇。 cs.SD语音 【1】 End-To-End Audiovisual Feature Fusion for Active Speaker Detecti…
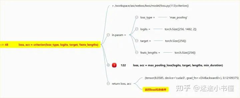
GitHub:https://github.com/Xianchao-Wu/wekws是2022年5月31号fork的,目标还是逐行基于脑图来学习分析代码。 按照epoch循环 四大步了,训练,cv,保存checkpoint,调整学习率
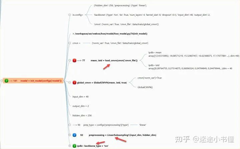
GitHub:https://github.com/Xianchao-Wu/wekws是2022年5月31号fork的,目标还是逐行基于脑图来学习分析代码。 简介 WeKws = wenet + keyword spotting 生产优先和…
今天跟大家分享一篇语音相关的论文合集:cs.SD语音6篇,eess.AS音频处理6篇。 cs.SD语音 【1】 Generative Extraction of Audio Classifiers for Speaker Identific…
语音识别技术,也被称为自动语音识别 (Automatic Speech Recognition,ASR),其目标是将语音转成文字。 现有的语音识别系统一般对单语种支持比较好,例如纯中文或纯英文语音识别系统。考虑到中英文混读的现象在日常交流中…
今天跟大家分享一篇语音相关的论文合集:cs.SD语音13篇,eess.AS音频处理14篇。 cs.SD语音 【1】 FAD: A Chinese Dataset for Fake Audio Detection 标题: FAD:一个用于虚假…