语音/音频处理学术速递[5.19]

cs.SD语音,共计7篇,eess.AS音频处理,共计11篇 1.cs.SD语音: 【1】 Minimising Biasing Word Errors for Contextual ASR with the Tree-Constraine…
165 0 0

cs.SD语音,共计7篇,eess.AS音频处理,共计11篇 1.cs.SD语音: 【1】 Minimising Biasing Word Errors for Contextual ASR with the Tree-Constraine…
海飞科 海飞科(Hexaflake)是一家高科技初创公司,致力于AI高性能处理器芯片和软硬件全栈系统解决方案的研发,是能够在该领域与国际巨头并驾齐驱的头部AI通用型处理器公司。主要创始人及核心团队汇聚中美各地多位国际顶级资深专家;专长涵盖并…
知识蒸馏的诞生背景 近年来,深度神经网络(DNN)在工业界和学术界都取得了巨大成功,尤其是在计算机视觉任务方面。深度学习的成功很大程度上归功于其具有数十亿参数的用于编码数据的可扩展性架构,其训练目标是在已有的训练数据集上建模输入和输出之间的…
cs.SD语音,共计6篇,eess.AS音频处理,共计6篇 1.cs.SD语音: 【1】 Dynamic Recognition of Speakers for Consent Management by Contrastive Embed…
来源丨新智元 最近微软发布了一个新模型NaturalSpeech,在语音合成领域首次达到人类水平,人耳难分真假。 现在很多视频都不采用人类配音,而是让「佟掌柜」、「东北大哥」等角色友情客串,在读起文本来还真有点意思。 相比之前机械化的电子音…
今天跟大家分享一篇语音相关的论文合集:cs.SD语音13篇,eess.AS音频处理15篇。 本文经arXiv每日学术速递(微信公众号:arXiv_Daily)授权转载 cs.SD语音 【1】 Transferability of Adver…
作者:琚雨恺 个性化语音增强(personalized speech enhancement, PSE)也称为目标说话人提取(target speaker extraction,TSE),其主要目的是通过目标说话人的注册语音从复杂的受干扰的…
声纹识别是指从说话人的语音信号中提取声纹特征,并通过有效的分类识别模型,对说话人的身份进行校验和鉴别。声纹识别广泛应用于刑侦、人机交互声纹口令验证、银行声纹身份验证等领域。当前的声纹识别系统通常包括两个模块:神经网络特征提取前端和概率线性判…
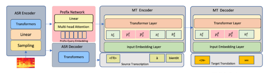
文章来源于阿里语音AI,作者达摩院语音实验室 本文介绍在语音翻译任务中,通过一个跨模态的 prefix network 来适配多语言文本预训练模型的新方式。 / ICASSP收录论文 / CPT: Cross-Modal Prefix-Tu…
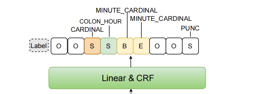
本文由清华大学、标贝科技有限公司、香港中文大学合作,提出了一种将规则、词典和神经网络融合于一体的端到端中文文本正则化模型。该模型结合了规则和词典的可扩展性、神经网络的上下文建模及高效利用大数据的能力,通过规则和词典等在神经网络模型推理的过程…