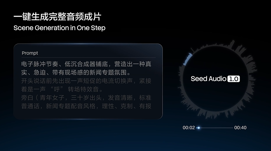
字节发布 Seed Audio 1.0 音频创作模型

今天,字节跳动发布能同时生成人声、音效和环境声的音频创作模型 Seed Audio 1.0。 其核心能力主要体现在以下方面: 多要素统一编排,支持精细的时间控制:一条 prompt 即可统一编排带有特定情绪的对白、关键音效和环境声,并可按时…
15 0 0

今天,字节跳动发布能同时生成人声、音效和环境声的音频创作模型 Seed Audio 1.0。 其核心能力主要体现在以下方面: 多要素统一编排,支持精细的时间控制:一条 prompt 即可统一编排带有特定情绪的对白、关键音效和环境声,并可按时…
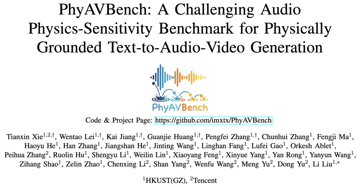
来源丨SV4Good AI Lab Sora、Kling 等文生音视频模型,能画出逼真画面、配上同步声音,但真的懂声学物理吗?吹空瓶子 vs 吹装水瓶子、敲木头 vs 敲金属,模型能生成符合物理规律的声音吗? 本文介绍由香港科技大学(广州)…
近日,语音 AI 初创公司 Rime 宣布完成 2400 万美元 A 轮融资。本轮由知名风投机构 M13 领投,Twilio Ventures、Corazon Capital、Unusual Ventures 和 Cadenza Ventu…
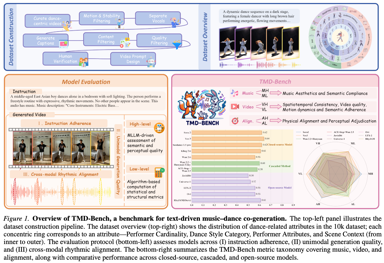
让 AI 生成一段踩着音乐跳舞的视频,今天看起来已经不算难事。Sora 2、Veo 3 这些模型给出的画面光鲜、配乐悦耳,第一眼几乎挑不出毛病。可只要你把音量调大,盯着舞者的手脚看上十几秒,往往会冒出一种说不清的别扭:动作明明在动,却和鼓点…
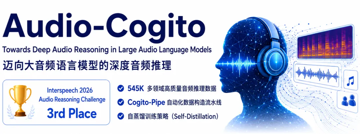
随着大语言模型在文本、视觉等模态上的快速发展,“推理能力”已经成为衡量多模态模型智能水平的重要指标。通过 Chain-of-Thought(CoT)等技术,模型能够将复杂问题拆解为中间推理步骤,从而提升复杂任务上的表现。然而,相较于文本推理…
本期分享由国防科技大学、西安邮电大学、北京声学研究所联合编撰的英文学术专著 General Audio Signal Processing with Deep Learning,全书由 Springer 出版社正式出版。 本书以深度学习赋能…
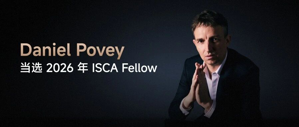
来源丨小米公司 近日,国际语音通信协会(ISCA)正式公布 2026 年 ISCA Fellow 名单,Daniel Povey 凭借其在语音识别声学建模、序列训练创新方法、开源语音工具 Kaldi 以及对全球语音通信领域的深远贡献成功入选…
