
声浪


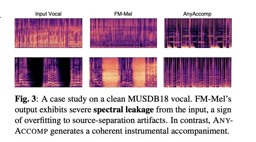
别再喂给模型“分离人声”了,ANYACCOMP让AI学会只看旋律配伴奏 | ICASSP 2026
Singing Accompaniment Generation(SAG,人声伴奏生成)想做的事很直观:给你一段干净的人声/旋律,模型生成一段和声、节奏匹配的伴奏。 但现实里,很多SAG系统都踩在同一个坑上:它们训练时用的“人声输入”,往往…
13 0 0
开源流式语义状态预测模块:SoulX-Duplug 让半双工系统秒变全双工
近日,Soul App AI 团队(Soul AI Lab)联合上海交通大学 X-LANCE Lab和西北工业大学 ASLP@NPU 团队,正式开源 SoulX-Duplug —— 一款面向 全双工语音对话系统(Full-Duplex Sp…
29 0 0
ICASSP 2026|首届多语种对话语音大语言模型挑战赛:数据集、任务、基线系统和方法总结
构建稳健的对话语音大语言模型(Speech LLM)在很大程度上依赖于真实的多语种对话语音数据,然而当前此类数据的稀缺对该领域的发展构成了重大挑战。Interspeech2025多语种对话语音语言模型(MLC-SLM)挑战赛旨在通过发布真实…
19 0 0
Fun-CineForge丨通义开源首个支持影视级多场景配音的多模态大模型
通义发布并开源了首个支持影视级多场景配音的多模态大模型Fun-CineForge。此外,还配套开放了高质量数据集的构建方法。通过“数据 + 模型”的一体化设计,Fun-CineForge 正尝试解决影视级 AI 配音长期面临的关键问题。 在…
19 0 0
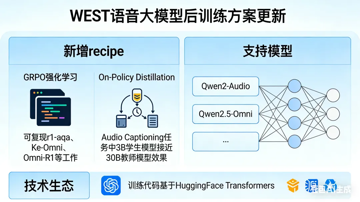
WEST 更新:语音大模型后训练方案来了
WEST 新增了 GRPO 强化学习和 On-Policy Distillation 两个 recipe,支持对 Qwen2-Audio、Qwen2.5-Omni 等音频模型做后训练。GRPO 方案可复现 r1-aqa、Ke-Omni、Om…
31 0 0
SLM-SS:用“语音语言模型”重塑语音分离丨ICASSP2026
基于神经网络的方法使语音分离技术取得显著进步,在信号层面的指标上表现更佳。然而,这些方法往往难以在分离信号中保持语音可懂度,这会对语音识别等下游任务的性能产生负面影响。本文提出SLM-SS方法,通过将语音语言模型应用于语音分离,旨在提升分离…
26 0 0