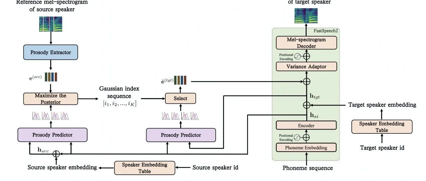
语音合成论文优选:Diverse and Controllable TTS with GMM-Based PLP Modell

本文是上海交大2021.05.27更新的文章,该文章主要使用GMM来进行phone-level的韵律建模,从而提高语音的自然度。该文章主要在单人,多人和prosody clone三个方面进行设计和实验,具体的文章链接 https://arx…
302 67 0

本文是上海交大2021.05.27更新的文章,该文章主要使用GMM来进行phone-level的韵律建模,从而提高语音的自然度。该文章主要在单人,多人和prosody clone三个方面进行设计和实验,具体的文章链接 https://arx…
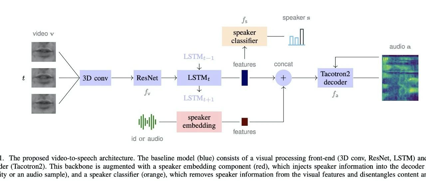
本文为University POLITEHNICA of Bucharest Bucharest, Romania在2021.05.20更新的文章,主要研究领域为video-to-speech。 具体的链接:https://arxiv.or…
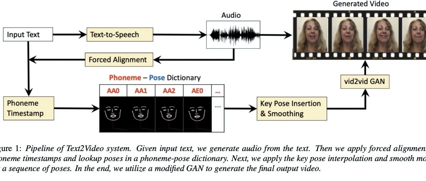
本文是Baidu Research, USA在2021.04.29更新的文章,主要工作为多模态的talking-head,把text转成video 具体的文章链接: https://arxiv.org/pdf/2104.14631.pdf…
The Multi-speaker Multi-style Voice Cloning Challenge 2021是爱奇艺、北京希尔贝壳科技有限公司、西北工业大学音频语音与语言处理研究组、清华大学深圳国际研究生院、新加坡国立大学、起源智能…
歌唱合成SVS(singing voice synthesis)是根据歌词和乐谱信息合成歌唱,相比于TTS使机器“开口说话”,歌唱合成则是让机器唱歌,因此更具有欣赏性。 互联网的时代,人机交互更加频繁和智能,歌唱合成则添加了人机交互的趣味性…
基于深度学习的端到端语音合成技术进展显著,但经典自回归模型存在生成速度慢、稳定性和可控性差的问题。 去年,微软亚洲研究院和微软 Azure 语音团队联合浙江大学提出了快速、鲁棒、可控的语音合成系统 FastSpeech,近日研究团队又将该技…
随着深度学习技术的发展,语音合成技术也经历了从传统的基于参数合成(HTS)至基于深度神经网络的样本级合成(Parallel WaveNet)的变革。相比与传统方法,基于神经网络的新方法在语音的自然度与可理解性上都有了突破性的提升;然而,新方…
最近微软发布了一个新模型NaturalSpeech,在语音合成领域首次达到人类水平,人耳难分真假。 现在很多视频都不采用人类配音,而是让「佟掌柜」、「东北大哥」等角色友情客串,在读起文本来还真有点意思。 相比之前机械化的电子音来说,文本转语…