论文分享:基于注意力机制端到端鲁棒语音识别建模中的对抗正则化

ASLP嗑盐君 音频语音与语言处理研究组 2019-08-29近期,实验室孙思宁、郭鹏程同学的论文“Adversarial Regularization for Attention Based End-to-End Robust Speec…
182 1 0

ASLP嗑盐君 音频语音与语言处理研究组 2019-08-29近期,实验室孙思宁、郭鹏程同学的论文“Adversarial Regularization for Attention Based End-to-End Robust Speec…
端到端 (End-to-end, E2E) 模型得益于其简洁的模型结构和优异的模型性能,已经成为各种序列到序列任务中的主导模型,如机器翻译 (Neural machine translation, NMT) 、语音识别 (Automatic…
近期,实验室王雄、姚卓远、石宪同学的论文“CASCADE RNN-TRANSDUCER: SYLLABLE BASED STREAMING ON-DEVICE MANDARIN SPEECH RECOGNITION WITH A SYLLA…
语音识别(Auto Speech Recognition, ASR)技术是一种将连续的语音信号转化为文本的技术,近年来,随着深度学习的蓬勃发展,端到端(End-to-End,E2E)语音识别技术以其简单的体系结构和优异的性能广受青睐。RNN…

声明:平时看些文章做些笔记分享出来,文章中难免存在错误的地方,还望大家海涵。平时搜集一些资料,方便查阅学习(如转载,请标明出处): TTS 论文列表:http://yqli.tech/page/tts_paper.html TTS 开源数据…
DJI影像团队,聚集了众多来自亚太和欧洲的顶尖技术专家,是一支以创造世界一流音视频产品为目标、致力于将技术与艺术完美融合的多元化研发队伍。 Base:上海、深圳 联系方式:微信18817302088,邮箱xr.yang@dji.com 语音…
文章目录 前言 语音识别原理 信号处理,声学特征提取 识别字符,组成文本 声学模型 语言模型 词汇模型 语音声学特征提取:MFCC和LogFBank算法的原理 实战一:ASR语音识别模型系统的流程基于HTTP协议的API接口客户端未来 实战…
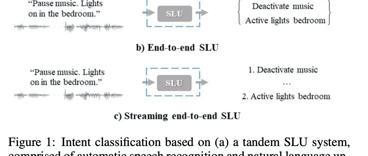
A Streaming End-to-End Framework For Spoken Language Understanding 本文为滑铁卢大学在2021.05.20更新的文章,主要做流式口语理解的工作。 具体文章链接 : https…
根据3月29日在上海召开的全国声学大会语言声学分论坛上的现场报告整理而成。 报告摘要 在深度学习的推动下,语音识别取得了显著进展,但语音识别相关产品在落地上并不尽如人意。因此,在语音识别的基础技术上进行大胆创新,突破现有技术的边界,是人工智…