腾讯开源文本到音频生成模型 EzAudio

近日,约翰霍普金斯大学与腾讯 AI 实验室联合推出了一款名为 EzAudio 的新型文本到音频生成模型。和之前发布的audiocraft和 Stable Audio Tools 类似,都可以通过一段提示词生成对应逼真的音频文件。 EzAud…
5 0 0

近日,约翰霍普金斯大学与腾讯 AI 实验室联合推出了一款名为 EzAudio 的新型文本到音频生成模型。和之前发布的audiocraft和 Stable Audio Tools 类似,都可以通过一段提示词生成对应逼真的音频文件。 EzAud…
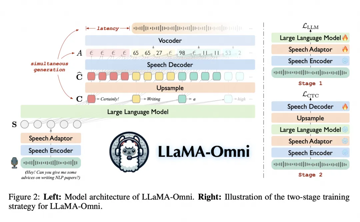
随着GPT-4o的发布,在语音界面的Voice-Chat越来越受到大家的关注,对于低延迟,高准确性模型的speech-to-speech的需求日益增长,来自中科院计算所NLP组的LLaMA-Omni 有效的解决了这样的需求,该模型整合了预训…
今天凌晨,OpenAI在美国旧金山召开了第二届开发者大会,发布了4大新的API功能。 实时语音API:每个APP里都可以拥有“Her”; 视觉微调API:只需100张图提升GPT-4o特定任务图像理解能力; 自动提示词缓存:模型最近见过的输…
来源丨图灵AI云 Meta AI最近发布了 Llama 3.2。这是他们第一次推出可以同时处理文字和图片的多模态模型。这个版本主要关注两个方面: 视觉功能:他们现在有了能处理图片的模型,参数量从11亿到90亿不等。 轻量级模型:这些模型参数…
来源丨新智元 Deepfake到底有多可怕?国外一名律师的父亲,险些陷入一场巨大AI骗局。诈骗者借助AI克隆其儿子的声音,伪造车祸事故要挟3万保释金。GenAI技术犯罪泛滥同时,科学家们也在寻找破魔之道。 AI泛滥成灾的时代,真假孰能分辨?…
太初电子 太初元碁(太初(无锡)电子科技有限公司)是由国家超级计算无锡中心孵化的高性能人工智能产业化公司,致力于发展世界领先的自主可控高性能计算技术和生态。公司主要业务方向为研发自主可控的高性能计算产品、系统集成技术与全栈软件生态,面向政府…
来源丨新智元 SafeEar是一种内容隐私保护的语音伪造检测方法,其核心是设计基于神经音频编解码器的解耦模型,分离语音声学与语义信息,仅利用声学信息检测,包括前端解耦模型、瓶颈层和混淆层、伪造检测器、真实环境增强四部分。 论文地址:
在 AI 领域,有两大场景对 GPU 的需求最大,一个是模型训练,另一个是 AI 推理任务。但是很多人多可能在最开始为自己的项目做 GPU 选型时,都很难判断哪些 GPU 适合做模型训练,哪些 GPU 更适合去做推理任务。所以我们通过这篇文…
来源丨新智元 两个多月前那个对标GPT-4o的端到端语音模型,终于开源了。大神Karpathy体验之后表示:nice! 论文地址:https://kyutai.org/Moshi.pdf
吉利汽车发布最新HAM-TTS大模型,在发音准确性、自然度和说话人相似度上对比之前SOTA成果VALL-E,有了大幅提升。 论文地址:https://arxiv.org/abs/2403.05989 吉利自研语音大模型HAM-TTS的全称是…