
声浪

恒玄科技 | 招聘信号处理算法工程师(上海)

恒玄科技 恒玄科技主要从事智能音频SoC芯片的研发,设计与销售,为客户提供AIoT场景下具有语音交互能力的边缘智能主控平台芯片,产品广泛应用于智能蓝牙耳机,Type-C耳机,智能音箱等智能终端产品。恒玄科技致力于成为全球最具创新力的芯片设计…
22 0 0
语音识别领域迎来新王者,Rev 发布 Reverb ASR
近日,Rev发布了Reverb ASR模型,被大家成为"Whisper终结者",在语音识别和说话人分离方面树立了新的标杆。该模型将其权重公开于Hugging Face Hub。 模型仓库:https://huggingface.co/Rev…
11 0 0
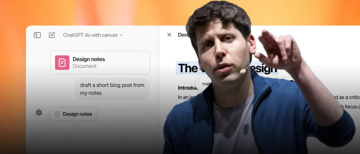
OpenAI canvas一夜封神!超强AI编码研究神器,ChatGPT再次颠覆人机交互
来源丨新智元 ChatGPT横空出世以来,首次迎来界面史诗级升级!全新canvas界面,开启了人类与AI协作研究、编码的新时代,更代表着终极AGI人机交互形态。 时隔两年,ChatGPT终迎来界面全新升级! 这一次,OpenAI官宣推出ca…
11 0 0
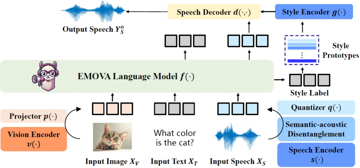
mini-GPT4o来了? 能看、能听、会说,还情感丰富的多模态全能助手EMOVA
本文作者来自香港科技大学、香港大学和华为诺亚方舟实验室等机构。其中第一作者陈铠、苟耘豪、刘智立为香港科技大学在读博士生,黄润辉为香港大学在读博士生,谭达新为诺亚方舟实验室研究员。 随着 OpenAI GPT-4o 的发布,大语言模型已经不再…
11 0 0
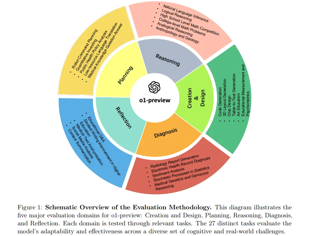
280页PDF,全方位评估OpenAI o1
OpenAI 的 o1-preview 模型已经发布两周了,网上也有了很多零星的测评。不过,大部分测评都侧重于某一个方面,对于 o1-preview 的系统评估目前还比较匮乏。 在一篇长达 280 页的论文中,来自加拿大阿尔伯塔大学等机构的…
12 0 0
腾讯开源文本到音频生成模型 EzAudio
近日,约翰霍普金斯大学与腾讯 AI 实验室联合推出了一款名为 EzAudio 的新型文本到音频生成模型。和之前发布的audiocraft和 Stable Audio Tools 类似,都可以通过一段提示词生成对应逼真的音频文件。 EzAud…
9 0 0
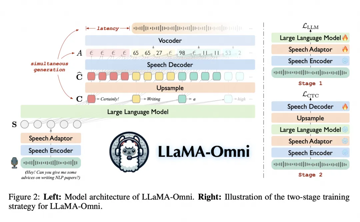
LLaMA-Omni 低延迟高质量语音交互,开源!
随着GPT-4o的发布,在语音界面的Voice-Chat越来越受到大家的关注,对于低延迟,高准确性模型的speech-to-speech的需求日益增长,来自中科院计算所NLP组的LLaMA-Omni 有效的解决了这样的需求,该模型整合了预训…
11 0 0
OpenAI DevDay 大会发布4款重磅API功能,处理量增加50倍!
今天凌晨,OpenAI在美国旧金山召开了第二届开发者大会,发布了4大新的API功能。 实时语音API:每个APP里都可以拥有“Her”; 视觉微调API:只需100张图提升GPT-4o特定任务图像理解能力; 自动提示词缓存:模型最近见过的输…
9 0 0
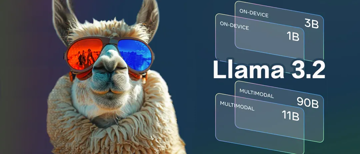
一文详解:最新版本 Llama 3.2
来源丨图灵AI云 Meta AI最近发布了 Llama 3.2。这是他们第一次推出可以同时处理文字和图片的多模态模型。这个版本主要关注两个方面: 视觉功能:他们现在有了能处理图片的模型,参数量从11亿到90亿不等。 轻量级模型:这些模型参数…
9 0 0