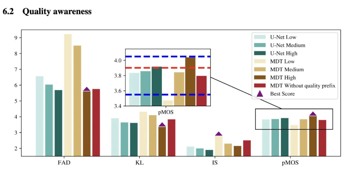
中科大与科大讯飞研究团队开源音乐文本控制音乐生成模型,效果惊艳!

中科大与科大讯飞研究团队开源高质量音乐文本控制音乐生成模型,轻松实现震撼生成效果! 论文地址:https://arxiv.org/pdf/2405.15863 开源地址:https://github.com/ivcylc/qa-mdt De…
10 0 0

中科大与科大讯飞研究团队开源高质量音乐文本控制音乐生成模型,轻松实现震撼生成效果! 论文地址:https://arxiv.org/pdf/2405.15863 开源地址:https://github.com/ivcylc/qa-mdt De…
大模型领域的技术发展,今天起再次「从 1 开始」了。 就在刚刚,OpenAI最强的o1系列模型忽然上线。毫无预警地,OpenAI就扔出这一声炸雷。传说中两周内就要上线的草莓模型,居然两天内就来了! 从今天开始,o1-preview在Chat…
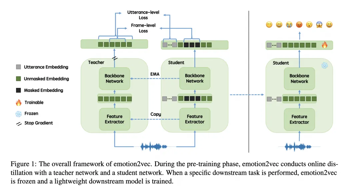
本期分享一篇语音情感表征学习方向的文章,该文章发表于Findings of ACL2024。 Emotion2vec: Self-Supervised Pre-Training for Speech Emotion Representati…
说话人转换检测(Speaker Change Detection, SCD)旨在识别对话中不同说话人之间的边界,并常被视为说话人日志(Speaker Diarization, SD)的子任务,具有广泛的应用。最近,微调 wav2vec 2.…
Mini-Omni是一个开源多模态大型语言模型,具备实时对话能力和端到端的语音输入输出功能。通过独特的文本指导并行生成方法,实现了与文本能力一致的语音推理输出,仅需极少的额外数据和模块。 论文题目:Mini-Omni: Language M…
本文整理了一些近期发表的声学相关论文,供大家了解科研进展。 1.基于复合谐振腔的多频带声波受控传输 出版日期:2024-09-06 DOI:10.1007/s00339-024-07885-x 作者:肖亮, 张智 , 褚佳明 , 罗江霞 ,…
在生成式AI领域,随着大模型多模态交互能力的升级,RTC技术推动人与AI的互动超越文字,实现生动、流畅的低延迟语音通话。随着GPT-4o的发布,标志着AI实时语音交互的突破。之前传统大模型虽具备语音交互,但通常使用WebSocket方案,这…
苹果在昨天举办的产品发布会上宣布,将最新开发的 “Apple Intelligence”集成在iPhone 16、iPad 平板和Mac笔记本中,全面拥抱生成式AI。 其中,Siri已经集成了OpenAI的ChatGPT(GPT-4o)功能…

