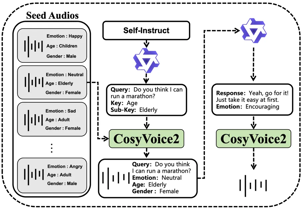
完全透明开源的共情语音大模型,三阶段训练,四大模块实现端到端对话

紫东太初团队联合长城汽车AI Lab推出完全透明开源的端到端共情语音语言大模型OpenS2S。 论文地址:https://arxiv.org/pdf/2507.05177 Demo地址:https://casia-lm.github.io/…
22 0 0

紫东太初团队联合长城汽车AI Lab推出完全透明开源的端到端共情语音语言大模型OpenS2S。 论文地址:https://arxiv.org/pdf/2507.05177 Demo地址:https://casia-lm.github.io/…
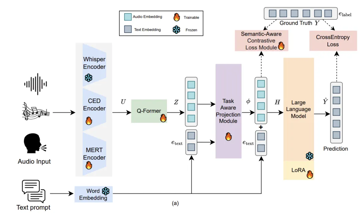
在通用人工智能(AGI)备受瞩目的今天,音频大模型的研究也正快速推进。但相比图文多模态的成熟体系,音频领域仍面临巨大的挑战。不同类型的音频任务——如语音识别、音频事件检测、音乐理解等——往往“各自为政”,难以统一建模。为解决上述问题,西工大…
本文由清华大学与香港中文大学、腾讯AI Lab合作,提出了基于大语言模型(LLM)的通用目标音频分离方法:UniSep,实现了对任意混合音频的目标分离。与以往只针对单一领域或单一源的分离工作不同,UniSep支持任意类型音频的目标分离。通过…
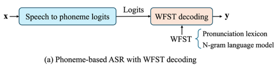
语音与语言如何连接,机器耳朵与大脑如何高效协同?本文工作给出了探索回答。在自动语音识别(ASR)中,基于音素的多语种预训练与跨语言微调因其出色的数据利用效率和相较于基于子词模型的性能优势,正受到越来越多的关注。然而,传统的加权有限状态转换器…
阿尔兹海默病(Alzheimer'sDisease,AD)是一种以认知能力下降和记忆丧失为特征的渐进性神经退行性疾病,及早发现对于其干预和治疗至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种将停顿信息进行编码,并与语言…
语音大语言模型(Spoken Language Model, SLM)正在引领人工智能领域的新一轮革新浪潮。正如文本自然语言处理从任务特定模型迈向通用大语言模型的演进,语音领域也正在经历类似转型。 为填补该领域系统性综述的空白,芝加哥大学、…
大型语言模型(LLMs)在各种下游任务中取得了显著进展,启发了业界对语音理解语言模型(speech understanding language models, SULMs)的研发,以期实现基于语音情感、性别等副语言的高表现力交互。然而,大…
当前广泛流行的基于 LLaVA 结构的多模态大语言模型(LMM: Large Multimodal Model)在视觉任务上表现出色,然而因为训练中需要对内嵌的语言模型进行微调,常常会显著削弱其在自然语言任务(NLP)上的能力,具体来说,模…
SpeechGPT2 是由复旦大学计算机学院开发的一个端到端的语音对话语言模型,类似于 GPT-4o。能够感知并表达情感,并根据上下文和人类指令以多种风格提供合适的语音响应。如说唱、戏剧、机器人、搞笑和低语等。 项目地址:https://0…
苹果发布基于开源训练和推理框架的高效语言模型族 OpenELM。 要说 ChatGPT 拉开了大模型竞赛的序幕,那么 Meta 开源 Llama 系列模型则掀起了开源领域的热潮。在这当中,苹果似乎掀起的水花不是很大。 不过,苹果最新放出的论…