阿里全新Qwen3-TTS模型!支持跨物种音色克隆,3 秒复刻!

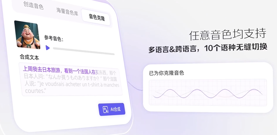
说实话,今年语音模型的内卷程度已经到了不讲武德的地步。但这次,Qwen3-TTS 的更新,是真的有点狠。 阿里通义刚刚上线了 Qwen3-TTS 的两大核心能力: •VoiceDesign(VD-Flash):用文字“设计”声音,而不是选声…
21 0 0

说实话,今年语音模型的内卷程度已经到了不讲武德的地步。但这次,Qwen3-TTS 的更新,是真的有点狠。 阿里通义刚刚上线了 Qwen3-TTS 的两大核心能力: •VoiceDesign(VD-Flash):用文字“设计”声音,而不是选声…
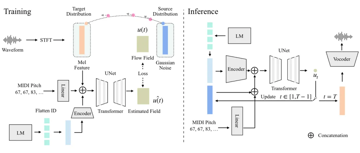
标题:Adapting Speech Language Model to Singing Voice Synthesis 链接:https://arxiv.org/pdf/2512.14657 作者单位:卡内基梅隆大学、中国人民大学、约翰霍…
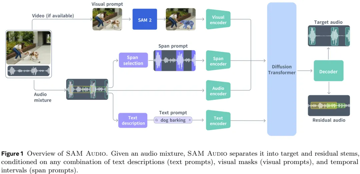
继 SAM(Segment Anything Model)、SAM 3D后,Meta 又有了新动作。 深夜,Meta 放出音频分割模型SAM Audio,其通过多模态提示(无论是文本、视觉,还是标注时间片段),让人们能够轻松地从复杂的音频混…