论文推介:腾讯天籁实验室-西工大ICASSP2022 DNS竞赛两阶段个性化语音增强系统

作者:琚雨恺 个性化语音增强(personalized speech enhancement, PSE)也称为目标说话人提取(target speaker extraction,TSE),其主要目的是通过目标说话人的注册语音从复杂的受干扰的…
318 2 0

作者:琚雨恺 个性化语音增强(personalized speech enhancement, PSE)也称为目标说话人提取(target speaker extraction,TSE),其主要目的是通过目标说话人的注册语音从复杂的受干扰的…
声纹识别是指从说话人的语音信号中提取声纹特征,并通过有效的分类识别模型,对说话人的身份进行校验和鉴别。声纹识别广泛应用于刑侦、人机交互声纹口令验证、银行声纹身份验证等领域。当前的声纹识别系统通常包括两个模块:神经网络特征提取前端和概率线性判…
文章来源于阿里语音AI,作者达摩院语音实验室 本文介绍在语音翻译任务中,通过一个跨模态的 prefix network 来适配多语言文本预训练模型的新方式。 / ICASSP收录论文 / CPT: Cross-Modal Prefix-Tu…
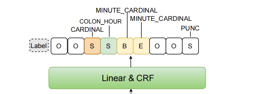
本文由清华大学、标贝科技有限公司、香港中文大学合作,提出了一种将规则、词典和神经网络融合于一体的端到端中文文本正则化模型。该模型结合了规则和词典的可扩展性、神经网络的上下文建模及高效利用大数据的能力,通过规则和词典等在神经网络模型推理的过程…
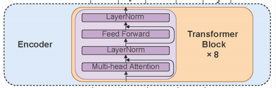
本文由清华大学与香港中文大学、北京世纪好未来教育科技有限公司合作,提出了一种面向语音合成的基于跨度(span)的端到端韵律结构预测模型SpanPSP,该模型直接接受汉字字符序列作为输入,不需要任何的分词、词性标注等预处理,且相比于现有的所有…
小冰 小冰公司的前身是微软亚洲互联网工程院的人工智能小冰团队。该团队于2013年12月在北京组建,2014年9月在日本东京建立了研发分部。目前整个团队分布于北京、苏州和东京三地。作为微软全球首个以中国为总部的人工智能产品线,小冰历经多年发展…
仙豆智能 仙豆智能成立于2019年3月,是一家面向万物互联时代专注于出行场景的科技公司,助力汽车行业的数字化升级,从汽车制造商变革为用户服务商。 仙豆智能构建的基于双智融合(智能驾驶和智能座舱)的整车产品智能化、智能营销多端整体解决方案及各…
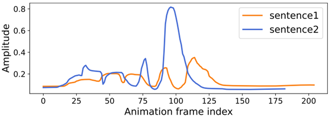
本文由清华大学与上海交通大学、微软中国合作,提出了一种从语音预测虚拟人脸部动画参数(Speech-to-Animation, S2A)的方法,能够稳定且高效地生成与语音内容同步的面部表情动作。与传统方法相比,本文利用音素后验概率图来表征语音…
论文转载厦大智能语音实验室 声纹识别是指从说话人的语音信号中提取声纹特征,并通过有效的分类识别模型,对说话人的身份进行校验和鉴别。声纹识别广泛应用于刑侦、人机交互声纹口令验证、银行声纹身份验证等领域。当前的声纹识别系统通常包括两个模块:神经…
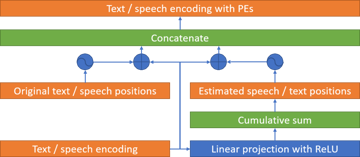
本文由清华大学与香港中文大学、字节跳动公司合作,提出了一种新的双向注意力机制(bidirectional attention mechanism)以及基于该机制的神经网络强制对齐(forced alignment)模型NeuFA。该模型基于…