
声浪

缓解 TTS 的重复与漏读:用注意力引导消除语音合成中的稳定性幻觉

近年来,基于大语言模型的语音合成技术快速发展。在普通文本上,模型已经能够稳定生成自然度很高、音色也足够相似的语音。然而,一旦遇到复杂生僻词、排比句或连续重复结构,重复、漏读甚至无限循环等稳定性幻觉仍然可能出现。 这背后有一个基础问题: 语音…
30 0 0
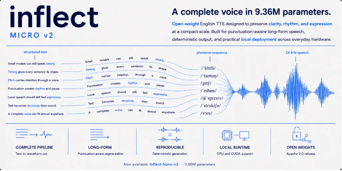
9.36M 参数做出顶级 TTS:Inflect v2,人声盲听66%胜率
以下文章来源:努力犯错玩AI 近日,独立开发者 Owen Song 发布了 Inflect v2。这是一个极致轻量的英文语音合成模型。Micro 版只有 9.36M 参数,FP32 权重只有 37.5MB。Nano 版更是只有 3.97M…
50 0 0
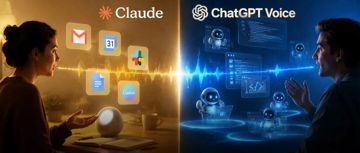
刚刚,Claude爆改语音!11种语言,就是没中文
来源丨新智元 刚刚,Anthropic和OpenAI同时放出了语音模式大升级! Claude这边,从只能跑Haiku升级到Opus 4.8和Sonnet 5全系列,不仅能在对话里调Gmail、日历、Slack,还扩增到11种语言,但没有中文…
34 0 0
Interspeech 2026|Decoding the Ear(DeEAR):从人类偏好中客观量化语音表现力的对齐框架
近年来,端到端口语对话(S2S)与语音合成(TTS)技术正加速从“可懂、可用”向“自然、拟人”发展。尤其在智能座舱、语音助手等实际应用场景中,用户对语音交互的期待已不再局限于内容准确,还希望模型能够展现接近真人的表现力,包括细腻的情绪起伏、…
24 0 0