声浪

OmniAvatar:夸克技术团队 x 浙江大学联合开源,音频驱动全身视频生成模型

近期,夸克技术团队和浙江大学联合开源了OmniAvatar,这是一个创新的音频驱动全身视频生成模型,只需要输入一张图片和一段音频,OmniAvatar即可生成相应视频,且显著提升了画面中人物的唇形同步细节和全身动作的流畅性。此外,还可通过提…
15 0 0
李沐老师也出手了,教你手搓语音大模型,代码全开源还能在线试玩!
来源丨量子位 李沐老师终于带着他的手搓语音大模型教程回归了,一千万小时音频数据训练的TTS,效果秒杀一众商业&开源的TTS。 本期视频不讲论文,李沐老师来手把手教大家怎样玩转他们团队最新研发的Higgs Audio V2模型,不仅能处理文本…
25 0 0
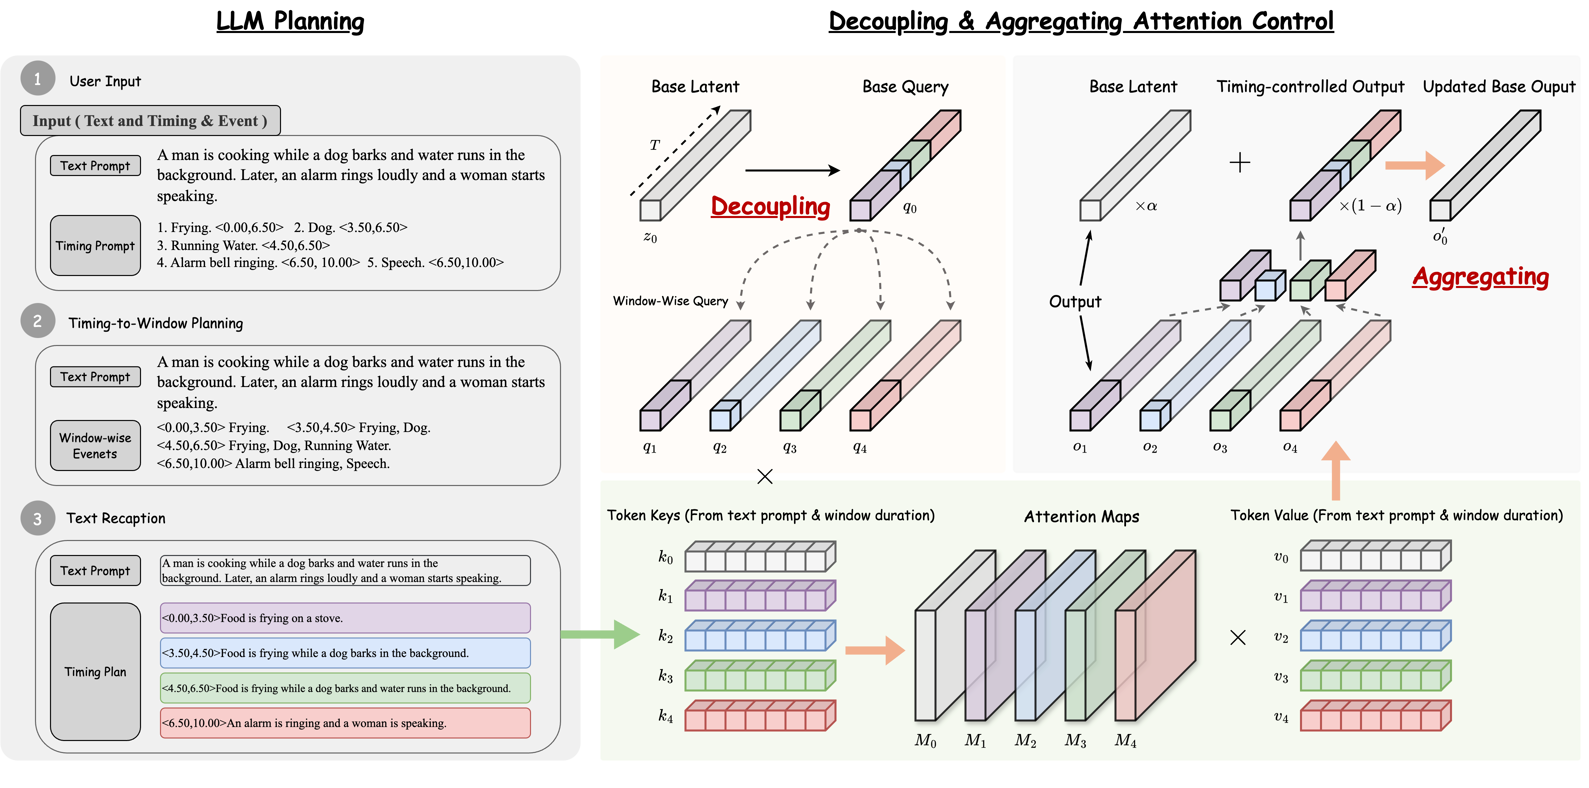
影视配乐、游戏音效革命:清华大学 & 生数科技 ACM MM 2025 最新研究让 AI 生成时间可控长时音频
文生音频系统(Text-to-audio generation, T2A)在生成模型的持续发展下取得了显著的进展。然而,由于精确时间对齐的音频-文本数据对在质量和数量上的限制,现有 T2A 系统在面对包含精确时间控制的复杂文本提示时表现仍然…
18 0 0
ACM MM 2025|DualDub:同时生成和谐的语音与背景音频,构建完整的视频音轨
当前视频到音频(Video-to-Audio, V2A)模型可以从视觉输入中生成逼真的背景音频,但它们大多忽略了语音在视频音轨中的关键组成部分。近期,西工大音频语音与语言处理研究组(ASLP@NPU)联合巨人网络、University of…
16 0 0
MM 2025丨ISDrama:通过多模态提示实现沉浸式空间戏剧生成
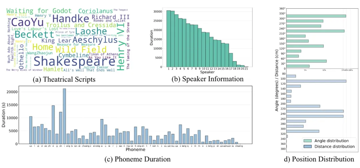
多模态沉浸式空间戏剧生成旨在基于多模态提示,创建具有戏剧韵律的连续多说话人双耳语音,在增强现实(AR)、虚拟现实(VR)等领域具有潜在应用。这项任务需要基于多模态输入同时对空间信息和戏剧韵律进行建模,且数据收集成本较高。 为此,浙江大学的学…
14 0 0