百度开源轻量级音频大模型Eureka-Audio

标题:Eureka-Audio: Triggering Audio Intelligence in Compact Language Models 链接:https://arxiv.org/pdf/2602.13954 发表日期:2026年…
39 0 0

标题:Eureka-Audio: Triggering Audio Intelligence in Compact Language Models 链接:https://arxiv.org/pdf/2602.13954 发表日期:2026年…
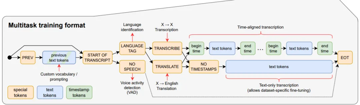
whisper是一个支持多语种(高达99种)和多任务的音频大模型,相对于k2(zipformer)、funasr(paraformer)等流行的E2E单任务语音识别模型,whisper最大的两个特点是“大而全”:其中大是指68万小时的大数据…
