IEEE TASLP | FPO: 细粒度偏好优化提升零样本TTS鲁棒性

近年来,基于大语言模型(LLM)的零样本文本转语音(Zero-shot TTS)系统发展迅速,已经能够在仅提供几秒参考音频的情况下,合成自然、清晰、且具有说话人风格的语音。然而,即便是最先进的系统,在真实使用场景中仍然频繁出现一些“局部灾难…
12 0 0

近年来,基于大语言模型(LLM)的零样本文本转语音(Zero-shot TTS)系统发展迅速,已经能够在仅提供几秒参考音频的情况下,合成自然、清晰、且具有说话人风格的语音。然而,即便是最先进的系统,在真实使用场景中仍然频繁出现一些“局部灾难…
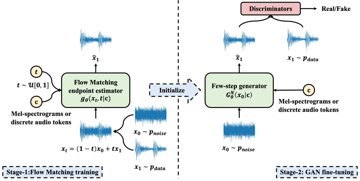
新一代 Kaldi 团队近日开源了一个自研音频生成模型(声码器)Flow2GAN,质量高、速度快、好训练,是 BigVGAN 一个不错的替代方案,欢迎体验。 论文:Flow2GAN: Hybrid Flow Matching and GAN…
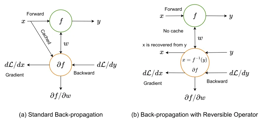
随着深度学习技术在语音领域的广泛应用,说话人验证(Speaker Verification, SV)系统正朝着更深、更大的神经网络架构演进。以 ResNet101、DF-ResNet 等为代表的深度嵌入提取器显著提升了系统性能,但其高昂的…
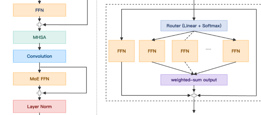
基于热词检索与强化学习的 LLM-ASR 上下文偏置新框架。 论文:Contextual Biasing for LLM-based ASR with Hotword Retrieval and Reinforcement Learning…
来源丨新智元 你有没有发现,你让AI读一篇长文章,结果它读着读着就忘了前面的内容? 你让它处理一份超长的文档,结果它给出来的答案,牛头不对马嘴? 这个现象,学术界有个专门的名词,叫做上下文腐化。 这也是目前AI的通病:大模型的记忆力太差了,…
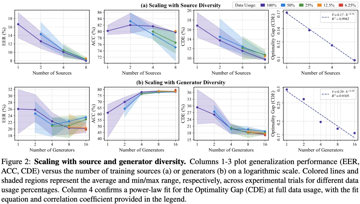
在生成式 AI 技术日新月异的背景下,合成语音的逼真度已达到真假难辨的水平,随之而来的语音欺诈与信息伪造风险也愈演愈烈。作为应对手段,语音鉴伪技术已成为信息安全领域的研究重心。 然而,当前的语音鉴伪模型正面临严峻的「泛化性挑战」:许多在特定…
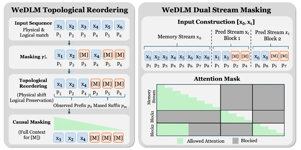
来源丨机器之心 讯微信 AI 团队提出 WeDLM(WeChat Diffusion Language Model),通过在标准因果注意力下实现扩散式解码,在数学推理等任务上实现相比 vLLM 部署的 AR 模型 3 倍以上加速,低熵场景更…
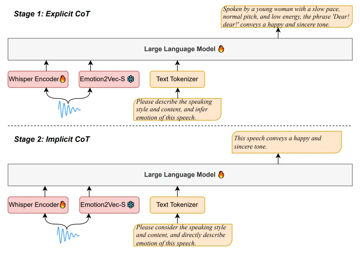
语音情感识别(Speech Emotion Recognition, SER)旨在从语音信号中自动识别说话人的情感状态,是实现自然人机交互和情感计算的关键技术。随着大型音频语言模型(Audio Language Models, ALMs)的…
