
 语音小管家
论文题目:RealComm: Benchmarking and Adapting Audio Deepfake Detection over Real Communication Channels
文章链接:https://wwwwwli.github.io/RealComm/downloads/RealComm.pdf
项目主页与音频演示:https://wwwwwli.github.io/RealComm/
一段合成语音经过手机通话后,还能被检测器可靠地识别吗?外部播放、麦克风采集、设备处理和通话传输,都会改变接听方最终收到的声音。数字文件上的鉴伪能力,能否保持到通话之后,需要直接验证。
图 1|AI 生成的场景示意,非真实事件。声音听起来像熟人,并不等于身份已经得到验证。
RealComm 是一个面向真实通话信道的音频鉴伪数据集与评测基准。 它把同一段语音的数字原始版本与真实通话录音逐一配对,研究检测器在哪些条件下容易失效,并探索模拟增强与真实通话训练能带来多少改善。
RealComm 的早期工作已获 IEEE SLT 接收。本文介绍项目的后续扩展,包括更丰富的配对条件、信号分析与适配实验,已投稿至 TASLP。
把同一段语音送进真实通话
同一句话,在不同通话条件下反复录制,才能更直接地比较信道带来的变化。 RealComm 包含中文和英文、真实语音与七种语音合成系统生成的语音。真实与合成语音经过相同的录制条件,每条通话录音都保留与数字原始语音的对应关系。
采集覆盖两种注入方式:通过扬声器播放、由手机麦克风接收的声学注入(OtA),以及通过线缆接入手机麦克风输入的有线注入(LtM)。此外,还比较主叫端的手持与免提模式、不同主叫与接听设备组合,以及可控降噪功能的开关状态。
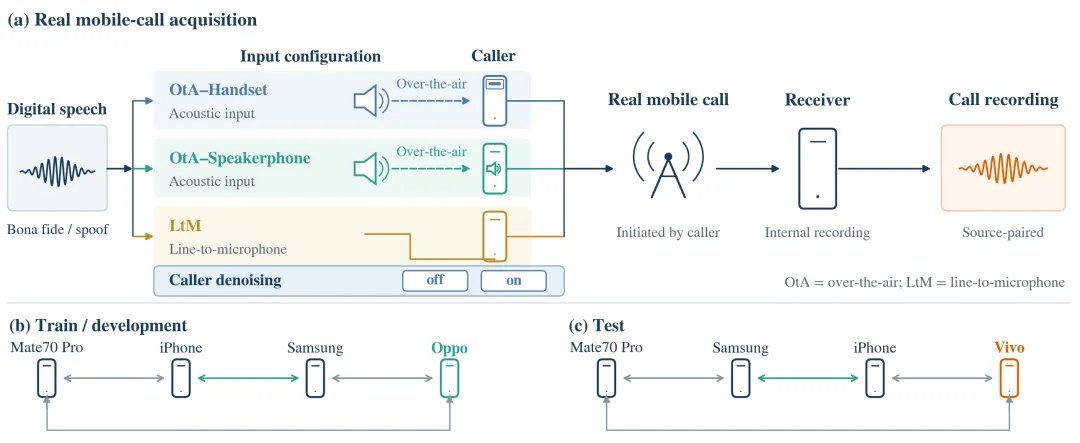
图 2|真实通话采集流程及训练、测试设备组合。训练与测试使用部分重叠的设备路线,Vivo 仅出现在测试中;同一源语音的不同版本始终保留在同一数据划分。
测试部分 RealCommBench 包含 23,520 条通话录音,对应 560 条数字原始语音、42 种录制条件。这种配对设计让我们能够比较同一内容经过通话前后的检测结果,而不是把两个来源不同的语音集合直接作比较。
通话显著降低鉴伪性能,声学注入更难
在论文主要比较的检测器中,通话后的等错误率(EER,越低越好)均增加了 30 个百分点以上。 例如,WavLM-L 从数字语音上的 4.64% 升至真实通话上的 40.00%。数字文件上表现良好,并不意味着经过通话后仍能保持同样的检测能力。
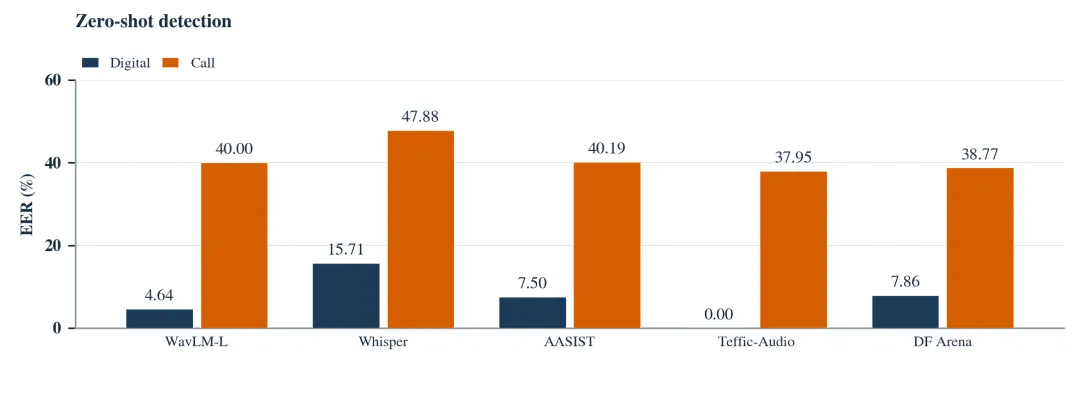
图 3|相同源语音在数字域与通话域中的检测结果。橙色柱表示真实通话,EER 越高表示鉴伪越困难。
声学注入比有线注入更难检测。 这一趋势在匹配设备路线与降噪状态后仍然成立,说明扬声器播放和麦克风采集这一环节值得重点关注。对于可控降噪,在匹配样本的汇总结果中,各检测器的 EER 均有所下降,但具体通话条件下仍可能出现性能回退。
音质变化与鉴伪退化有关,但不能只看高频是否丢失。 比较不同录制条件时,语音质量下降通常伴随更大的检测退化;高频衰减程度却不能单独解释哪些条件更难。这些分析帮助我们理解信号变化,也说明音质指标不能代替实际鉴伪评测。
用模拟增强与真实通话训练缓解退化
RealComm-Aug 沿着信号传递过程组织增强,让训练语音经历更丰富的采集与传输变化。它覆盖环境噪声、混响、设备响应、编码压缩和通话传输等环节;噪声、混响等常用增强可以独立使用,也可以与后续处理组合。真实语音与合成语音使用相同的增强采样分布。
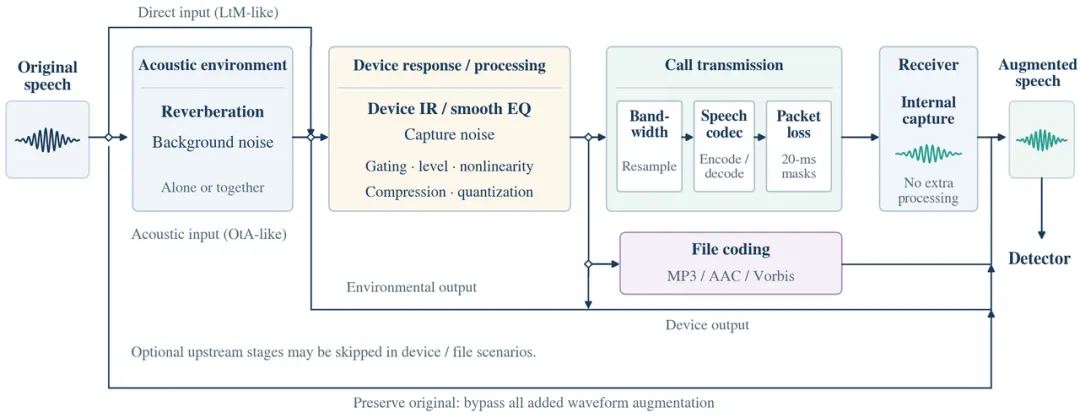
图 4|RealComm-Aug 增强流程。先选择处理路径,再采样该路径的操作及参数;并非每段语音都会经过所有处理。
我们比较四种设置:原模型 F、仅使用模拟增强进行微调 A、加入真实通话训练数据进行微调 T,以及二者结合的 A+T。所有适配均从同一个对应模型的 F 检查点开始。
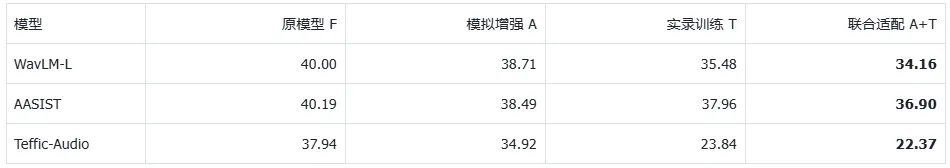
RealCommBench 上的 EER(%,越低越好)。
模拟增强与实录训练具有互补收益,联合适配在三个模型上均取得最低的通话域整体 EER。
以 Teffic-Audio 为例,仅使用模拟增强便将 EER 从 37.94% 降至 34.92%;结合真实通话训练后进一步降至 22.37%,相对原模型降低 15.57 个百分点。
整体改善并不意味着所有场景都已解决:声学注入仍然更难,部分通话条件及外部测试集也存在性能回退。
