
 语音小管家
近年来,大语言模型(Large Language Model, LLM)在语音、图像等多模态领域快速发展,空间智能也成为人工智能的重要方向。空间智能,是机器感知、理解和推理三维物理世界的能力,也是实现全场景智能生态的重要基础。
今天,小米开源 Dasheng 系列的新成员——MiDashengLM-Spatial。该模型以 MiDashengLM-7B 为基座,进一步为声音理解大模型赋予“一双耳朵”,使其不仅能够听懂声音的内容,还能感知声音来自何处、如何在空间中分布。据我们所知,MiDashengLM-Spatial 是业界首个开源的端到端空间音频理解大模型,在保留基础音频理解能力的同时,具备空间感知与推理能力,推动音频大模型从“听懂声音”进一步迈向“理解声音所处的空间”。
- 项目主页:https://jinbo-hu.github.io/midashenglm-spatial-demo/
- 技术报告:https://arxiv.org/abs/2610.11156
- GitHub: https://github.com/xiaomi-research/midashenglm-spatial
- HuggingFace:https://huggingface.co/mispeech/midashenglm-spatial
技术核心
▍双分支音频编码器
当前主流多模态大语言模型在声音、语音和音乐理解方面已展现出优异性能,并在部分基准测试中达到甚至超过人类水平。然而,面对多声道音频,这些模型通常将各声道信号在声道维度上进行简单平均,将其转换为单声道输入,因而缺乏对空间信息的建模能力。
与此同时,多声道音频在格式和声道配置上存在较大差异,相关数据规模也远小于单声道音频。这不仅限制了模型的通用性,也使其难以通过统一的数据扩展实现规模化提升。
基于此,团队最终采用双分支音频编码器方案:利用规模远小于原始 MiDashengLM 音频数据(>100 万小时)的双耳音频数据(~1 万小时),在 MiDashengLM 的基础上扩展空间理解能力,同时保持其通用音频理解性能。
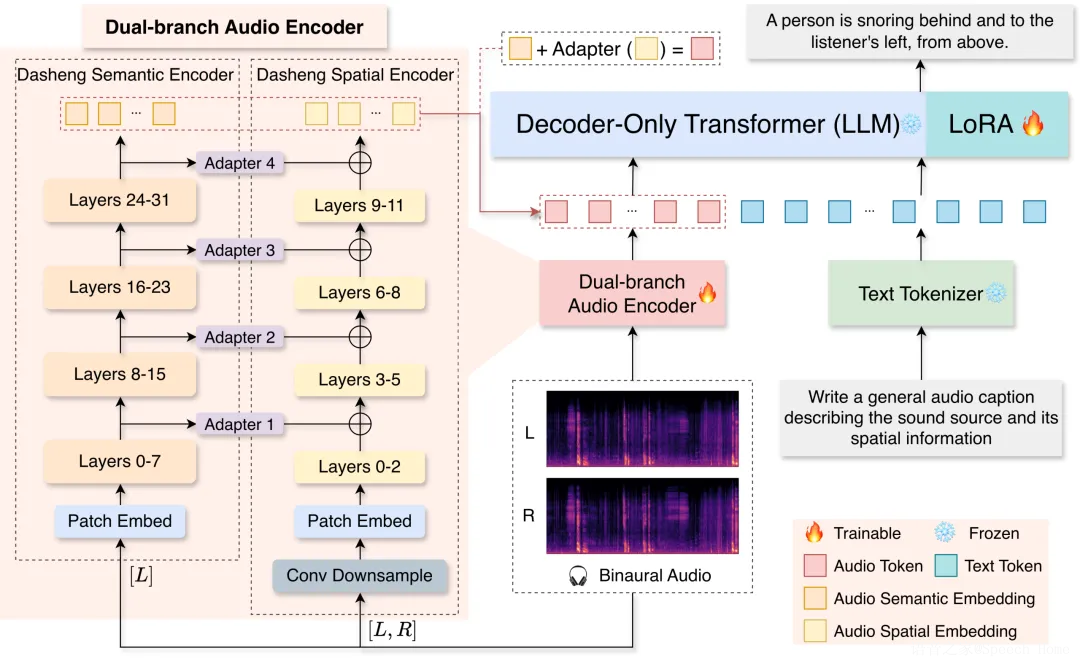
Dasheng Semantic Encoder 完整继承 MiDashengLM 的原有音频编码器,其骨干网络基于 Dasheng-Huge (0.6B);Dasheng Spatial Encoder 则采用轻量化的 Dasheng-Base(86M)架构。两条分支结构同源,参数规模不同,分别负责提取音频的语义信息和空间信息。
两条分支通过跨层语义到空间特征注入 (Hierarchical Semantic-to-Spatial Conditioning) 的方式连接:语义分支不同层级的中间特征经映射后,逐层注入空间分支,与其特征进行融合。该连接方式使空间分支充分利用语义信息,增强对复杂空间声学场景中声源的感知、定位与分离能力;同时,单向注入不改变语义分支原有的信息流,从结构上保持模型通用音频理解能力的稳定性。最终,两条分支分别生成音频语义 Token 和空间 Token,并通过特征映射统一融合为完整的音频 Token,供后续语言模型进行音频理解与空间推理。
▍场景级空间数据合成
空间音频理解不仅需要识别语音、环境声和音乐等基础内容,还需要感知声源的绝对位置、声源之间的相对空间关系,以及声源随时间发生的动态变化。因此,空间与时序信息的联合建模至关重要。
尽管公开音频资源十分丰富,且各类声音已得到系统性收集,但现有数据格式复杂多样,并以单声道音频为主,能够支持空间音频理解的数据仍十分稀缺。为此,团队基于头相关传递函数(Head-Related Transfer Function, HRTF)与虚源法(Image Source Method,ISM)模拟不同室内声学环境,合成时长约 1 分钟的双耳音频场景,包含多个静态或动态声源,如下图所示(俯视图)。
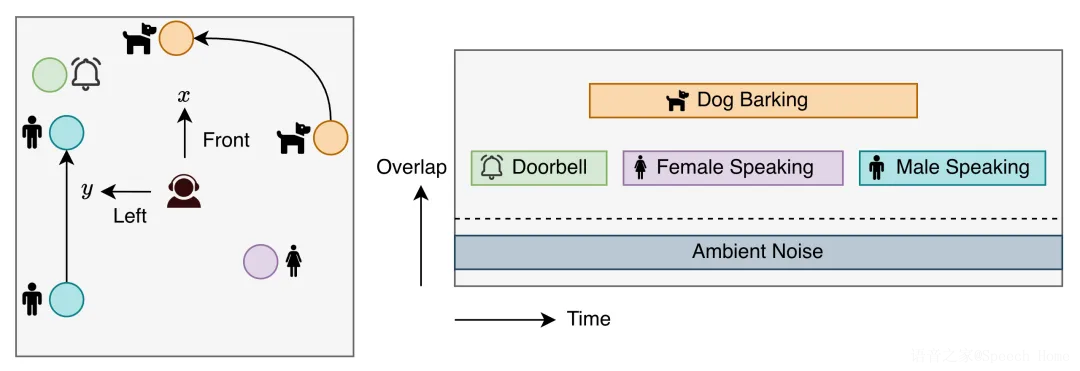
每个声源的语义描述继承自原始单声道数据,其空间位置、运动轨迹和时序变化则由参数化合成过程精确记录。基于这些结构化元数据,团队进一步利用 LLM 生成场景级空间音频描述,构建同时覆盖声音内容、时空关系与动态变化的训练数据。
Spatial Caption: The scene begins with a doorbell ringing in front-left of the listener, overlapping with a dog barking as it moves counter-clockwise from the listener’s front-right and below to directly in front and below. Next, a woman statically positioned behind and to the listener’s right asks, “Who is at the door?” Finally, a man moves from the back-left to the front-left of the listener and says, “I’ll take a look.”
性能评测
▍空间理解:大幅超越主流开闭源模型
MiDashengLM-Spatial 在空间音频理解方面具备显著优势:
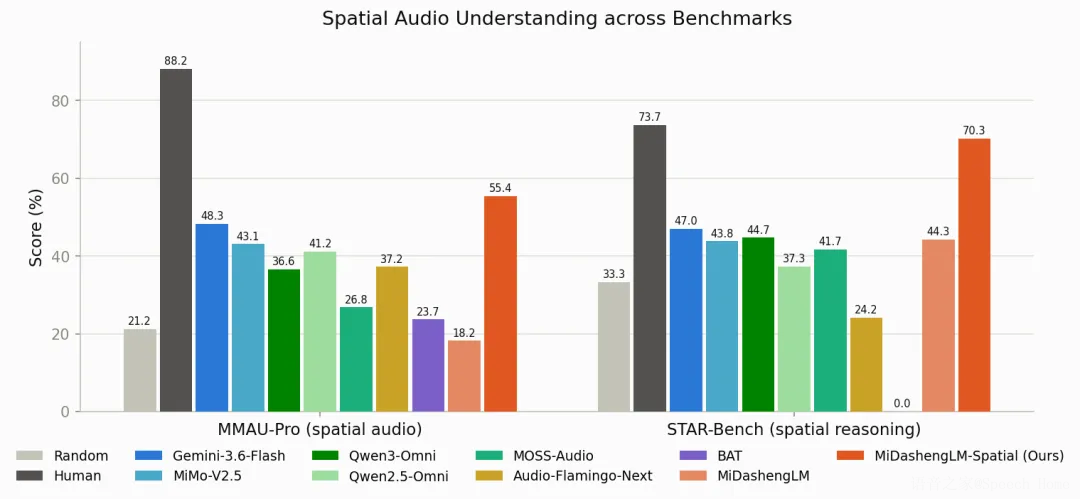
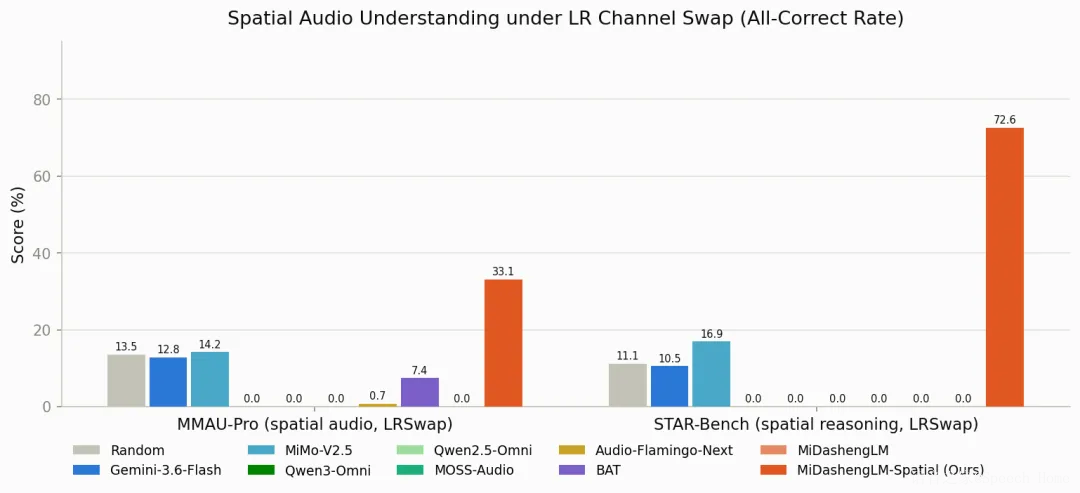
已有研究表明,部分音频理解基准对真实音频能力的要求有限:即使仅依赖语言先验和世界知识,将原始音频替换为高斯噪声,甚至完全屏蔽音频信号,LLM 仍可能取得较高分数。空间音频理解类基准测试也同样发现类似现象,例如,图中所示的单声道音频理解模型(Gemini-3.6-Flash、Qwen3-Omni 和 Moss-Audio)在空间相关任务上的表现均明显高于随机猜测水平。因此团队引入声道轮换(左右声道交换)策略,以进一步检验模型是否真正具备空间听觉能力。
对于双耳音频,声源的左右定位线索通常编码在 IPD 和 ILD 中。若声源位于左侧,交换左右声道后,其空间位置应相应映射到右侧,模型的判断也应随之发生变化。基于该特性,团队选取问答数据中仅涉及左右方向判断的样本,分别评估模型在声道轮换前后的表现,包括预测是否符合空间变化规律,以及交换前后均答对的全正确率(All-Correct Rate)。相比单次问答准确率,该指标能够更有效地检验模型是否真正利用双耳声学线索进行空间理解,而非依赖语言先验或数据偏差作答。
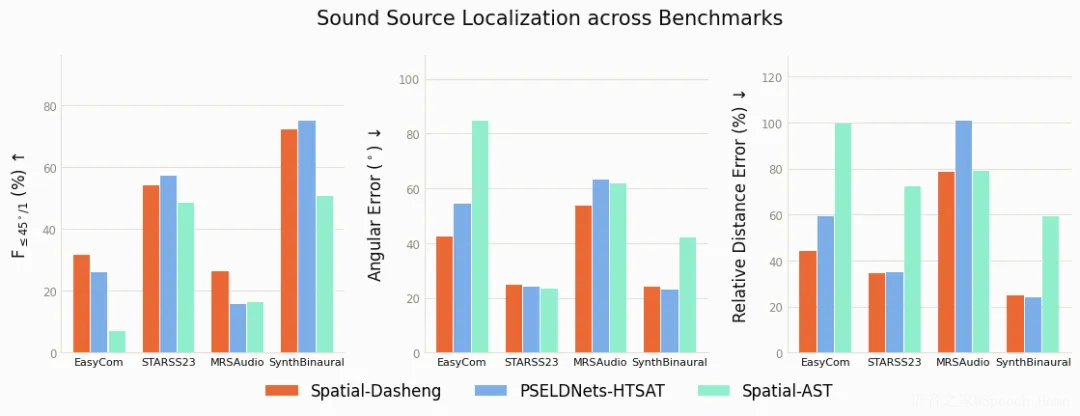
MiDashengLM-Spatial 的空间音频编码器是其空间感知与理解能力的核心。在真实场景声源定位数据集上,该空间音频编码器展现出优异的定位性能,并超越多种专业空间声源定位模型。
▍通用理解:与基座持平,部分基准更优
MiDashengLM-Spatial 在音频问答、语音识别和音频描述等基础音频理解任务上的表现与 MiDashengLM 基本持平,并在部分基准测试中取得更优成绩。
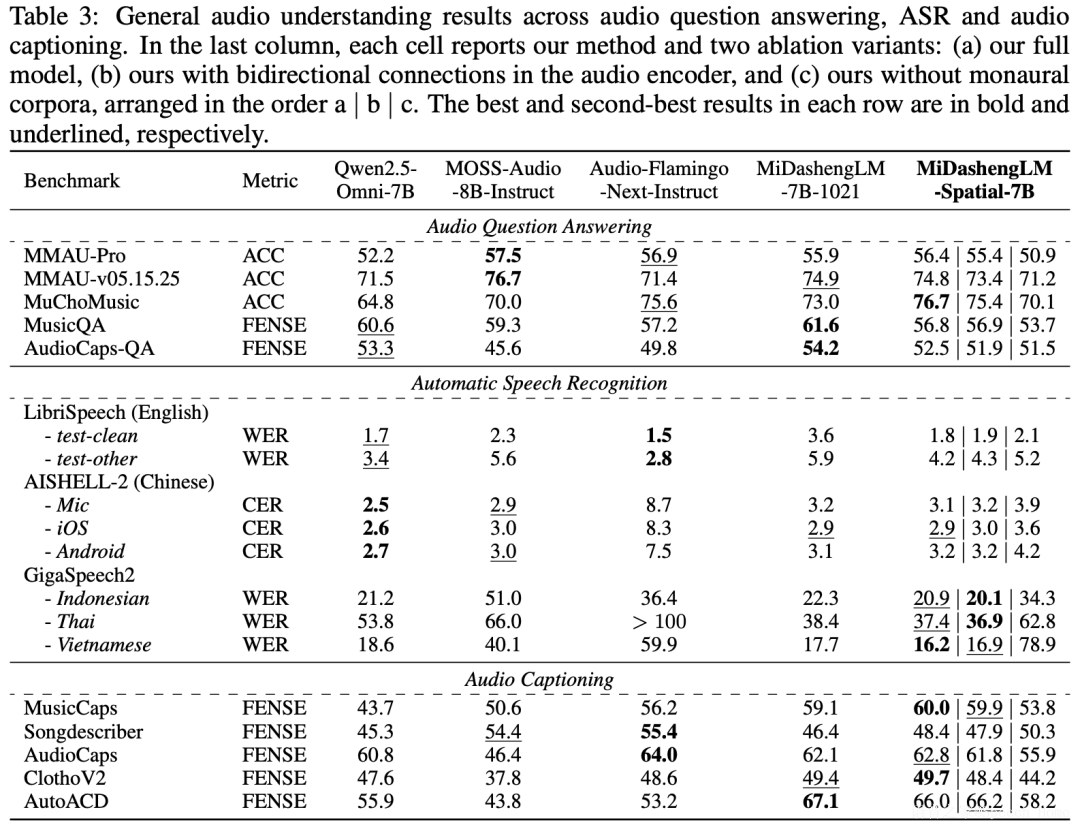
这一优势得益于其双分支音频编码器架构。该架构在模型结构上解耦音频的语义信息与空间信息,在拓展空间理解能力的同时,保持了原有基础的音频理解性能。
全面开源
小米拥有丰富而多元的硬件生态,产品在真实物理空间中与用户持续交互,因此不仅需要“听见”声音,更需要感知并理解声音所处的空间。
MiDashengLM-Spatial 已正式开源。并以 Apache 2.0 许可证发布,欢迎开发者、行业伙伴和学术机构将其免费用于商业产品集成或学术研究。
